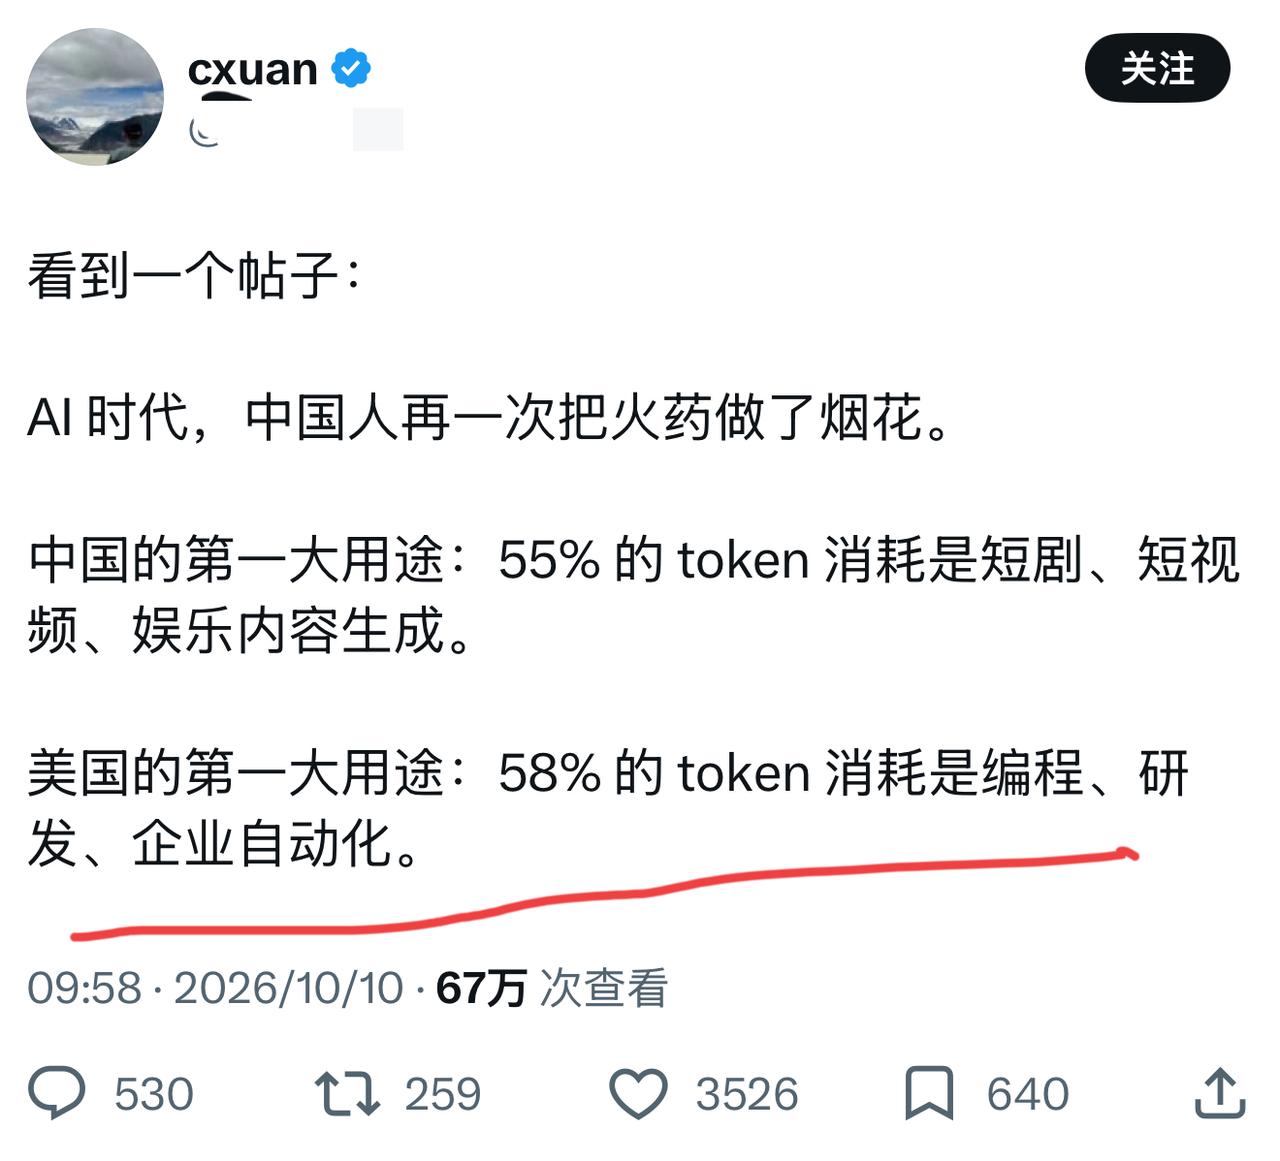
别急着踩中捧美!网传“中国55%的AI算力在做短剧,美国58%的AI算力在做代码”,这话一出,不少人立马套上“夏令营中的较量”叙事。认真查证后判断:它可能半真,但必定半假。
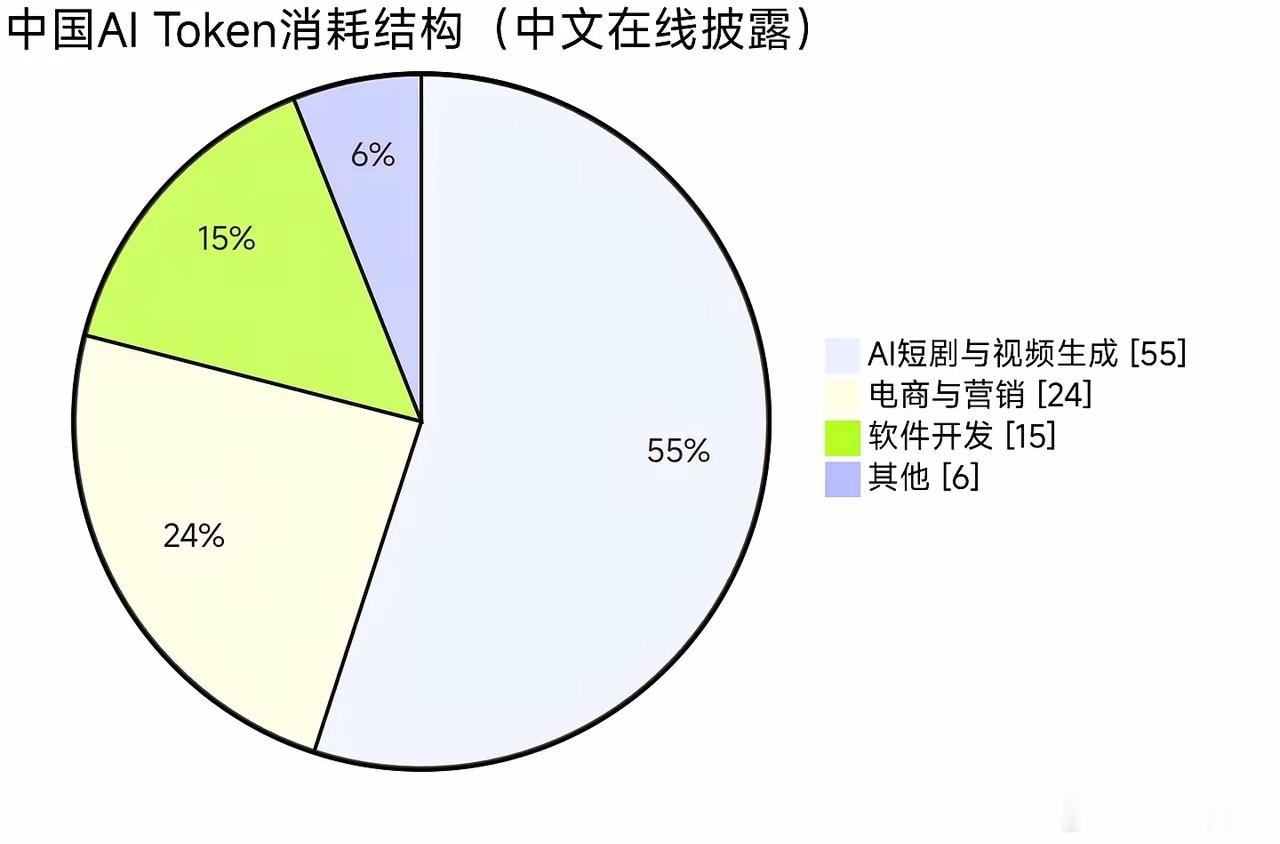
先扒这两个数字的底,根本就不是一个口径。国内 55% 的说法,出自中文在线对国内公有 API Token 消耗的统计,算的是面向中小客户和 C 端用户的云端接口调用结构,短剧、电商素材这些轻量化消费场景占了大头。
而美国 58% 的数字,来自风投机构对企业级生成式 AI 支出的拆分,算的是美国企业付费买 API 的用途分布。
一个是 C 端为主的公有云 Token 消费占比,一个是 B 端为主的企业付费支出占比,分母完全不是一回事。
这就好比拿中国奶茶店的饮品销量占比,去比美国公司的办公用品采购占比,看似都是消费,根本就不是一个统计维度,硬凑在一起对比,从根上就站不住脚。
更关键的是,这两个数字说的都是 “公有 API”,根本代表不了两国 AI 算力的全貌。
在中国,真正的算力大头从来都不在公有 API 市场里。
大模型预训练、超算科研、工业仿真这些硬核场景,全是企业和机构自建私有算力集群,自己的卡自己用,根本不对外售卖 Token,自然也不会出现在公有 API 的统计账本里。
工信部的数据摆在这里:截至今年 6 月底,国内智能算力总规模达到 2185EFLOPS,其中超过六成用在了大模型训练、工业智能体和科学计算领域。
曙光 8000 十万卡级超算集群,支撑着蛋白质折叠、新材料研发、量子计算等 20 多个科研方向;全国 47.2% 的制造企业已经在试点智能体应用,工厂里的质检仿真、排产优化、设备运维,每天都在消耗天量算力。
这些算力既不生成豪门赘婿,也不产出带货脚本,大众看不见,不代表它不存在。
再看美国那边的 58%,水分同样不小。这笔账算的是美国 API 平台的收入结构,可烧这些 Token 的人,不全是美国企业。
GitHub 的统计早就说明白了,全球 AI 生成的代码里,美国开发者只贡献了三成左右,剩下的七成来自全球各地,其中就包括大量中国程序员。
很多中国公司的软件开发、项目迭代,用的是美国的大模型 API,Token 消耗记在了美国平台的账上,活却是给中国的项目干的。
把全球开发者的使用量,全算成 “美国算力搞研发” 的功劳,这账算得未免太笼统。
而且美国也不是没有娱乐算力。好莱坞的 AI 影视特效、3A 游戏的 AI 内容生成、社交平台的短视频推荐,消耗的算力规模一点都不小。
只是没人刻意把这些场景单独拎出来,去和科研算力做个高低对比,更没人由此得出 “美国 AI 沉迷娱乐” 的结论。
说到底,这是两条不同的产业路径,没有高下之分,只有禀赋之别。
中国有全球最大的消费互联网市场,短剧、电商这些内容场景商业化最快,能最快跑通算力的商业闭环。
公有 API 先靠内容变现活下来,带动算力基建、国产芯片、大模型技术快速迭代,再反过来往工业、科研领域渗透。
这是一条从消费端起步、自下而上的路径,务实,也高效。
美国则是另一条路:企业数字化起步早,B 端付费能力强,大模型公司先靠代码工具、企业智能体拿到了稳定的企业收入,再往 C 端内容场景延伸。
两条路只是起点不同,一个先赚流量的钱,一个先赚企业的钱,不存在谁更高级、谁更有未来的定论。
很多人没看到的是,中国算力的流向正在快速变化。规模以上制造业企业 AI 普及率已经突破 30%,工业仿真、智能研发、生产运维这些场景的算力增速,已经超过了内容创作领域。
公有云的短剧热闹只是水面上的浪花,水面之下,工业和科研算力的大潮已经在涌上来。
说白了,这个传言的本质,就是用两个口径完全不同的数字,拼接出了一个 “中国玩物丧志、美国深耕科技” 的刻板叙事,靠偷换概念制造焦虑。
算力从来没有什么 “正确用途”,能跑通商业循环、能带动产业升级、能沉淀核心技术的,就是有价值的算力。
靠内容场景养大算力产业,再用算力去啃工业和科研的硬骨头,这不是浪费,是最符合中国产业现状的务实选择。