用AI 修bug 捷径Step1:学会调用“既往病史”
今天上午,我盯着一个被裁掉半截的下拉菜单,陷入了一种每个 vibe coder 都懂的憋屈:
这个 bug,我明明修过。准确地说,是上一个 AI agent 修过。当时乍一看正常,测试全绿,代码提交,皆大欢喜。结果几天之后分组一多、列表一滚动,它又回来了。
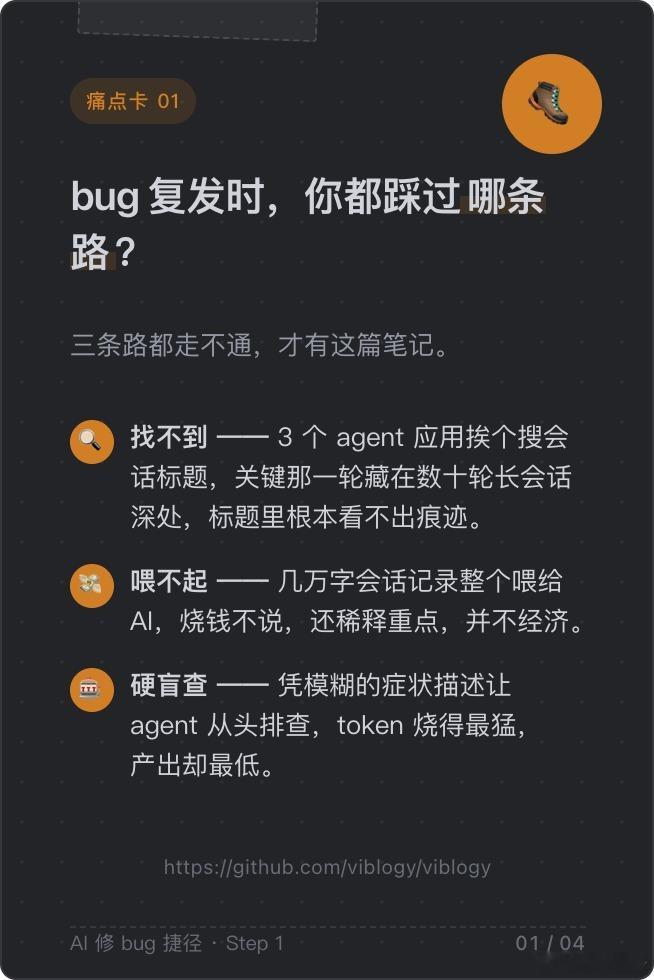
我需要给新 agent 讲清楚「上次到底发生了什么」。但按常规的路子走,光是这一步就足以把人劝退。我得先回忆:这 bug 大概是什么时候修的?然后打开常用的三个 coding-agent 应用,挨个检索可能的会话标题。问题是,关键那一轮大概率藏在某场数十轮的长会话深处,标题里根本看不出痕迹。
那就只能手动爬楼,一层一层翻。往往楼还没爬完,人先力竭了。就算运气好,抢在耐心耗尽之前真找到了那一轮,新问题又来了:几万字的会话记录整个喂给 AI,烧钱不说,还稀释重点,并不经济。
所以多数时候,我会干脆放弃找档案,改走另一条路:让 agent 凭着我嘴里那点模糊的症状描述,从头排查根因。偏偏这条路 token 烧得最猛,建设性产出却最低。你还不敢中途喊停——生怕是「药量没给够」,再烧一轮就能见效。
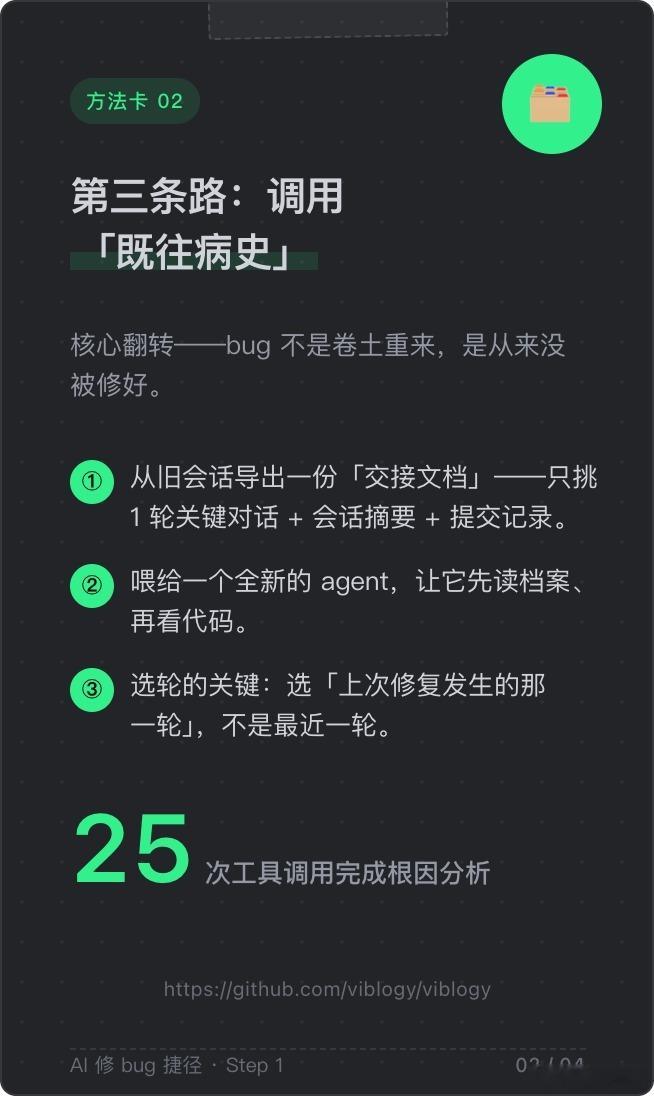
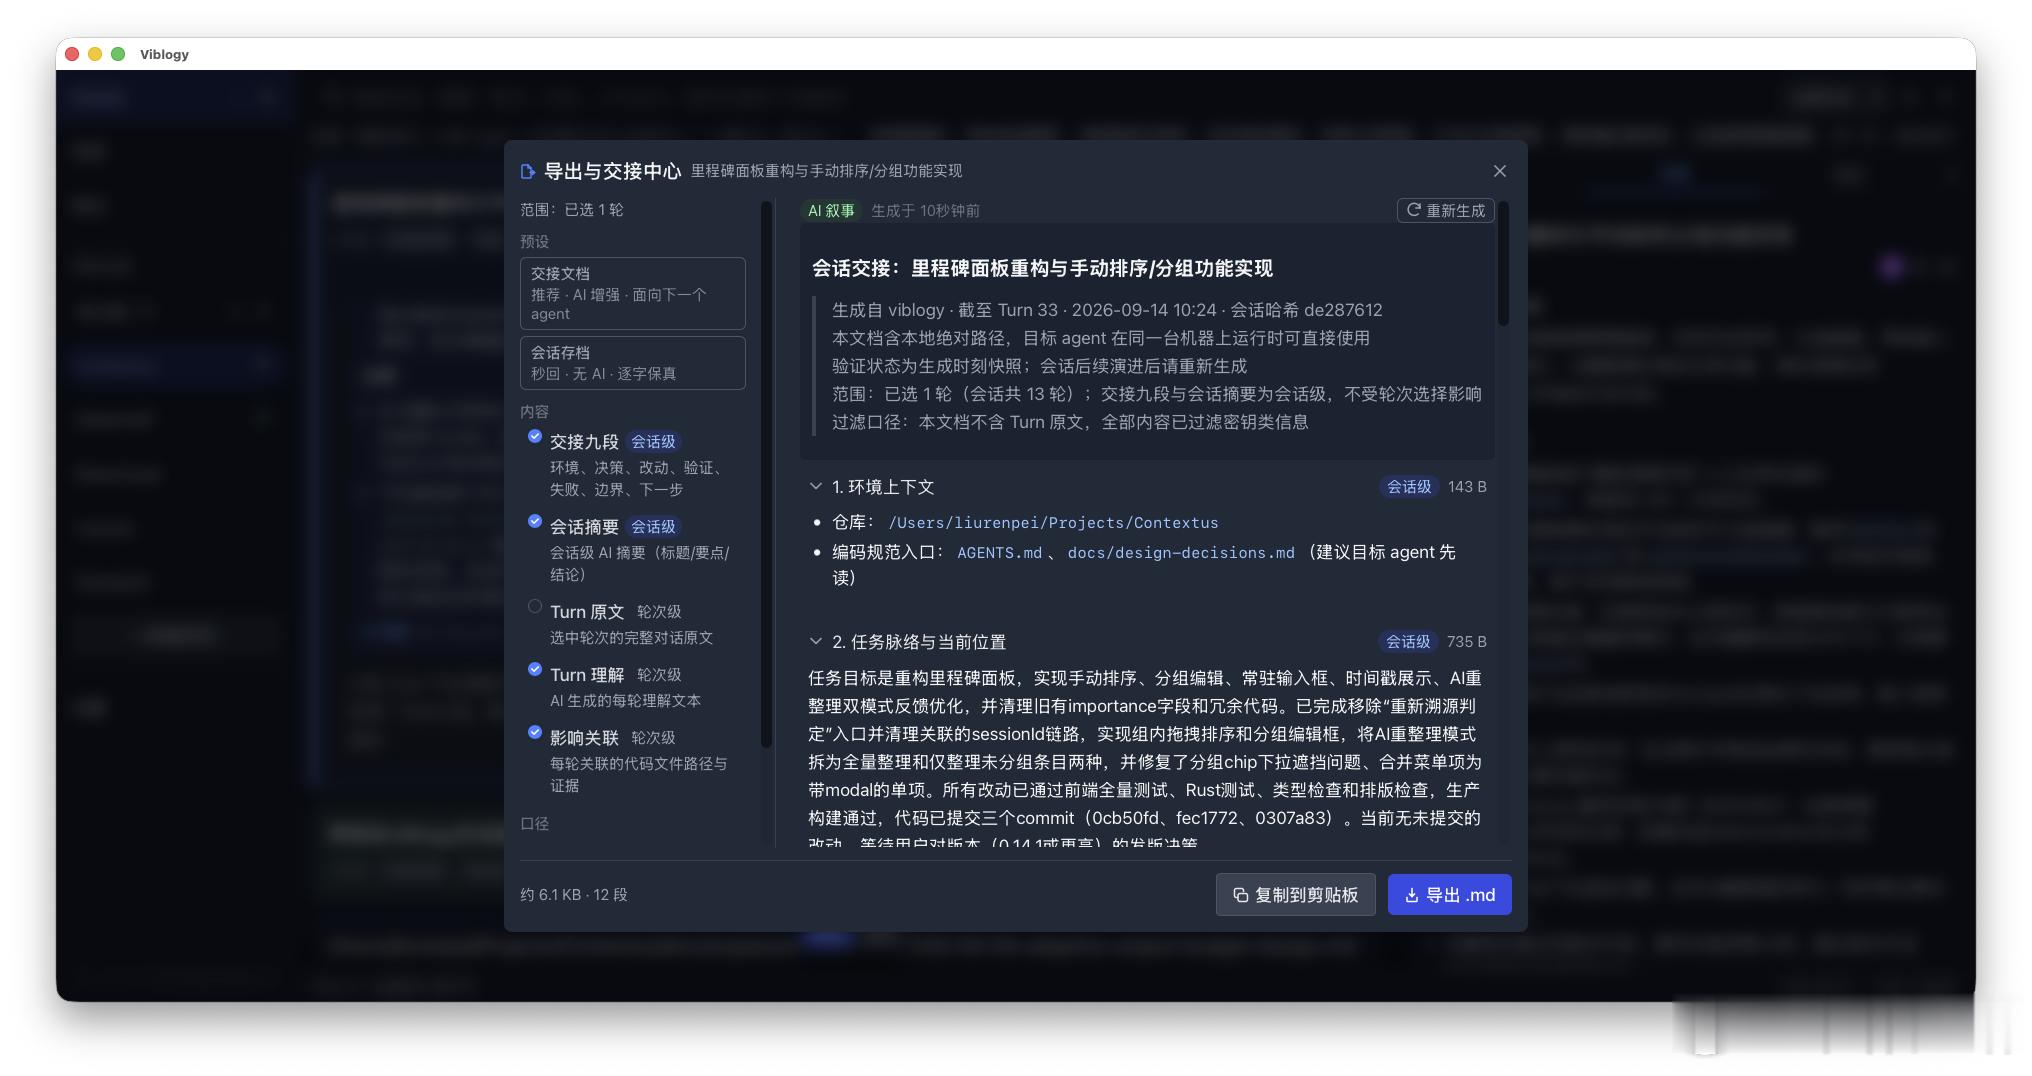
而现在我多了一条捷径:用自己做的工具 viblogy,从旧会话里导出一份「交接文档」——只挑了其中 1 轮关键对话,连同会话摘要、提交记录一起,喂给了一个全新的 agent。
之后发生的事,超出了我的预期。新 agent 只用了 25 次工具调用就完成了根因分析。而它推翻的第一件事,就是我的预设:这个 bug 不是「卷土重来」,是从来没被修好过。
这份上下文到底帮了什么忙
事后我复盘了 agent 的全部排查动作,把交接文档的贡献拆成三层,重要性递减。
第一层,纠正破案方向。 我给的原始任务描述是「当时有效果,不知为何卷土重来」——这是个「回归」框架,暗含的排查动作是「找出修复之后谁改坏了它」。没有文档,agent 大概率顺着这个方向做代码考古,而那个方向上空空如也,走到死胡同才能掉头。文档里机制级的修复记录,让它第一眼就看出「上次修的不是这个症状」。
第二层,提交编号成了破案锚点。 三个 commit 哈希让 git 考古变成精确制导:一条命令证明「修复后无人动过组件」,一条命令锁定「滚动容器与下拉同天出生」。没有这些编号,agent 得翻遍文件历史、逐个读 diff 反推上次修复的意图——慢,而且靠猜。
第三层,精确的写法串让「同类隐患大扫除」变成机械操作。 文档里 fixed inset-0 这个遮罩写法是可以直接全局搜索的模式串。最终,这套写法在整个仓库被清零,另外两处同款菜单一并迁移到了新方案。
粗略量化:文档把根因判定的成本压缩了约一半,把「误诊为回归」的概率从相当高降到接近零。
你可能觉得:不就是给 agent 多喂了点上下文吗?是,但关键在「喂的是什么」。这份文档真正值钱的不是「修过什么」的结论,而是「怎么修的」的机制——精确到每一个 CSS 类名和定位策略。
这让我意识到,给 agent 的上下文也分三六九等:记「结论」的是流水账,记「机制」的才是真正可以反复调用的「既往病史」。人工智能vibecoding程序员