智谱 AI 刚刚在法律大模型赛道丢下了一颗重磅炸弹。
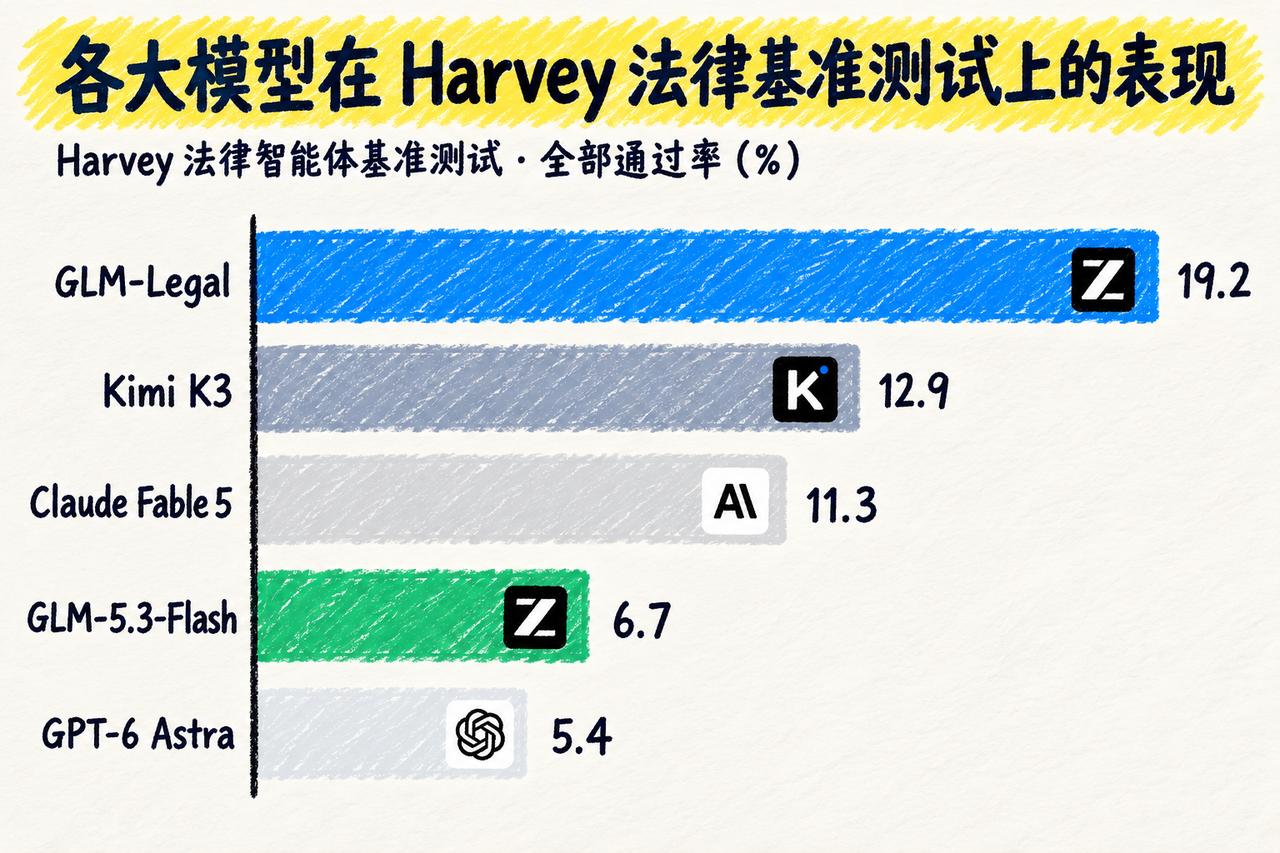
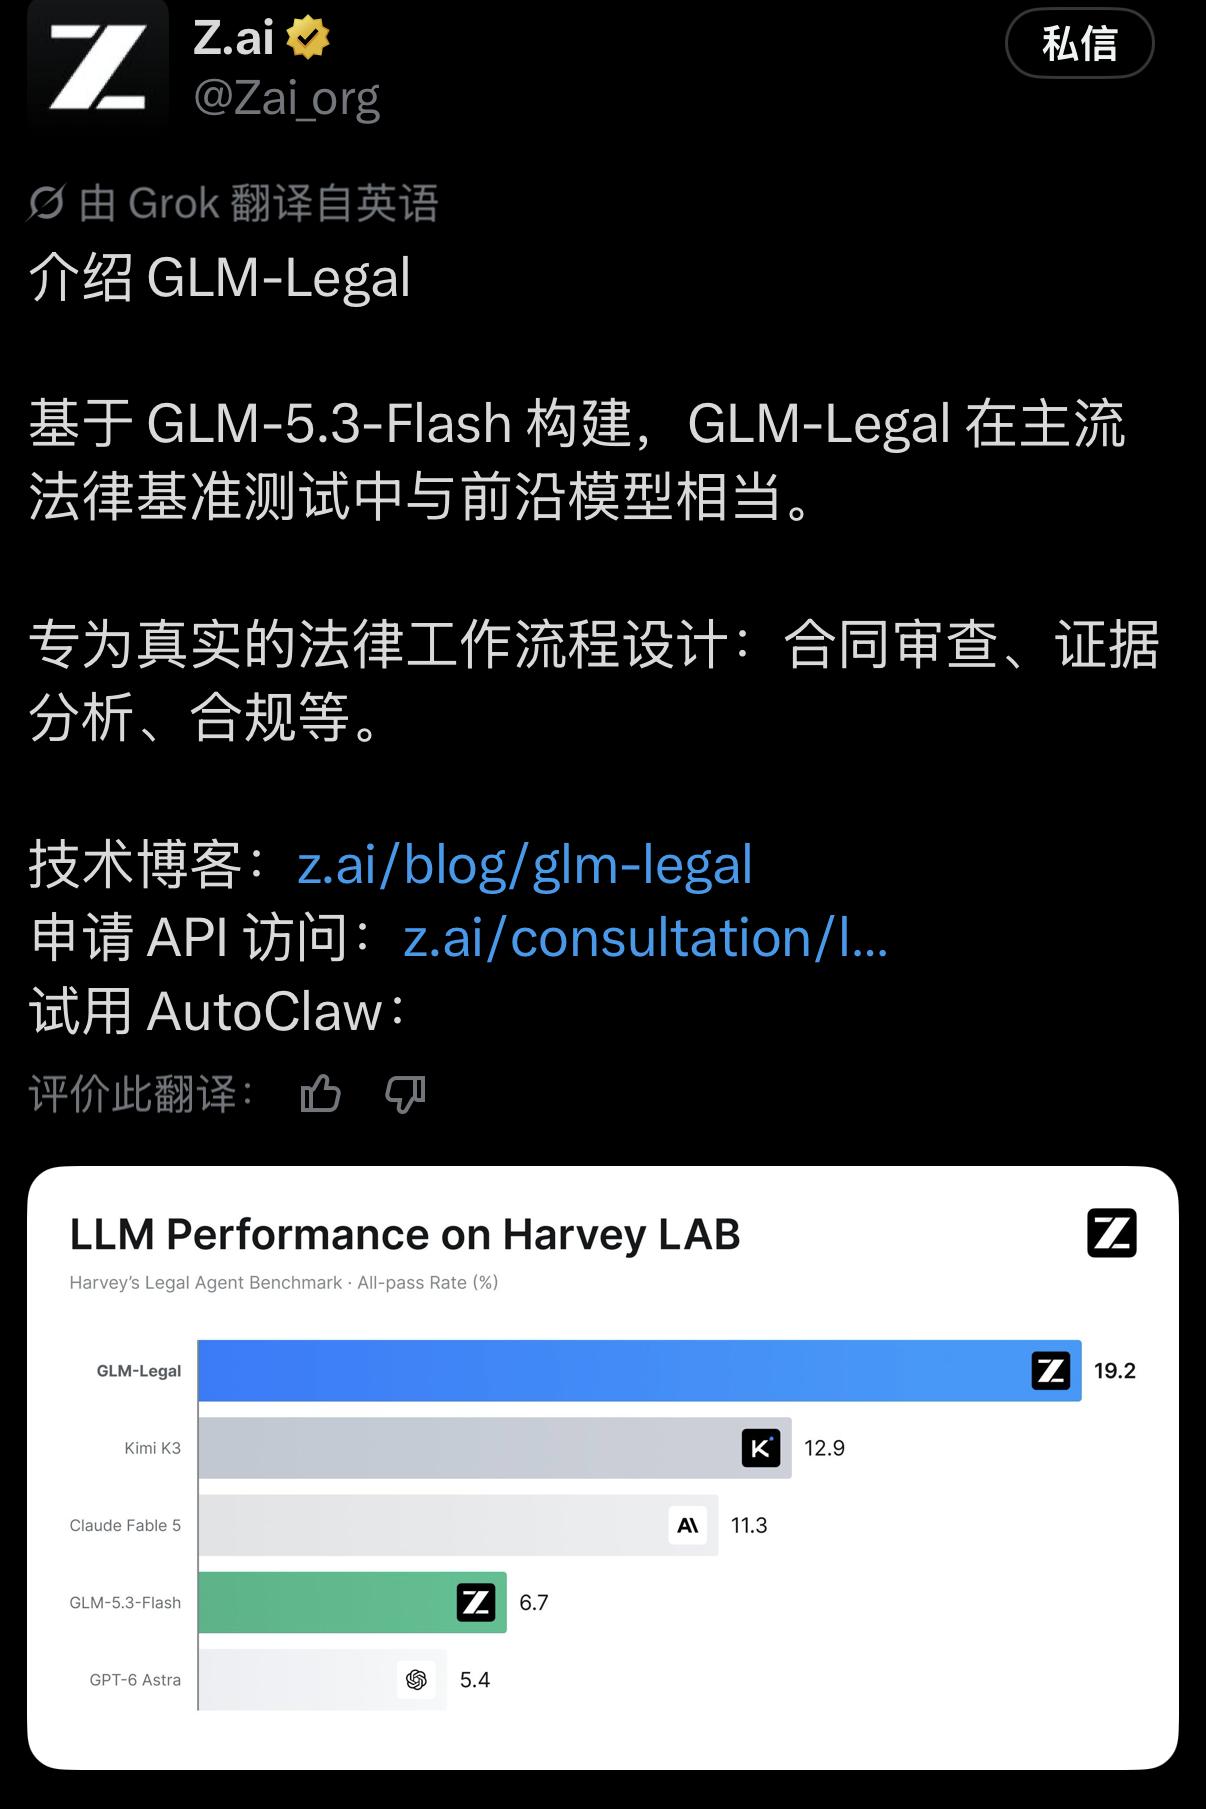
在最新公布的权威法律 Agent 评测 Harvey LAB 中,智谱基于 GLM-5.3-Flash 打造的垂直模型 GLM-Legal,直接飙出了 19.2% 的全通过率,一举将 Kimi K3(12.9%)、Claude Fable 5(11.3%)甩在身后,甚至连基座只有 5.4% 的 GPT-6 Astra 也被远远甩开。
光看这张战报,智谱这波可以说是狠狠给国产垂类 AI 提了一口气。但如果你把数据拉开仔细品品,就会发现这里面藏着不少极具讽刺意味又发人深省的行业真相。
第一,通用大模型的“暴力美学”,在专业领域正式踢到了铁板。
你看基座模型 GLM-5.3-Flash 本身的得分只有 6.7%,GPT-6 Astra 也只有 5.4%。
可一旦给 GLM-5.3-Flash 加上法律领域的二次预训练、数万个模拟法律场景的强化学习,以及专门用来管上下文和工具调用的 Harness 运行套件,它的战力立马暴涨了近三倍。
这说明什么?
大模型竞争的下半场,纯靠堆参数、卷通用能力的时代已经过去了。
哪怕底层模型属于轻量选手,只要套上一套极其硬核的领域工程架构(Agent Scaffold),也能在特定行业里吊打高高在上的通用巨无霸。
第二,19.2% 拿了全球第一,但法律界看完可能想笑。
科技圈在欢呼“大模型通关法律圣殿”,可要是站在资深律师的角度看,100 道复杂法律任务只做对 19.2 道,这成绩要是参加司法考试,怕是连准考证都要被当场撕掉。
Harvey LAB 测的可不是查查法条这种小儿科,而是涵盖了跨国合规规划、40 份卷宗联动证据分析等变态场景。
19.2% 虽然是行业天花板,但也意味着它依然有超过 80% 的概率在瞎编或者踩坑。
所以,律师们大可不必赶着去递辞职信。
现在的 AI 根本不是什么“律政精英终结者”,它更像是一个一秒钟能为你翻完几万页合同、但隔三差五就需要你帮它擦屁股和签字盖章的极速版实习生。
第三,打工人的算盘:少谈通用情怀,多算算“单次任务成本”。 智谱这次最毒辣的策略,是没有用昂贵的旗舰模型去硬拼,而是把所有的工程花招都施加在了便宜又快速的 Flash 模型上。
对于企业和律所来说,通用旗舰模型再聪明,调用一次花费几十美金谁也顶不住;而轻量小钢炮配合定制 Harness,才能真正把“完成单次任务的成本”打下来。
当大模型从“无所不知”的通才,开始穿上西装、戴上假发卷向法律界,AI 的落地故事终于脱离了 PPT 里的虚无缥缈。
只是不知那些挑灯夜读备战法考的学子们,看到这位一秒审完 40 份合同、却依然可能把判例搞混的“AI 实习生”,心里到底是个啥滋味。