众力资讯网
小白鼠热玩科技的文章
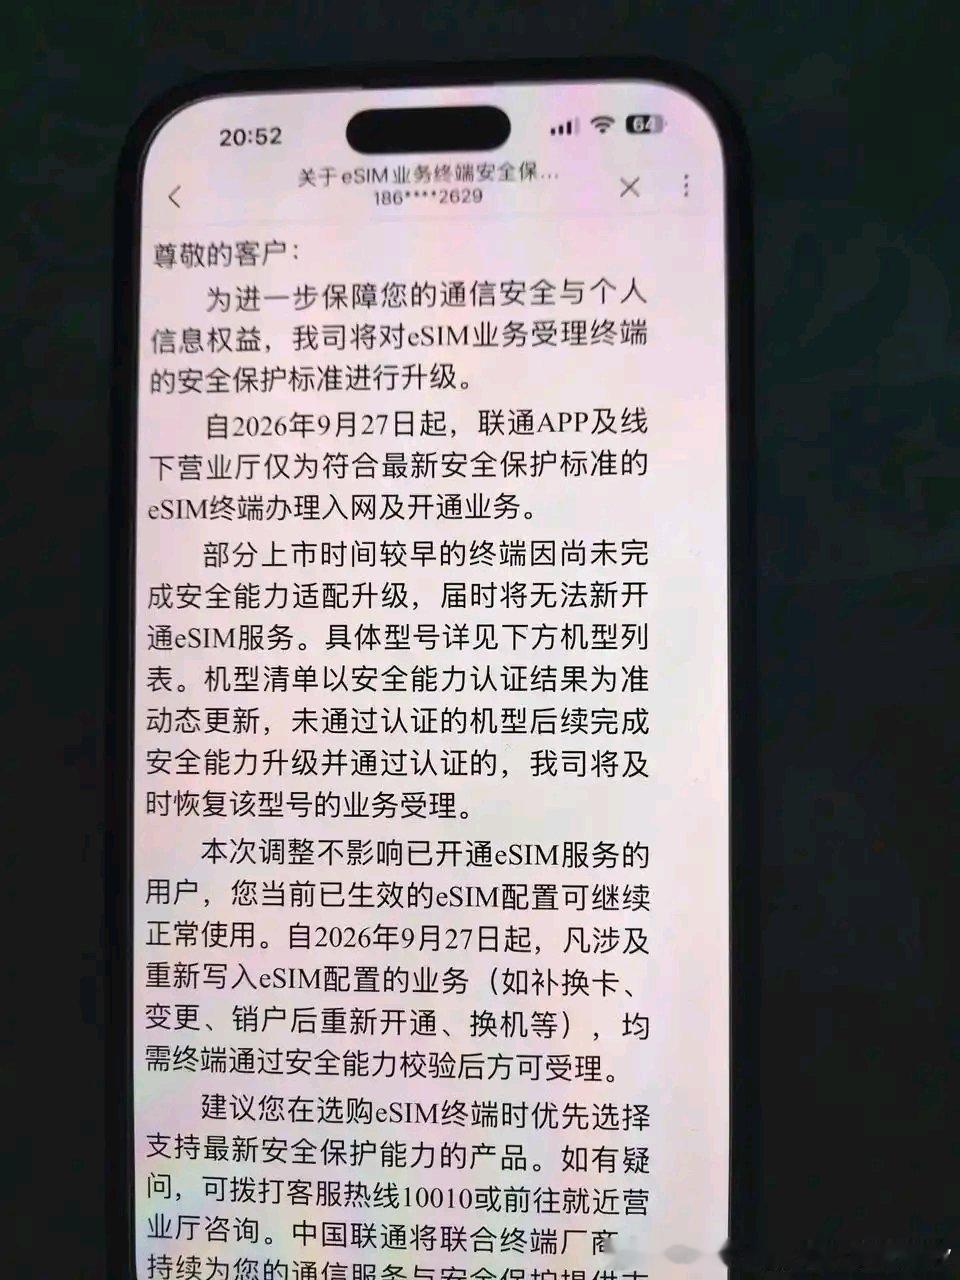
【附卡的昌盛与落寞】 听说明天以后开的附卡以后不能表卡分离了 想当年有位吧友在群里爆出阿巴町可以开附卡,很多人都在贴吧讨论上车,但是当时上车费太贵了,要300多。当时有人自己买手表,改串,自...(分享自
2026-09-29 08:34
【附卡的昌盛与落寞】 听说明天以后开的附卡以后不能表卡分离了 想当年有位吧友在群里爆出阿巴町可以开附卡,很多人都在贴吧讨论上车,但是当时上车费太贵了,要300多。当时有人自己买手表,改串,自...(分享自
【能不能简单介绍一下向日葵马戏团】 在吧里吹了好几天了,但是我对空气向萌豚轻百合没什么兴趣,就没看这部作品,但是看吧里说它并不止步于萌豚,而是有明确主线,并且有很多小巧思和伏笔回收,让我提起...(分享自
2026-09-29 08:33
【能不能简单介绍一下向日葵马戏团】 在吧里吹了好几天了,但是我对空气向萌豚轻百合没什么兴趣,就没看这部作品,但是看吧里说它并不止步于萌豚,而是有明确主线,并且有很多小巧思和伏笔回收,让我提起...(分享自
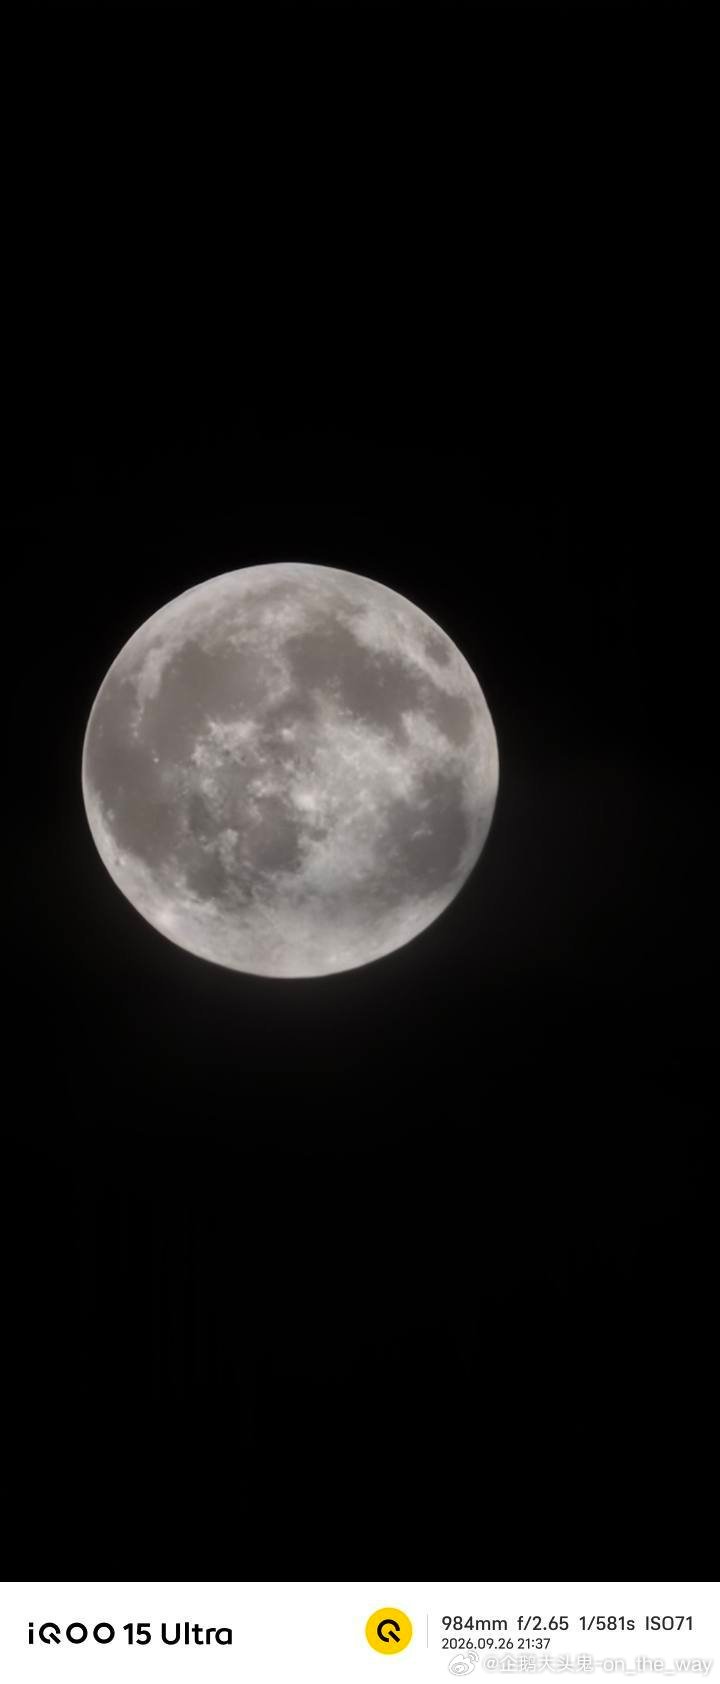
分享酷安用户的动态:看着大家都在预估iqoo16的价格,我也预估一波吧 12+256 5999 12+512 6499 16+512 7499 16+1T 7999或者8299 这次橘子7主要以12G内存为优化,所以12+512为主力机进行活动售卖。 等明天发布会看我预测的准不准[呲牙] #iQOO16发布##iQOO15Ultra##OriginOS7#
2026-09-29 08:22
分享酷安用户的动态:看着大家都在预估iqoo16的价格,我也预估一波吧 12+256 5999 12+512 6499 16+512 7499 16+1T 7999或者8299 这次橘子7主要以12G内存为优化,所以12+512为主力机进行活动售卖。 等明天发布会看我预测的准不准[呲牙] #iQOO16发布##iQOO15Ultra##OriginOS7#
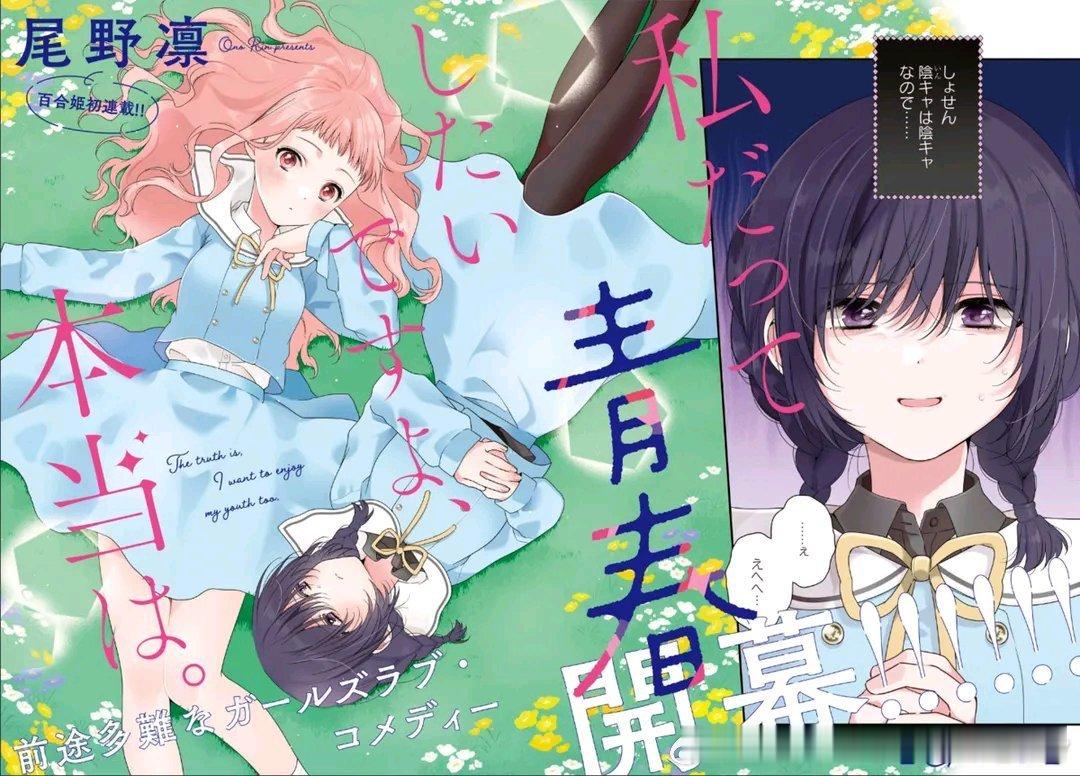
【【剧透】差一点就错过了一部好作品了】 不特色,【我也想青春一场的啊、说真的】 这部刚开篇,所以并非感言贴(也没什么能感言的),只是单纯的吐....(分享自
2026-09-29 08:33
【【剧透】差一点就错过了一部好作品了】 不特色,【我也想青春一场的啊、说真的】 这部刚开篇,所以并非感言贴(也没什么能感言的),只是单纯的吐....(分享自
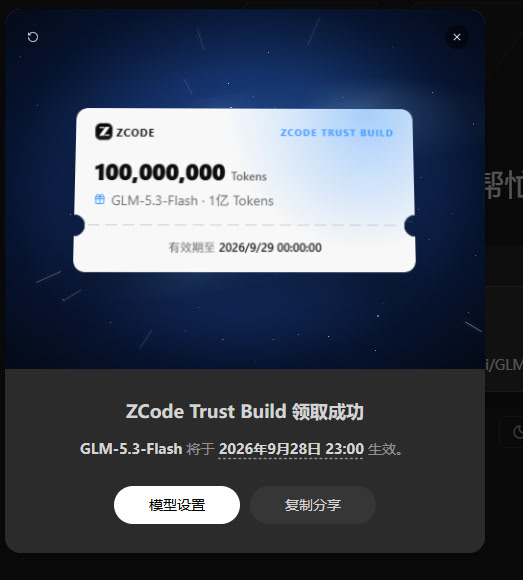
智谱ZCode给所有付费用户,只有付费用户送了重置卡,对你没看错,只有付费用户;然后所有用户送了1亿GLM-5.3-Flash的Token,但是有效期只有1个小时(9月28日23:00生效,9月29日00:00失效)。 然后免费用户只有这个1个小时有效期的1亿GLM-5.3-Flash的Token。 上传文件都上传了,但是只给付费用户补偿。
2026-09-28 20:55
智谱ZCode给所有付费用户,只有付费用户送了重置卡,对你没看错,只有付费用户;然后所有用户送了1亿GLM-5.3-Flash的Token,但是有效期只有1个小时(9月28日23:00生效,9月29日00:00失效)。 然后免费用户只有这个1个小时有效期的1亿GLM-5.3-Flash的Token。 上传文件都上传了,但是只给付费用户补偿。
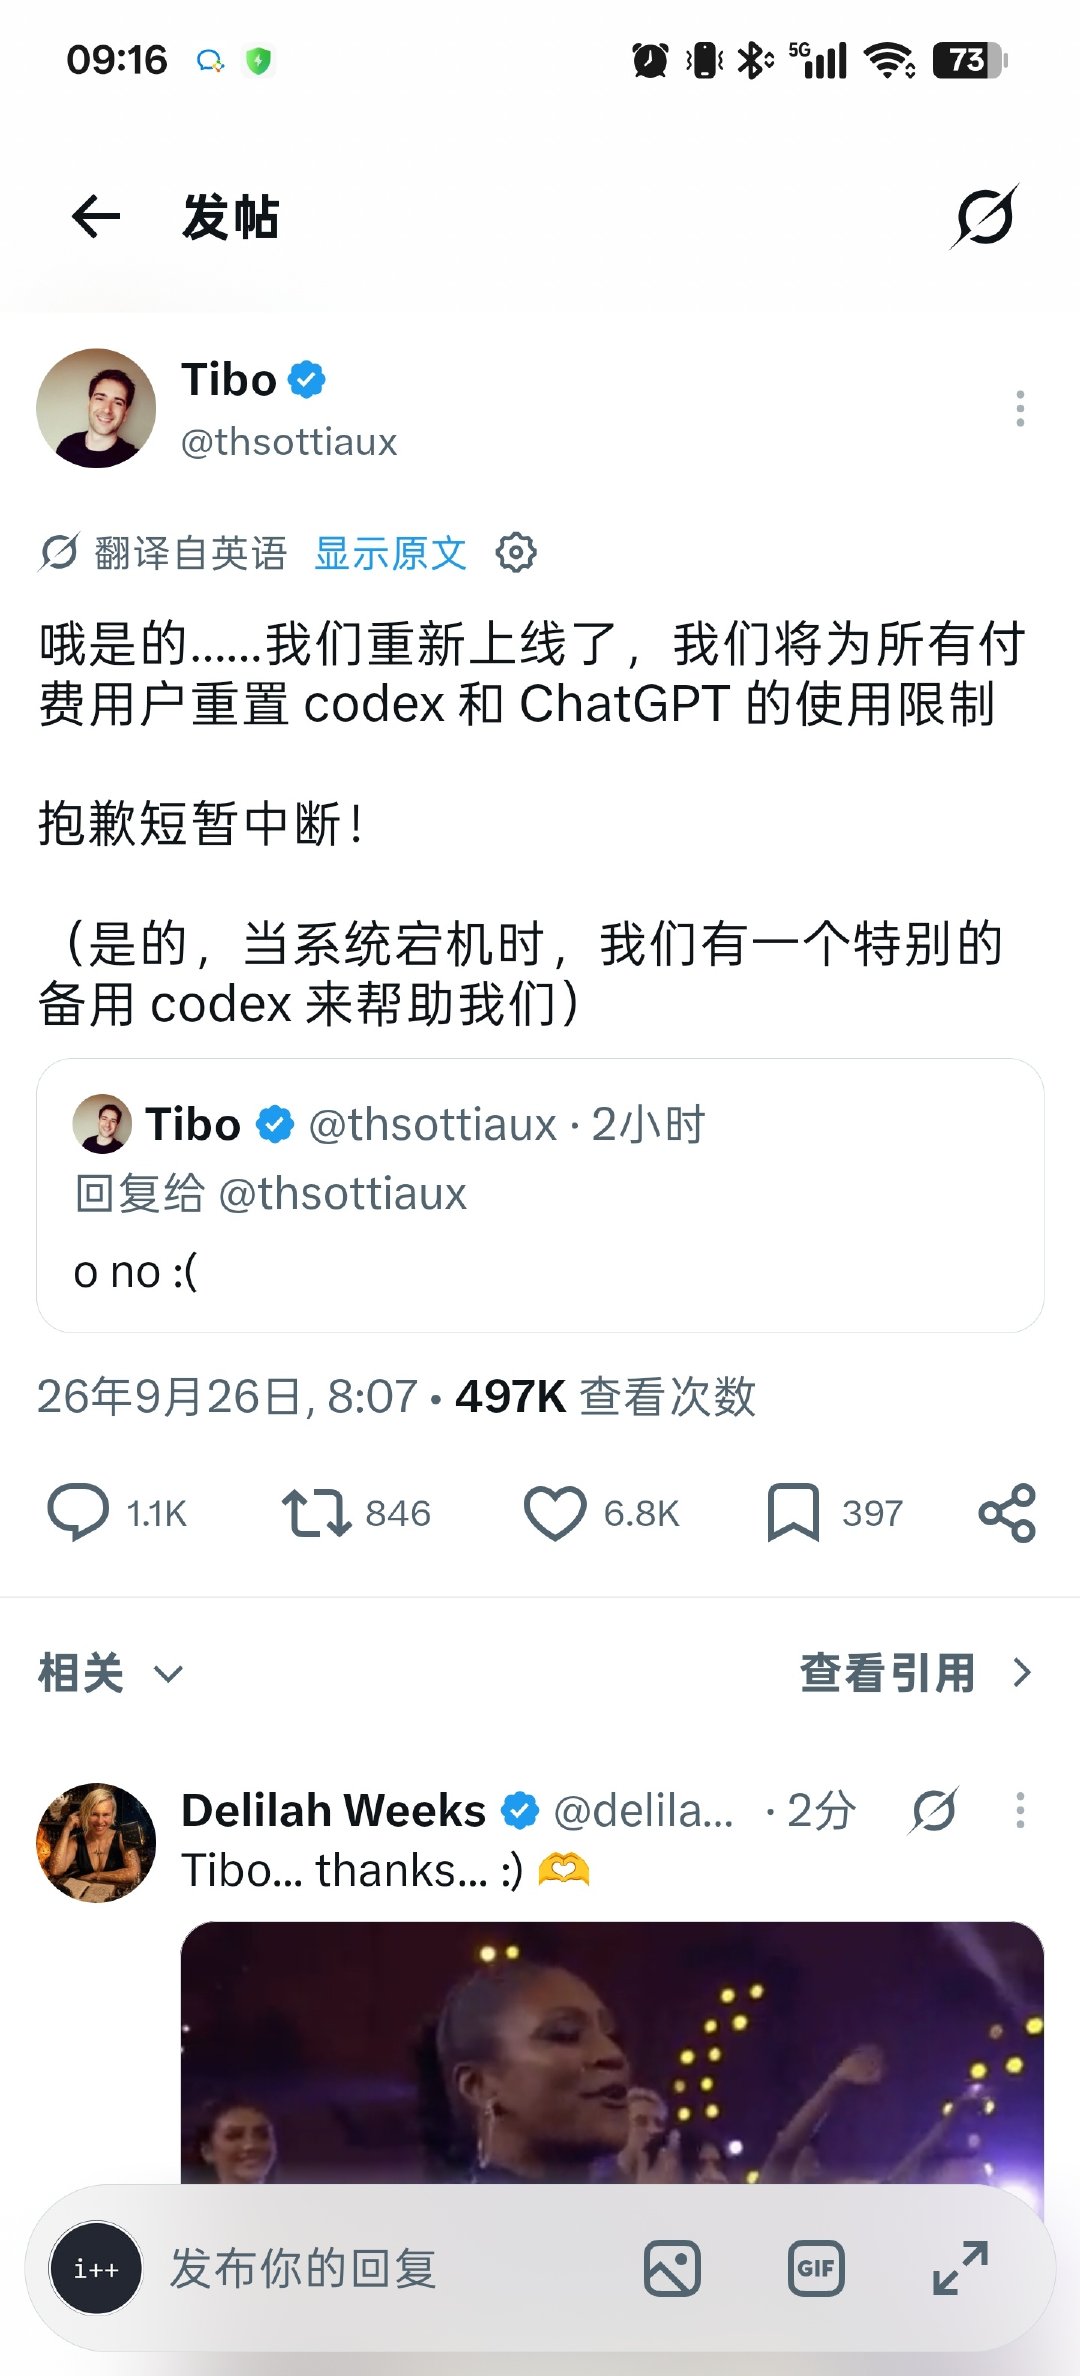
#ChatGPT[超话]# ChatGPT 和 Codex 的服务刚刚中断了(现已恢复),但是 Tibo 还是会送一次重置给大家,最难受的是刚使用重置卡的同学[允悲]
2026-09-26 14:22
#ChatGPT[超话]# ChatGPT 和 Codex 的服务刚刚中断了(现已恢复),但是 Tibo 还是会送一次重置给大家,最难受的是刚使用重置卡的同学[允悲]
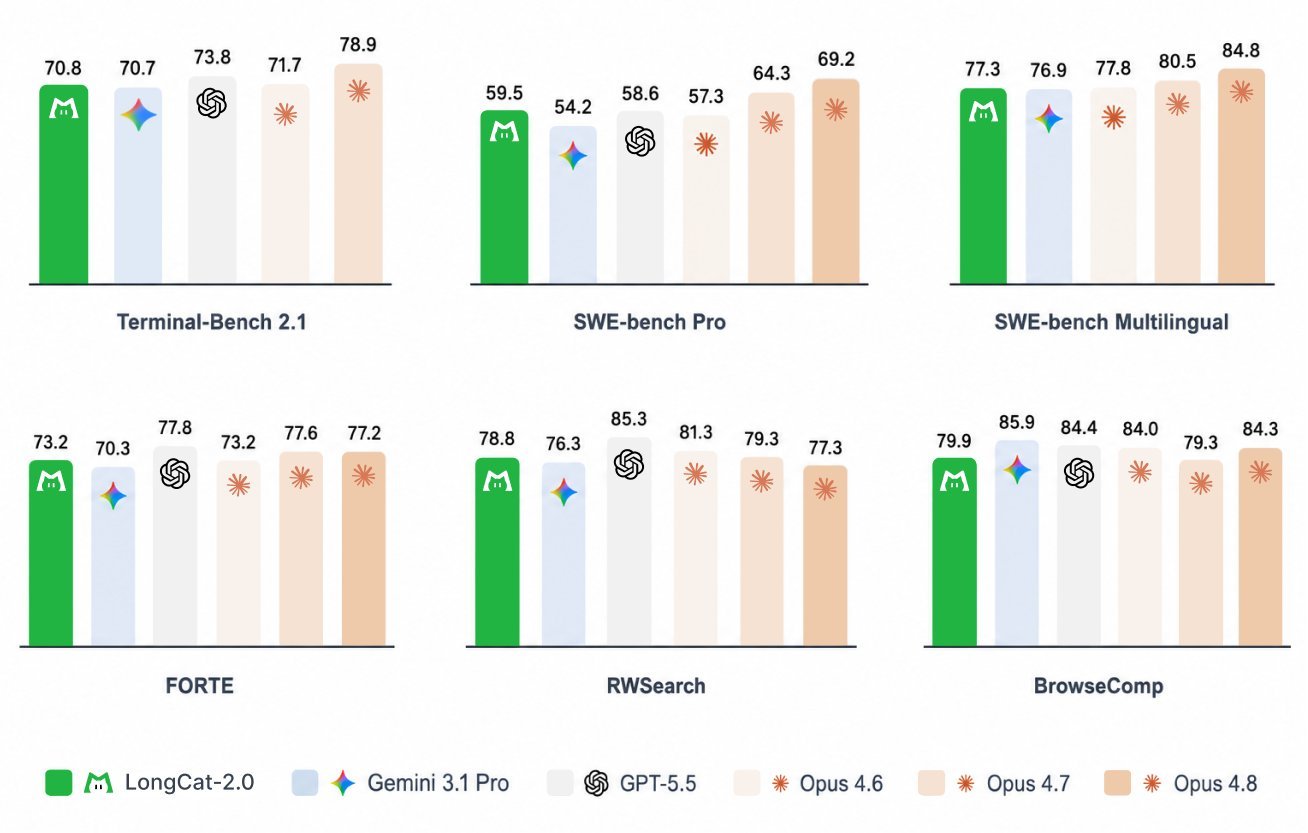
美团 LongCat 2.5 发布了,这次重点还是 Coding 和 Agent 能力。 从官方榜单看,LongCat 2.5 在几个比较关键的测试里表现都不错: - Terminal-Bench 2.1:70.8 - SWE-bench Pro:59.5 - SWE-bench Multilingual:77.3 - FORTE:73.2 - RWSearch:78.8 - BrowseComp:79.9 LongCat 2.5不是那种单纯堆参
2026-09-26 15:31
美团 LongCat 2.5 发布了,这次重点还是 Coding 和 Agent 能力。 从官方榜单看,LongCat 2.5 在几个比较关键的测试里表现都不错: - Terminal-Bench 2.1:70.8 - SWE-bench Pro:59.5 - SWE-bench Multilingual:77.3 - FORTE:73.2 - RWSearch:78.8 - BrowseComp:79.9 LongCat 2.5不是那种单纯堆参
#DeepSeek 桌面版# 有开发者在DeepSeek Harness 官方GitHub仓库中发现了桌面端源码,官方代码还明确写出了更新源 download.deepseek.com。 目前DeepSeek官网和GitHub Release 尚未正式挂出桌面版下载入口,但 Mac和Windows版本均在社区中传开,暂无Linux版本,链接与官方下载源能对应上。 Windows 版本
2026-09-26 01:03
#DeepSeek 桌面版# 有开发者在DeepSeek Harness 官方GitHub仓库中发现了桌面端源码,官方代码还明确写出了更新源 download.deepseek.com。 目前DeepSeek官网和GitHub Release 尚未正式挂出桌面版下载入口,但 Mac和Windows版本均在社区中传开,暂无Linux版本,链接与官方下载源能对应上。 Windows 版本
#Anthropic将放慢AI研发# 他就那么一说,你就那么一听,AI研发是不可能放缓的,现在还是在快速发展迭代的过程中,你慢下来就会被别人追上。 现在AI还没有特别深的护城河,只要给点时间大家就会赶上来了。到时候价格比你便宜,你的用户会被瞬间抢走,现在用户对于大模型还没有形成依赖,谁家便宜,谁家
2026-09-24 21:13
#Anthropic将放慢AI研发# 他就那么一说,你就那么一听,AI研发是不可能放缓的,现在还是在快速发展迭代的过程中,你慢下来就会被别人追上。 现在AI还没有特别深的护城河,只要给点时间大家就会赶上来了。到时候价格比你便宜,你的用户会被瞬间抢走,现在用户对于大模型还没有形成依赖,谁家便宜,谁家
#腾讯龙虾宣布停运# 龙虾热基本宣布凉凉,未来肯定就是workbuddy,Codex,Grok bot这种桌面Agent了,龙虾的门槛什么的还是太高了不适合普通用户。
2026-09-24 13:56
#腾讯龙虾宣布停运# 龙虾热基本宣布凉凉,未来肯定就是workbuddy,Codex,Grok bot这种桌面Agent了,龙虾的门槛什么的还是太高了不适合普通用户。
#豆包员工感慨豆包成边缘产品#天胡开局,不提升自己的大模型的能力,哪怕是接入一个强的大模型也好,非得死磕自己的大模型,跟人家差距越来越远,而且人家瞄准桌面Agent,搞生态,你在干啥?有飞书这么好的载体为啥不好好利用起来? 落后就要挨打,加油吧
2026-09-24 10:22
#豆包员工感慨豆包成边缘产品#天胡开局,不提升自己的大模型的能力,哪怕是接入一个强的大模型也好,非得死磕自己的大模型,跟人家差距越来越远,而且人家瞄准桌面Agent,搞生态,你在干啥?有飞书这么好的载体为啥不好好利用起来? 落后就要挨打,加油吧
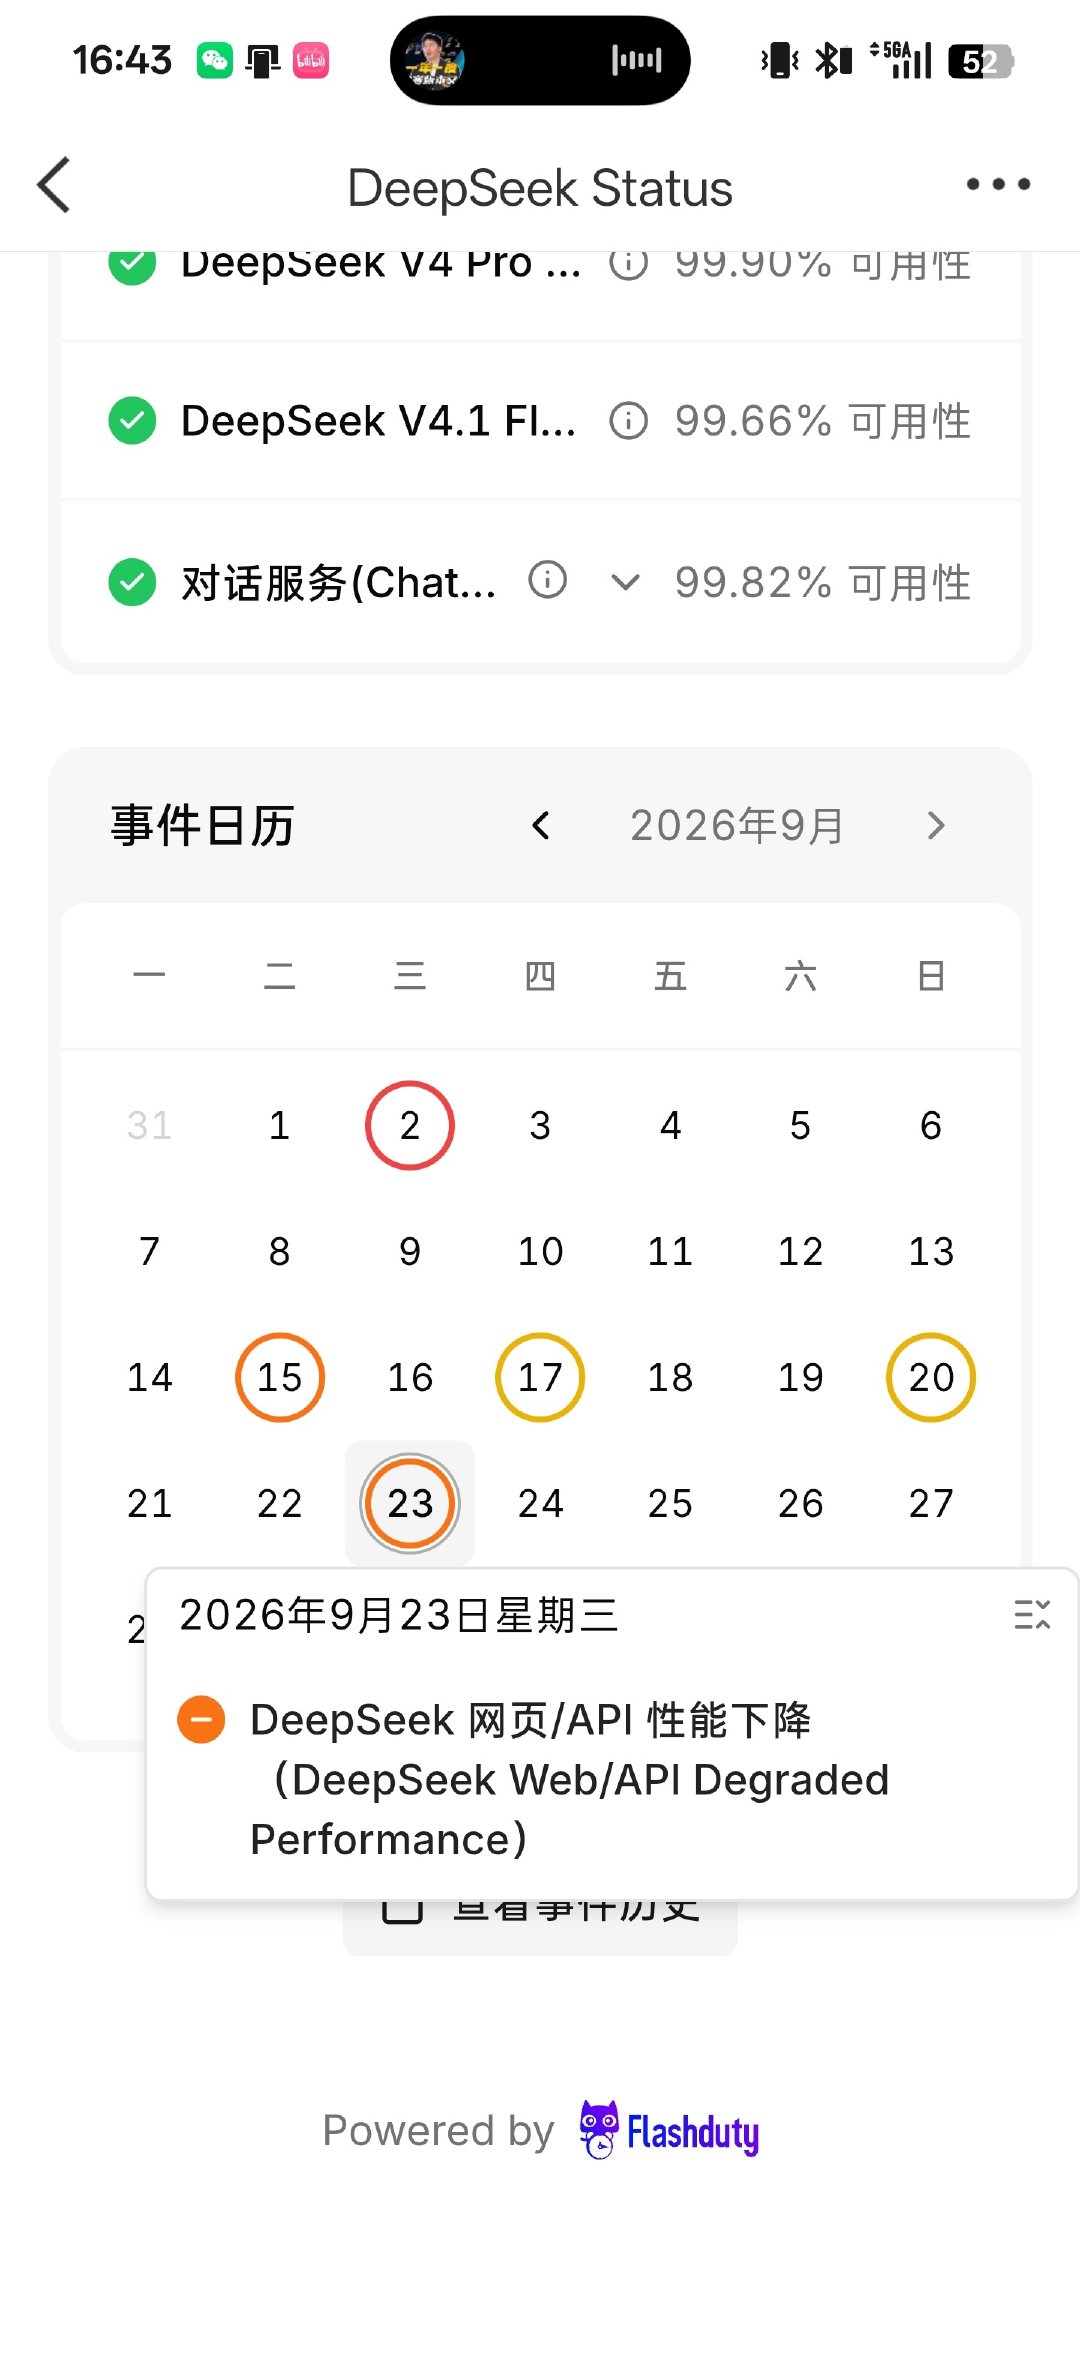
#DeepSeek崩了# 这三天两头就崩一次,现在已经恢复了 #DeepSeek[超话]#
2026-09-23 19:05
#DeepSeek崩了# 这三天两头就崩一次,现在已经恢复了 #DeepSeek[超话]#
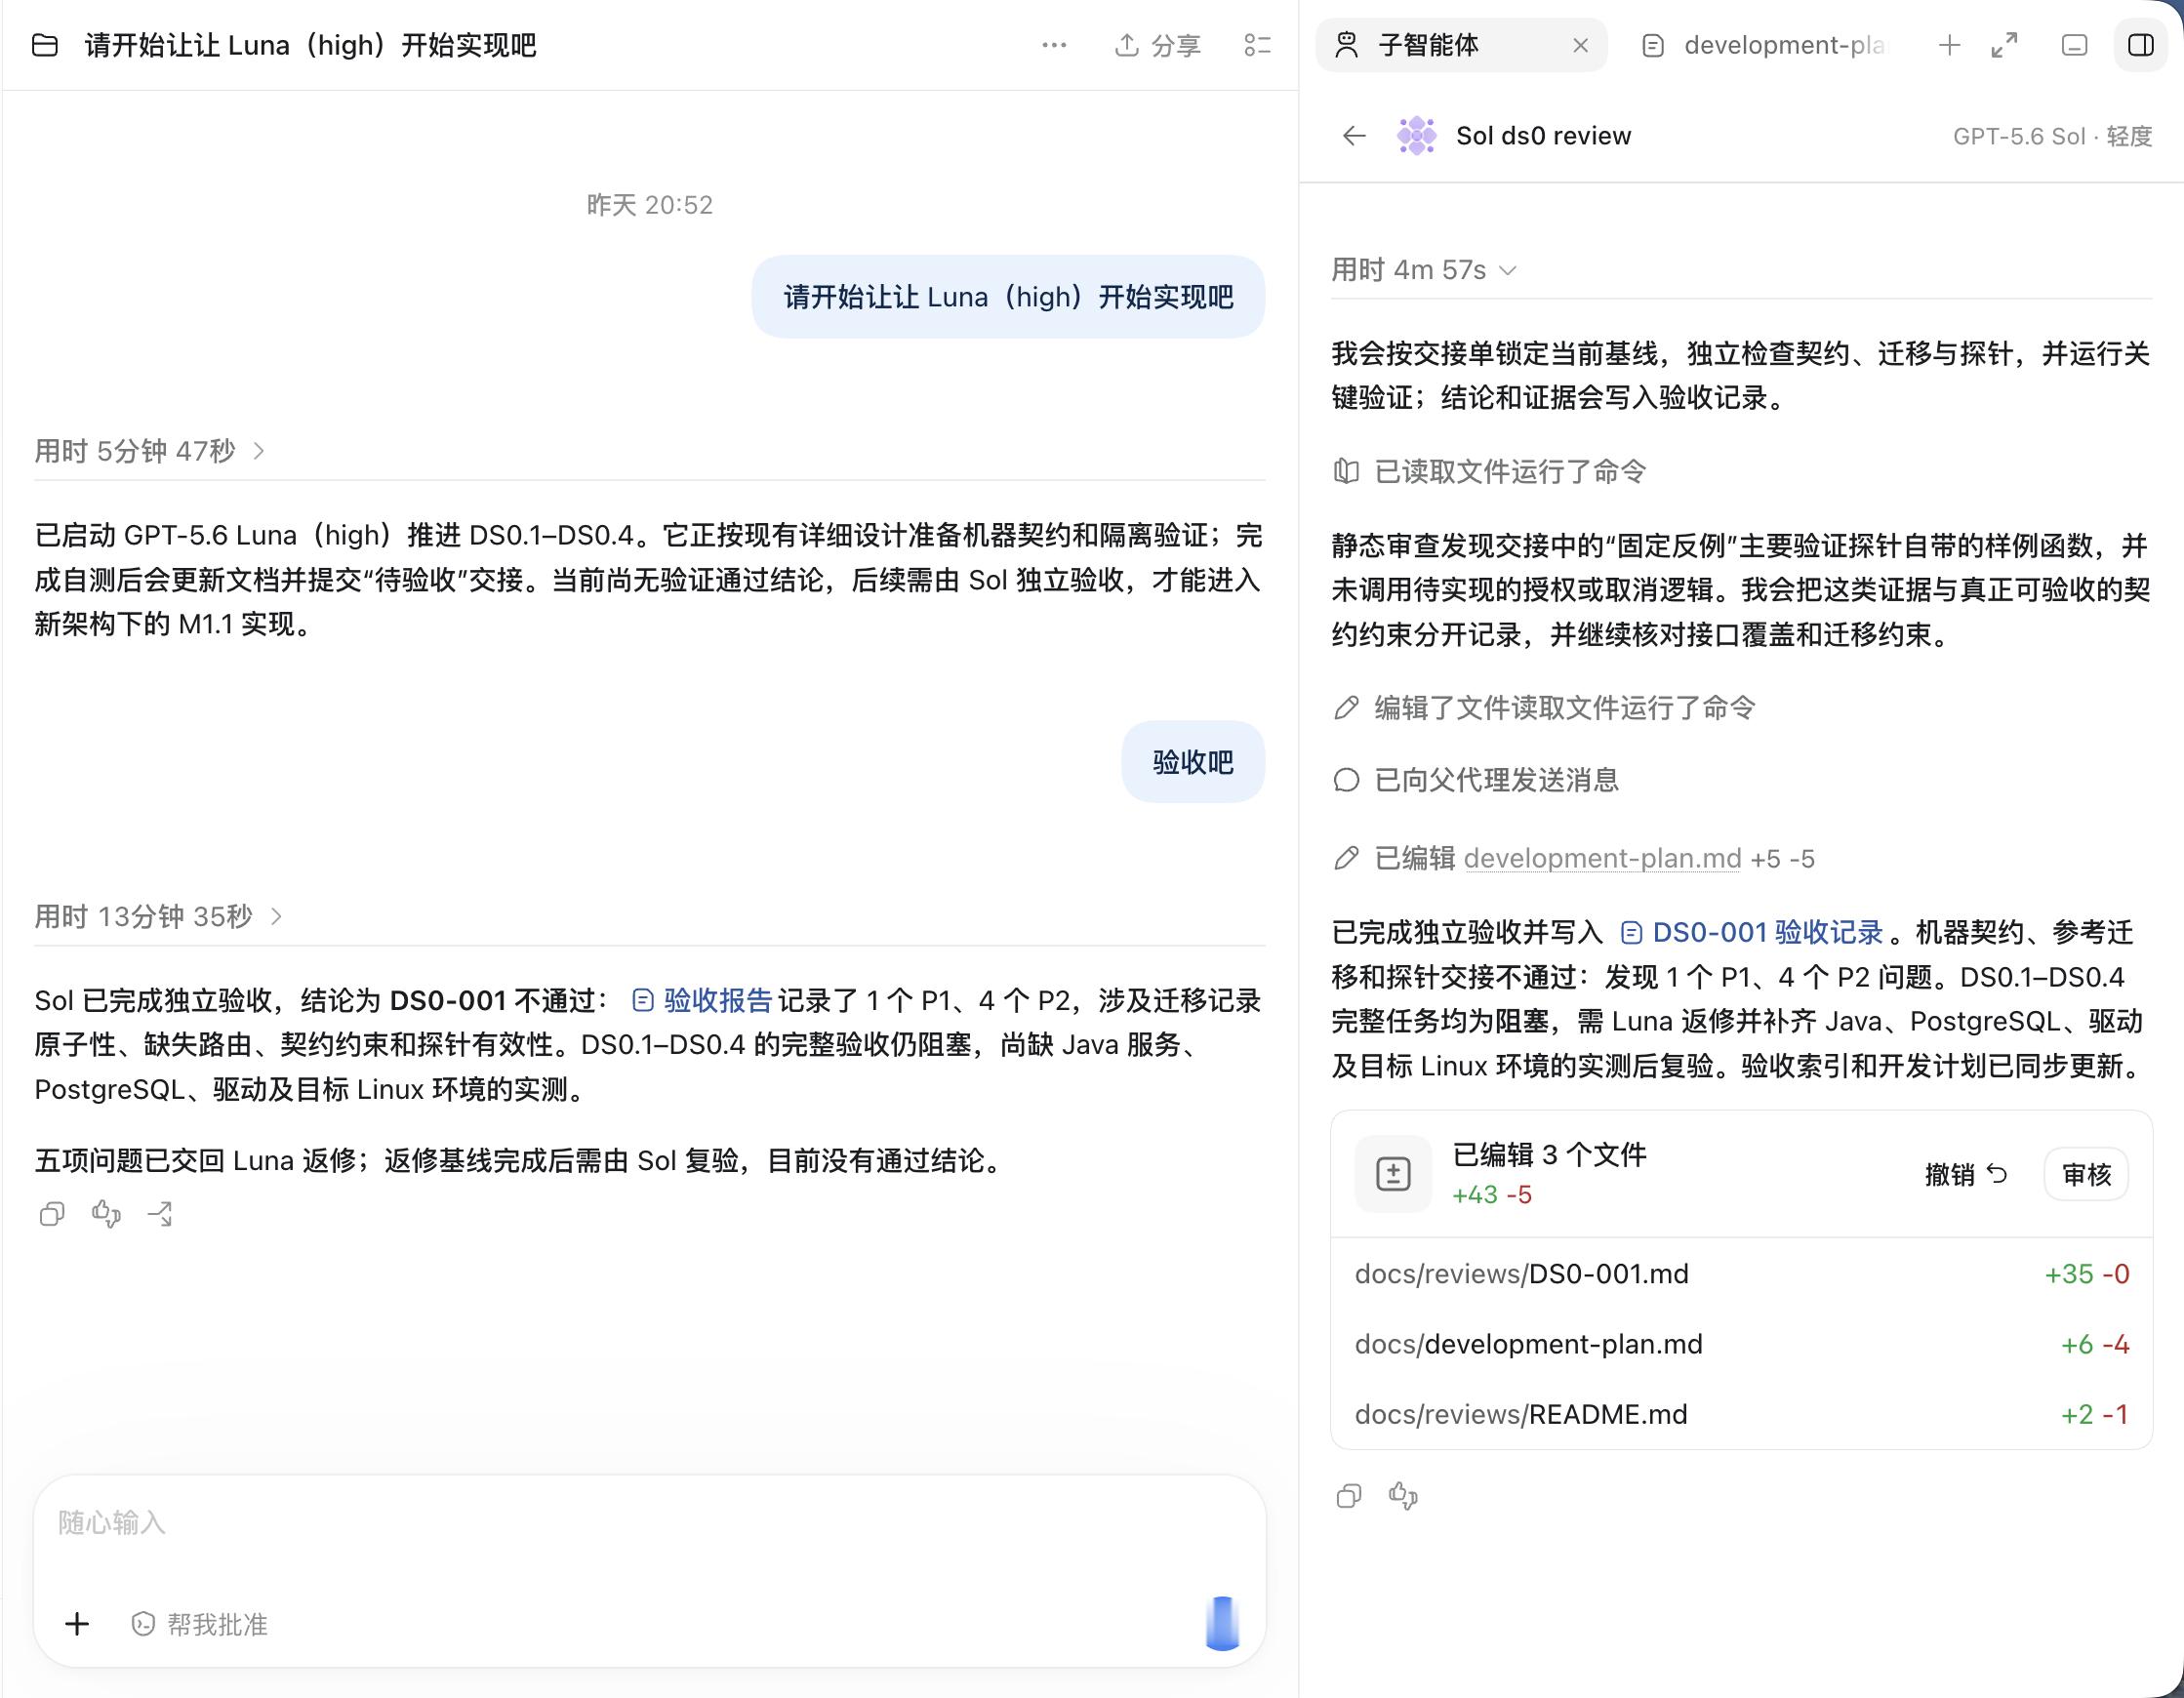
#ChatGPT[超话]# 用了 Codex 这么久,今天才发现一个挺好用的玩法:主会话里可以直接创建子智能体,还能让子智能体用不同的模型去干活。 比如我现在会这样用: 主会话负责拆任务、推进开发, 再拉一个 Luna(high)去实现, 然后让 Sol 单独做代码审查和验收。 相当于一个会话里直接组了个“小团队
2026-09-24 09:08
#ChatGPT[超话]# 用了 Codex 这么久,今天才发现一个挺好用的玩法:主会话里可以直接创建子智能体,还能让子智能体用不同的模型去干活。 比如我现在会这样用: 主会话负责拆任务、推进开发, 再拉一个 Luna(high)去实现, 然后让 Sol 单独做代码审查和验收。 相当于一个会话里直接组了个“小团队
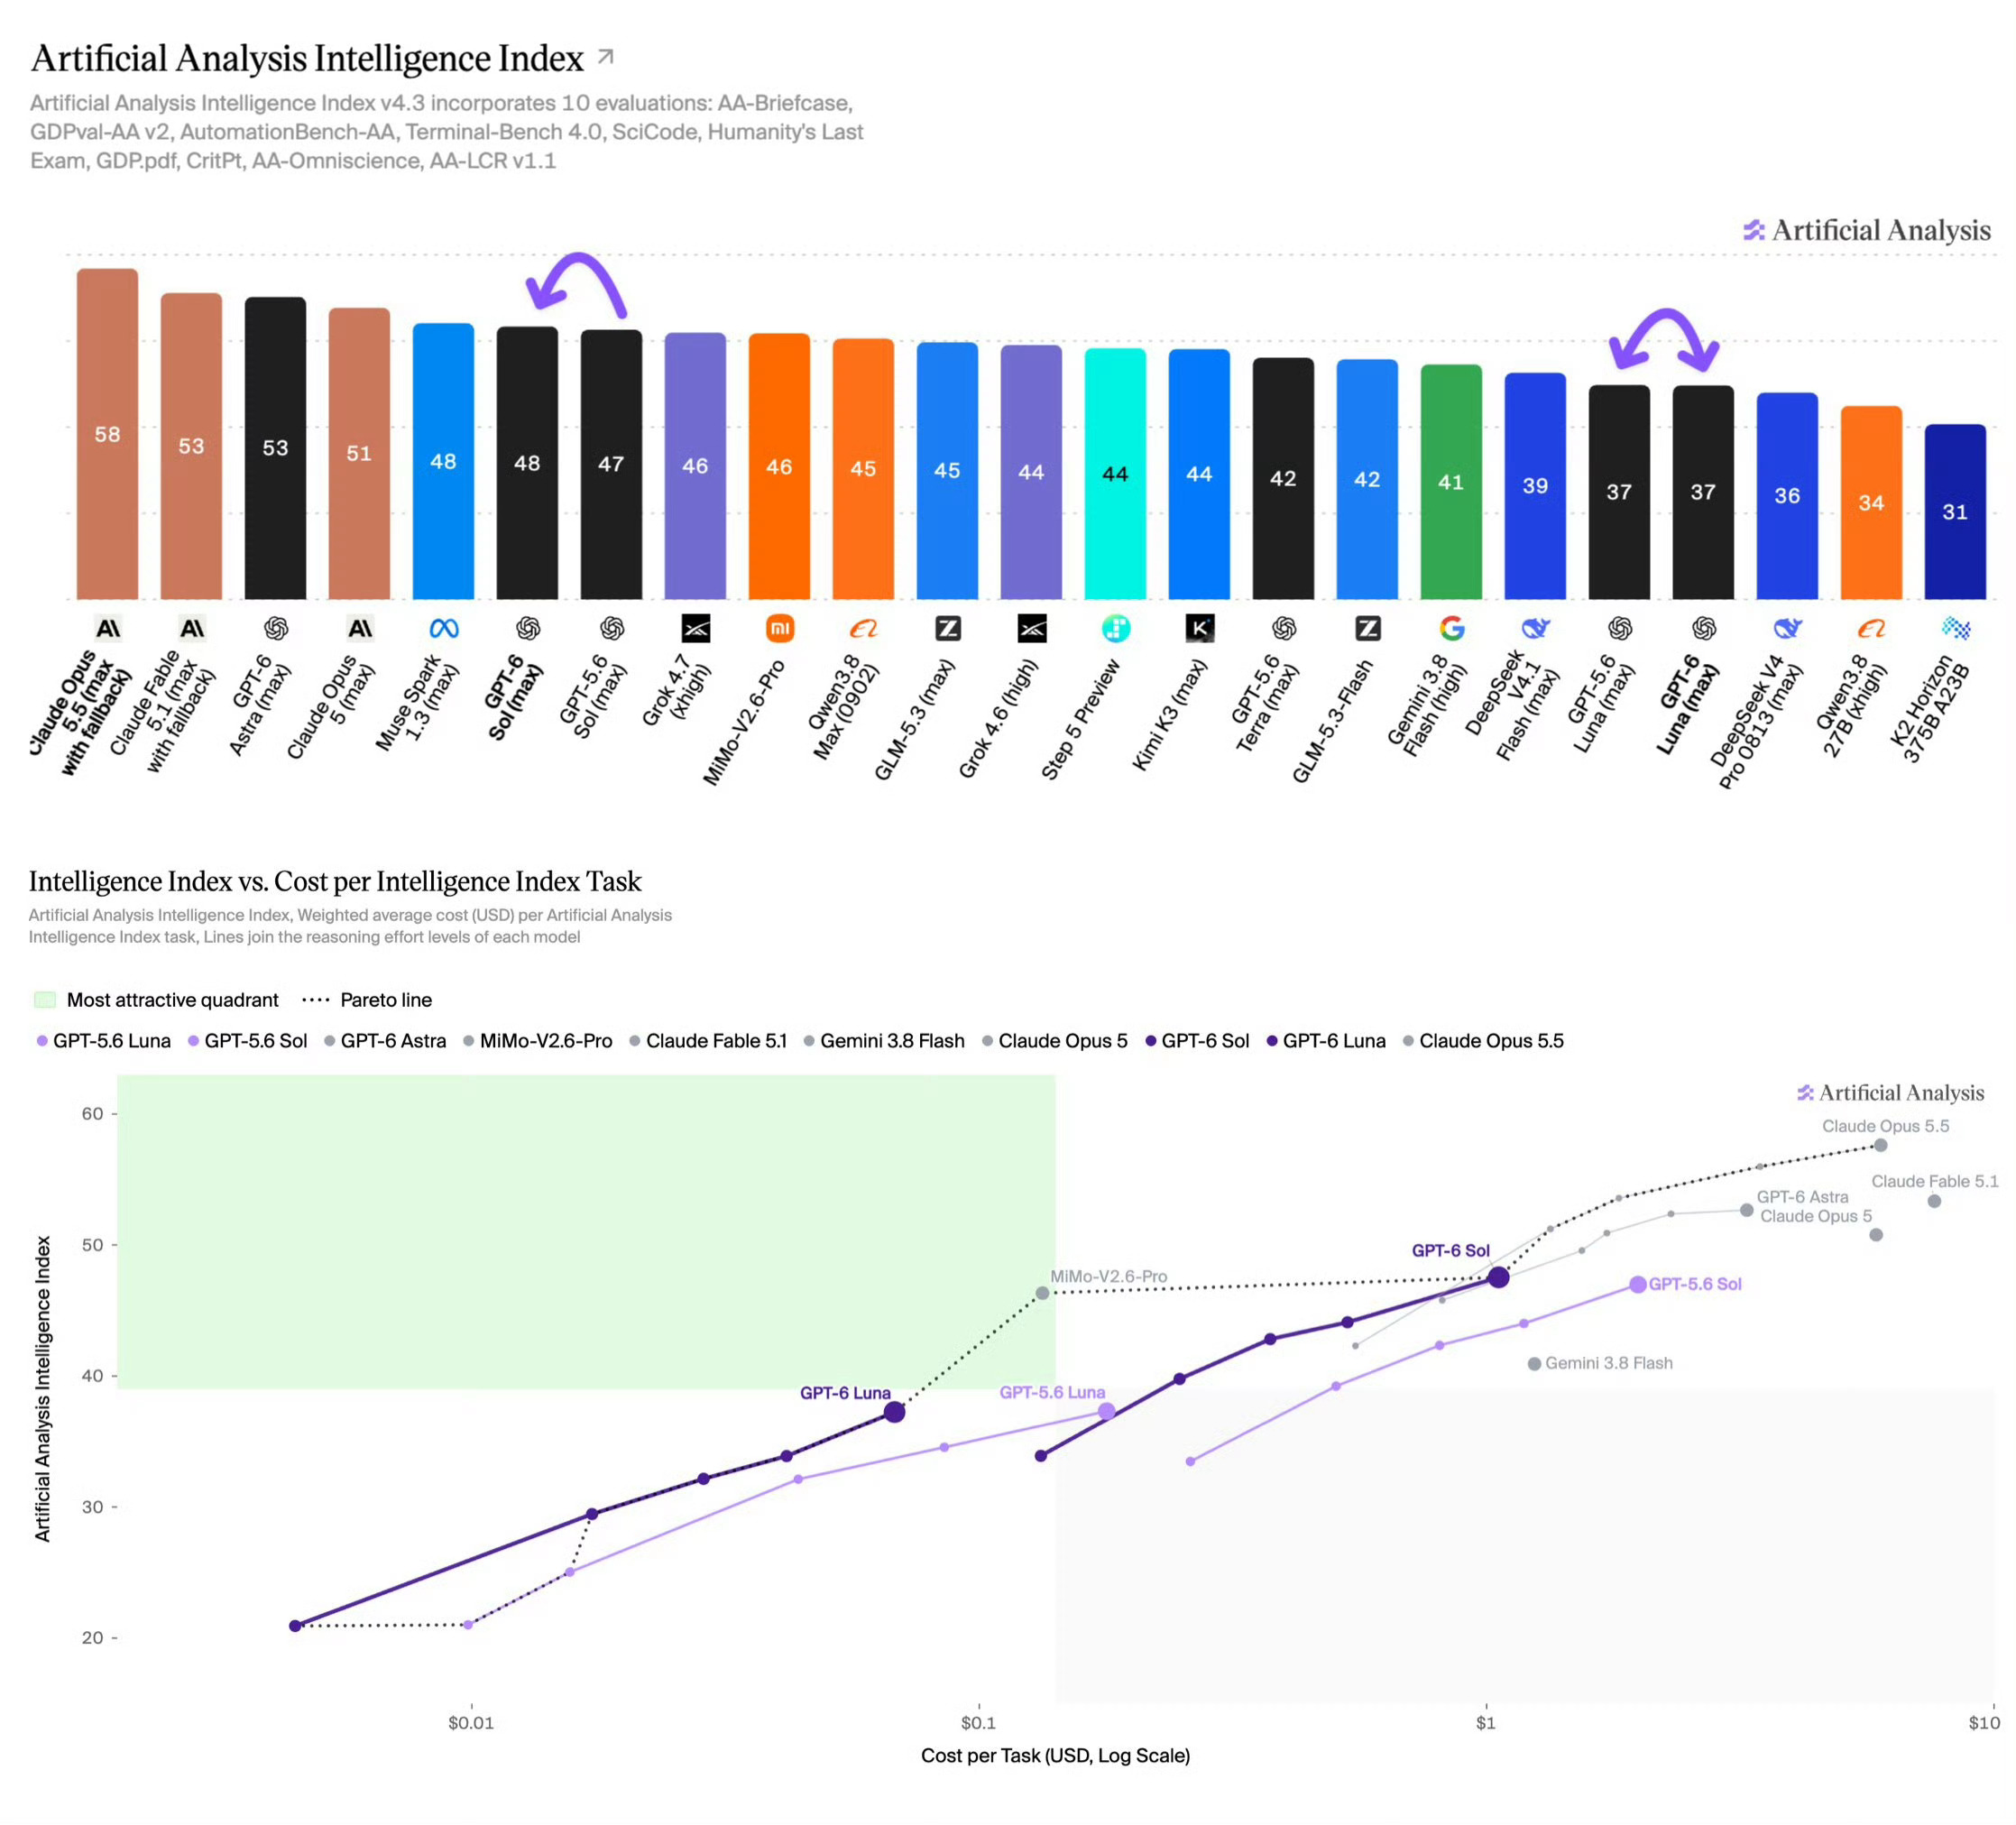
这两天的大模型圈真是又过年了,太热闹了,昨天 Grok 4.7 发布,小米 Mimo V2.6 发布,今天 Claude Opus 5.5 发布,GPT 5.6 Sol 和 Luna 发布。简单盘一下目前的最新战局: 1. Claude Opus 5.5:今天刚发,AA综合智能指数直接冲到 58 分登顶,表现逼近旗舰 Fable 5.1,安全性拉满,关键是成本降了 40%
2026-09-23 15:06
这两天的大模型圈真是又过年了,太热闹了,昨天 Grok 4.7 发布,小米 Mimo V2.6 发布,今天 Claude Opus 5.5 发布,GPT 5.6 Sol 和 Luna 发布。简单盘一下目前的最新战局: 1. Claude Opus 5.5:今天刚发,AA综合智能指数直接冲到 58 分登顶,表现逼近旗舰 Fable 5.1,安全性拉满,关键是成本降了 40%
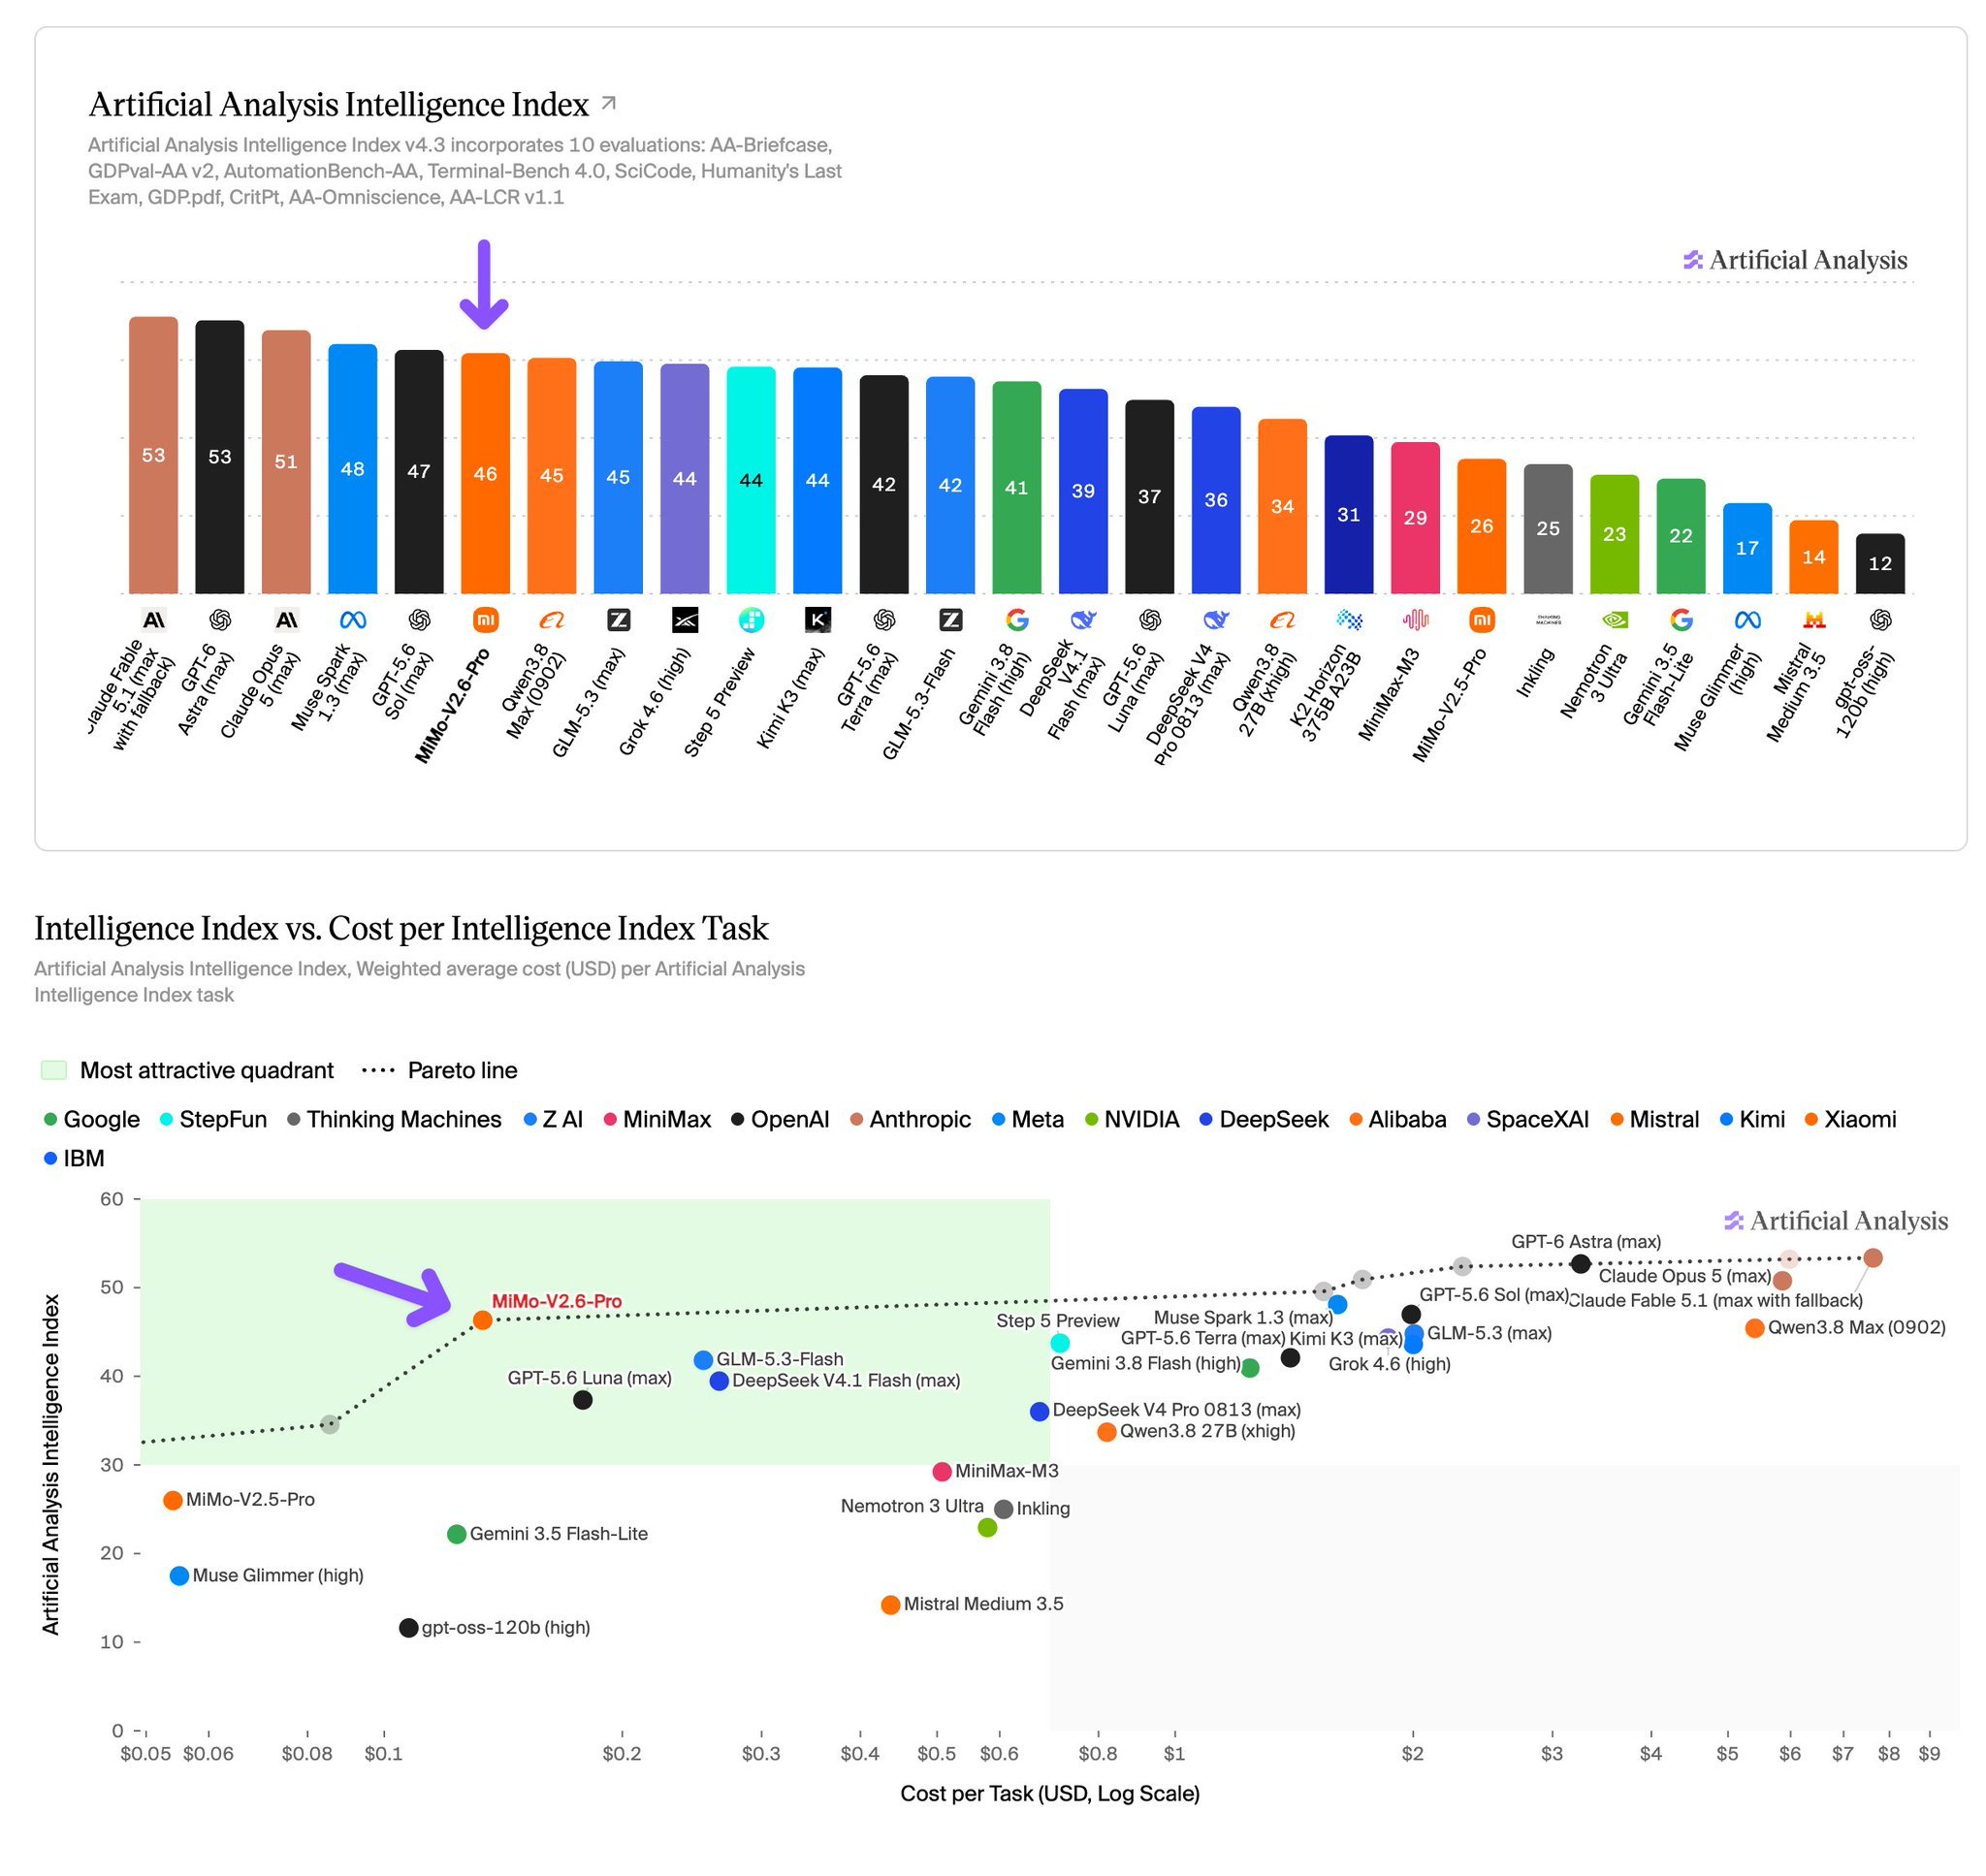
#小米MiMoV2.6发布并开源# #小米发布 MiMo v2.6 模型# 看了下小米 MiMo V2.6 的跑分,榜单上的成绩看上去很不错。 Code Arena WebDev 排全球第10,开源第3,1628分 AA 智能指数46分,性价比直接站在"最优象限",成本不到 GPT-6 的零头 DeepSWE 71.9、CyberGym 94.0、Toolathlon 76.9,跟 Claude Opu
2026-09-22 12:56
#小米MiMoV2.6发布并开源# #小米发布 MiMo v2.6 模型# 看了下小米 MiMo V2.6 的跑分,榜单上的成绩看上去很不错。 Code Arena WebDev 排全球第10,开源第3,1628分 AA 智能指数46分,性价比直接站在"最优象限",成本不到 GPT-6 的零头 DeepSWE 71.9、CyberGym 94.0、Toolathlon 76.9,跟 Claude Opu
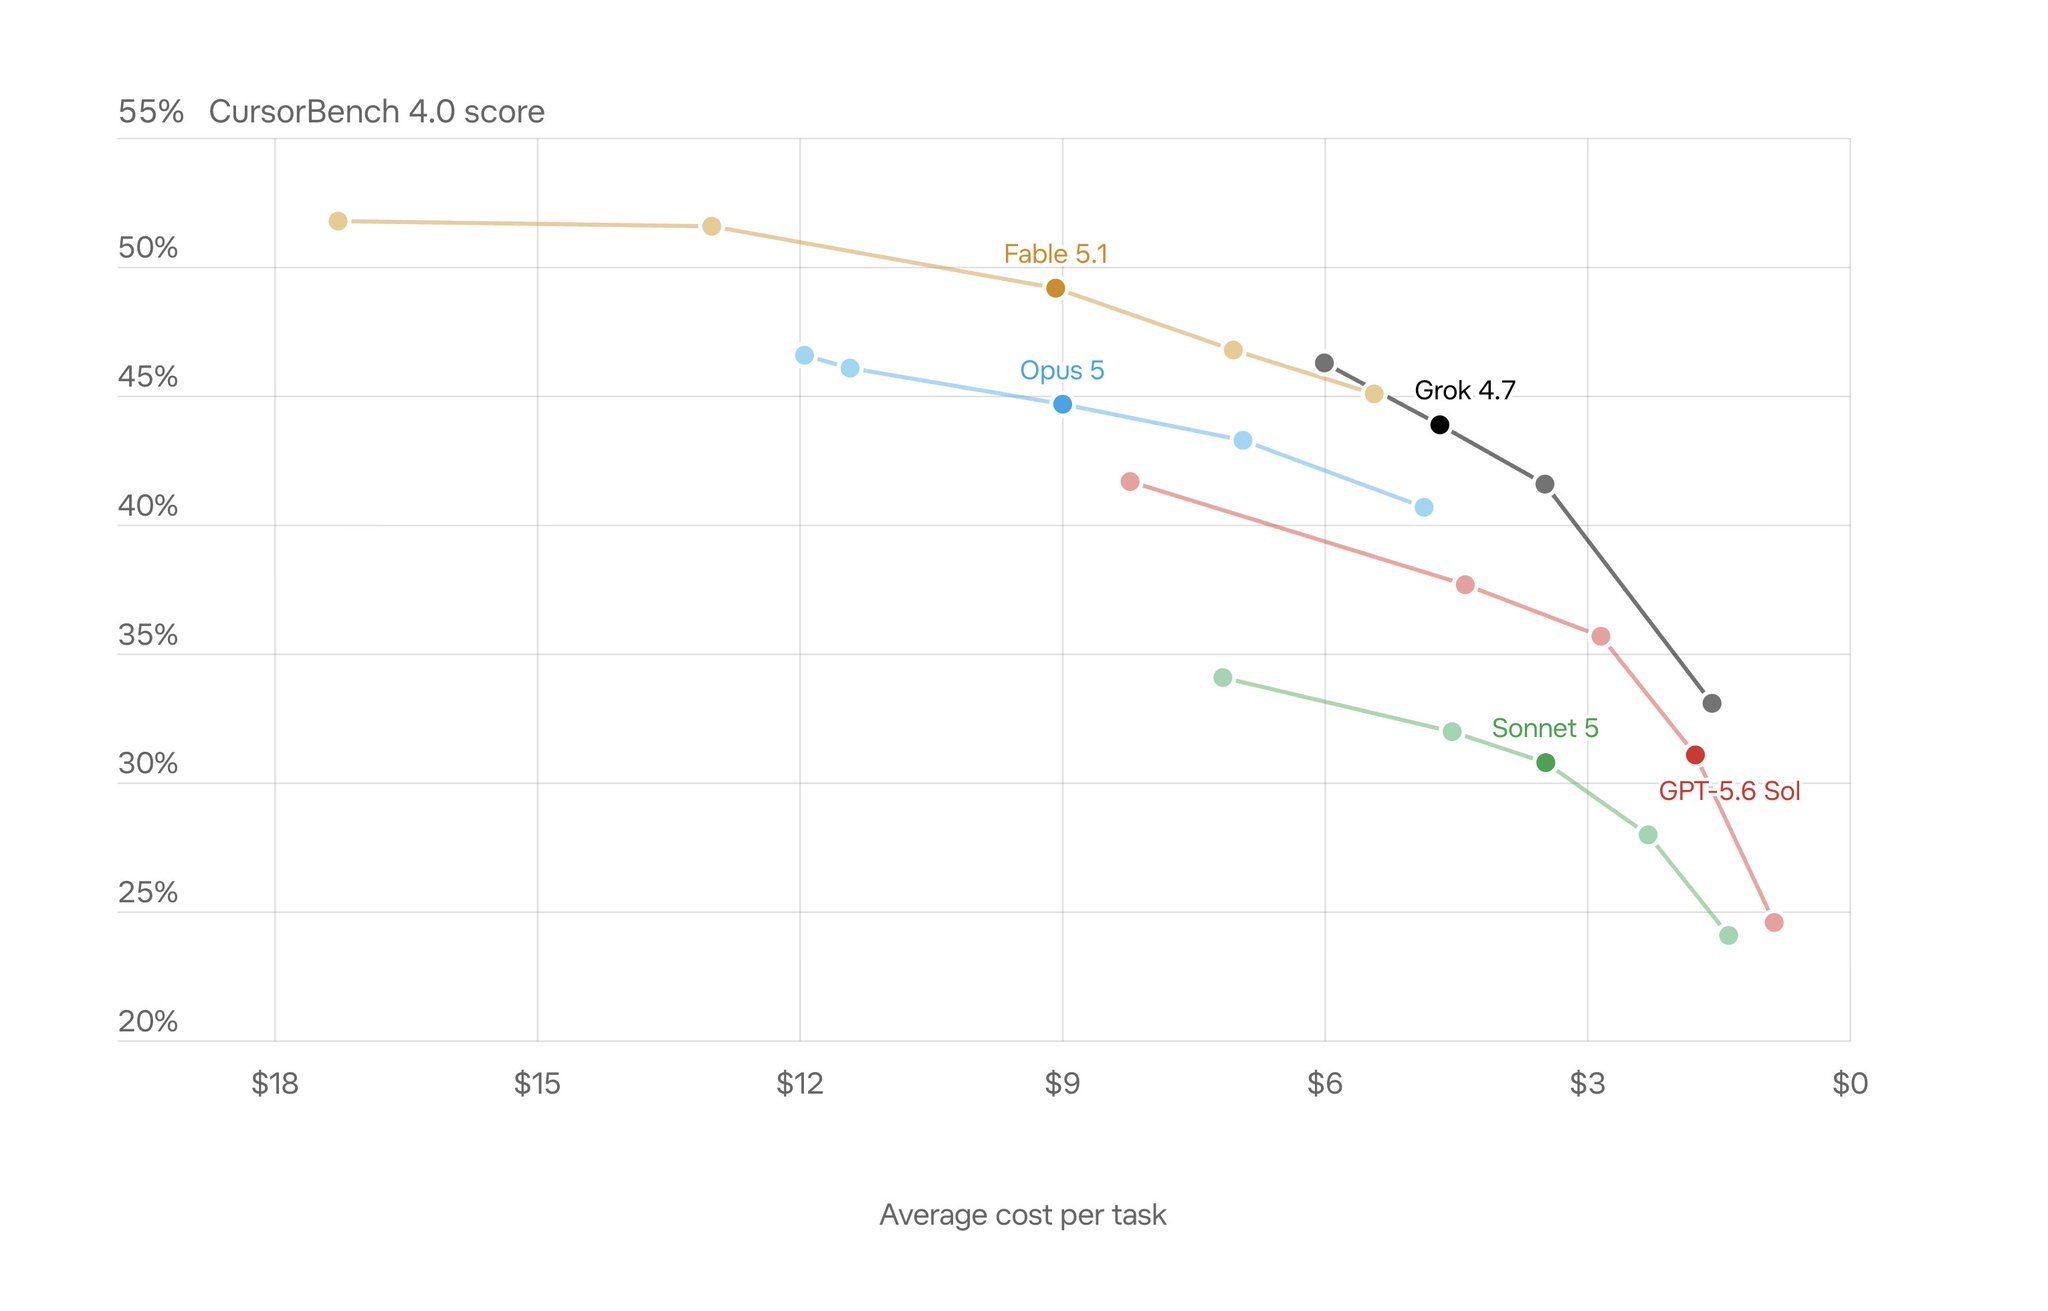
#SpaceXAI发布Grok4.7模型#Grok 4.7 发布了,这次 xAI 明显开始把重点放到 Coding Agent 和长时间任务上了。 从 Artificial Analysis 的数据看,Grok 4.7 的 AI Index 达到 46分,上一代 Grok 4.6 是44分;Coding Agent Index 更是从 47分提升到56分。 几个比较亮眼的数据: CursorBench 46.3%、DeepS
2026-09-22 11:29
#SpaceXAI发布Grok4.7模型#Grok 4.7 发布了,这次 xAI 明显开始把重点放到 Coding Agent 和长时间任务上了。 从 Artificial Analysis 的数据看,Grok 4.7 的 AI Index 达到 46分,上一代 Grok 4.6 是44分;Coding Agent Index 更是从 47分提升到56分。 几个比较亮眼的数据: CursorBench 46.3%、DeepS
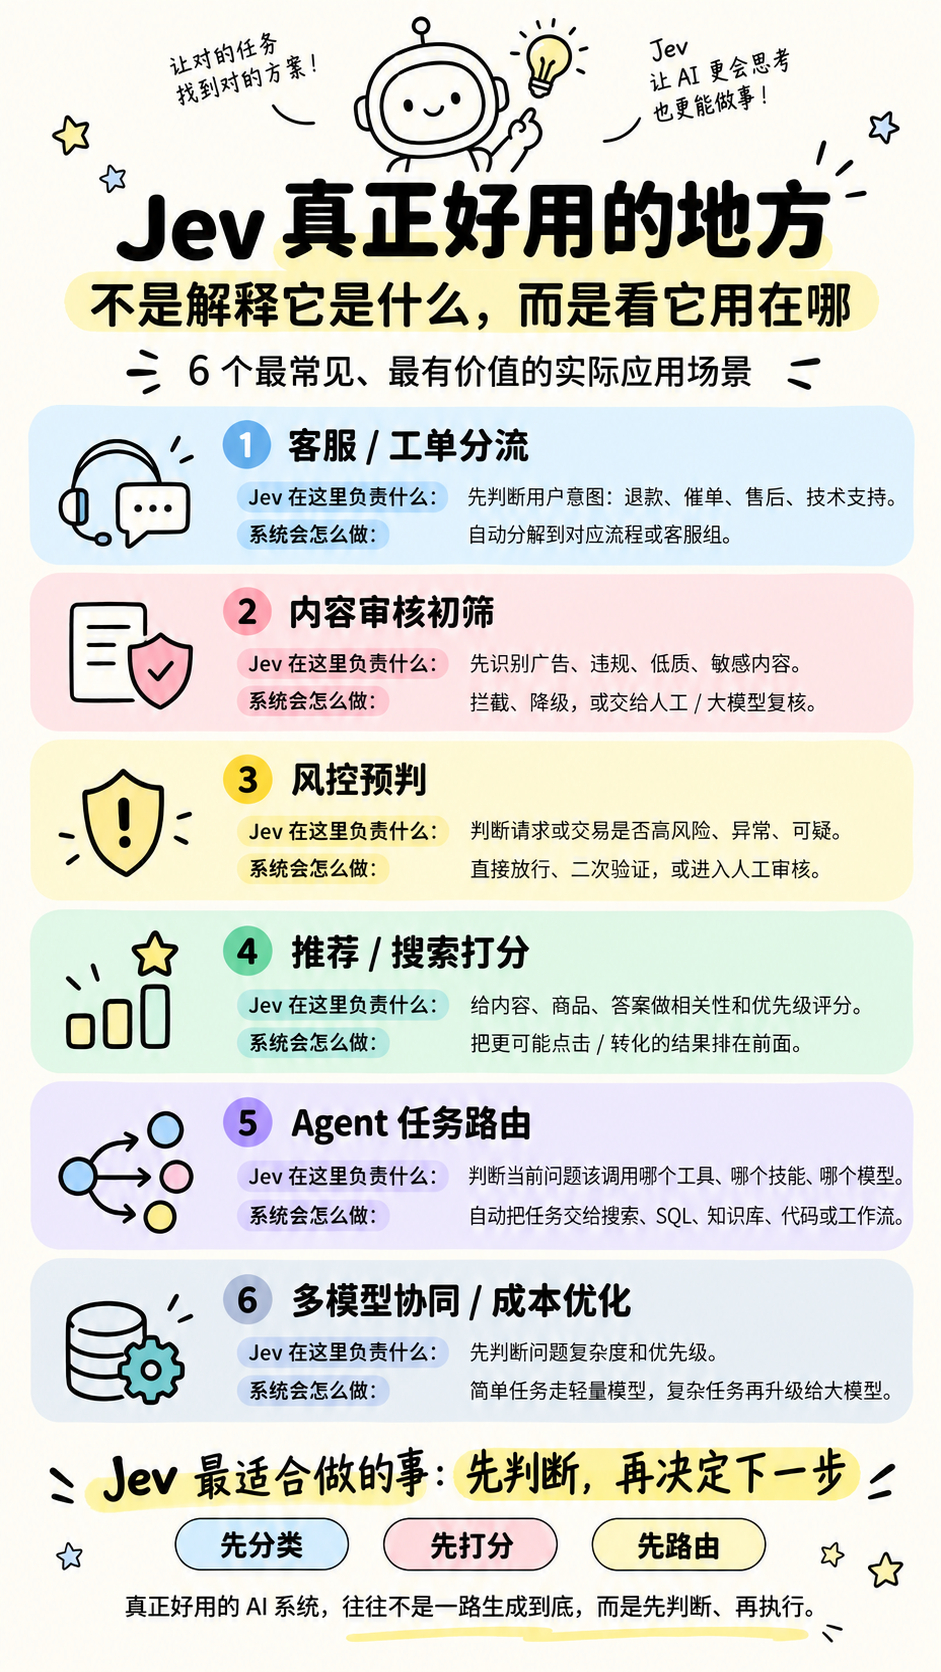
#引爆AI圈的Jev怎么玩# 这两天 Jev 很火,但相比“它到底是什么模型”,我更关心的是:它到底能用在哪? 我觉得 Jev 真正有价值的地方,是放进 AI 系统里负责“先判断”: 客服来了,先判断该分给哪个工单; 内容进来,先做审核初筛; 交易请求来了,先判断风险; 搜索推荐里,先给结果打分; Agent
2026-09-21 19:37
#引爆AI圈的Jev怎么玩# 这两天 Jev 很火,但相比“它到底是什么模型”,我更关心的是:它到底能用在哪? 我觉得 Jev 真正有价值的地方,是放进 AI 系统里负责“先判断”: 客服来了,先判断该分给哪个工单; 内容进来,先做审核初筛; 交易请求来了,先判断风险; 搜索推荐里,先给结果打分; Agent
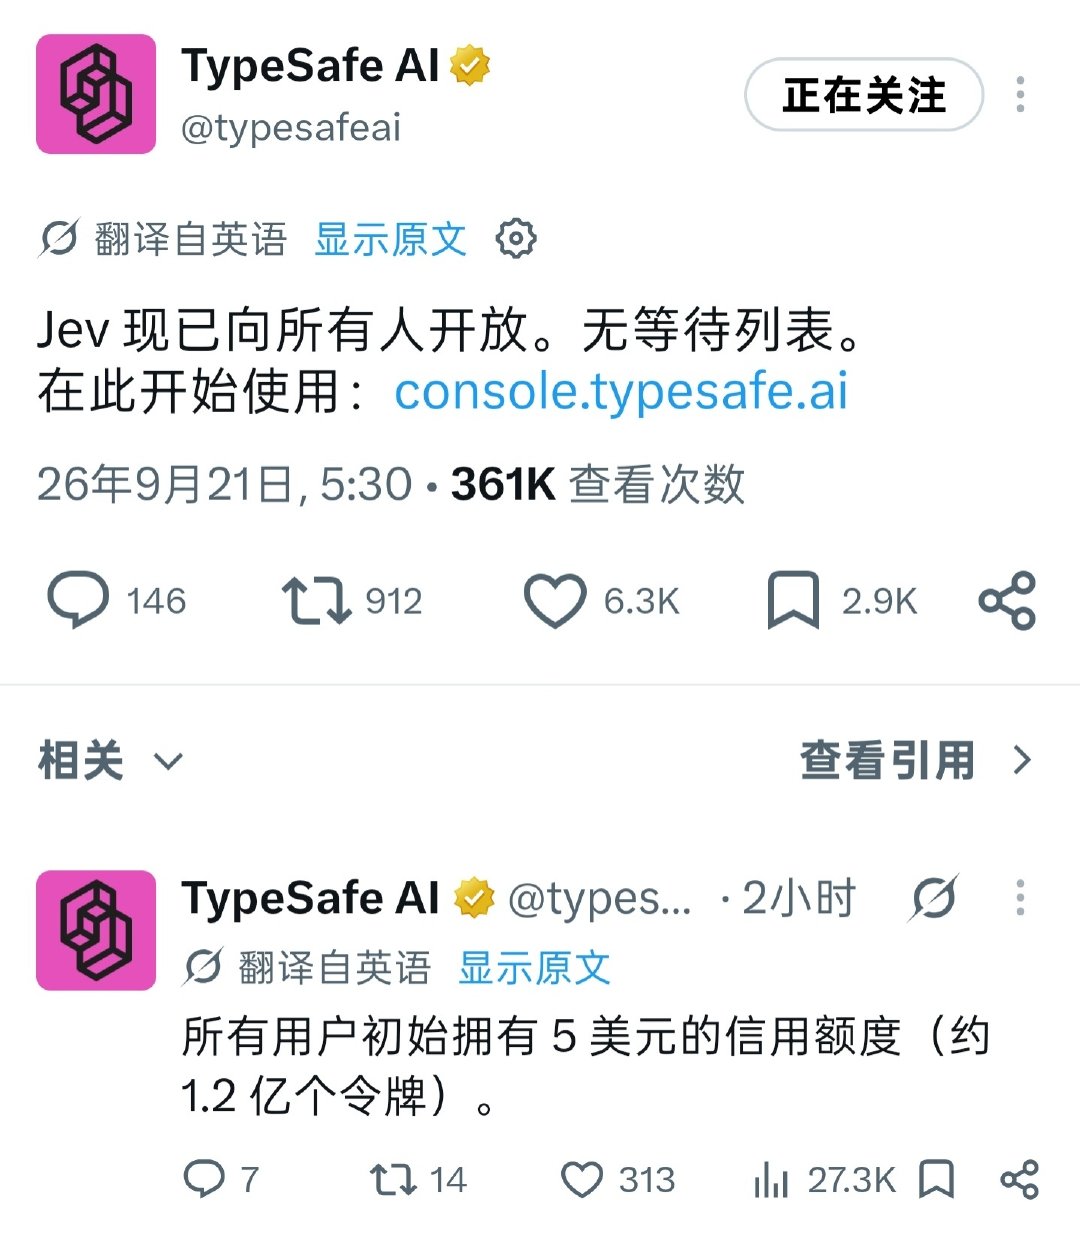
TypeSafe.AI 今天凌晨官宣 Jev 现已正式开放,无需申请白名单即可使用,每个用户赠送 5 美元约 1.2 亿 token 有效期 30 天。 有需要的可以注册使用了, 1.访问 typesafe.ai 网站注册账号 2.创建 API Key 3. 按照官网快速入门进行安装 skill 4. 聊天输入框直接发 "用 TypeSafe 技能" 就可以使用了
2026-09-21 18:30
TypeSafe.AI 今天凌晨官宣 Jev 现已正式开放,无需申请白名单即可使用,每个用户赠送 5 美元约 1.2 亿 token 有效期 30 天。 有需要的可以注册使用了, 1.访问 typesafe.ai 网站注册账号 2.创建 API Key 3. 按照官网快速入门进行安装 skill 4. 聊天输入框直接发 "用 TypeSafe 技能" 就可以使用了
#DeepSeek[超话]# #deepseek崩了#DeepSeek 又崩了,最近 DeepSeek 的服务太不稳定了,动不动就崩溃,DeepSeek 真应该找几个大神好好弄弄。
2026-09-20 18:19
#DeepSeek[超话]# #deepseek崩了#DeepSeek 又崩了,最近 DeepSeek 的服务太不稳定了,动不动就崩溃,DeepSeek 真应该找几个大神好好弄弄。
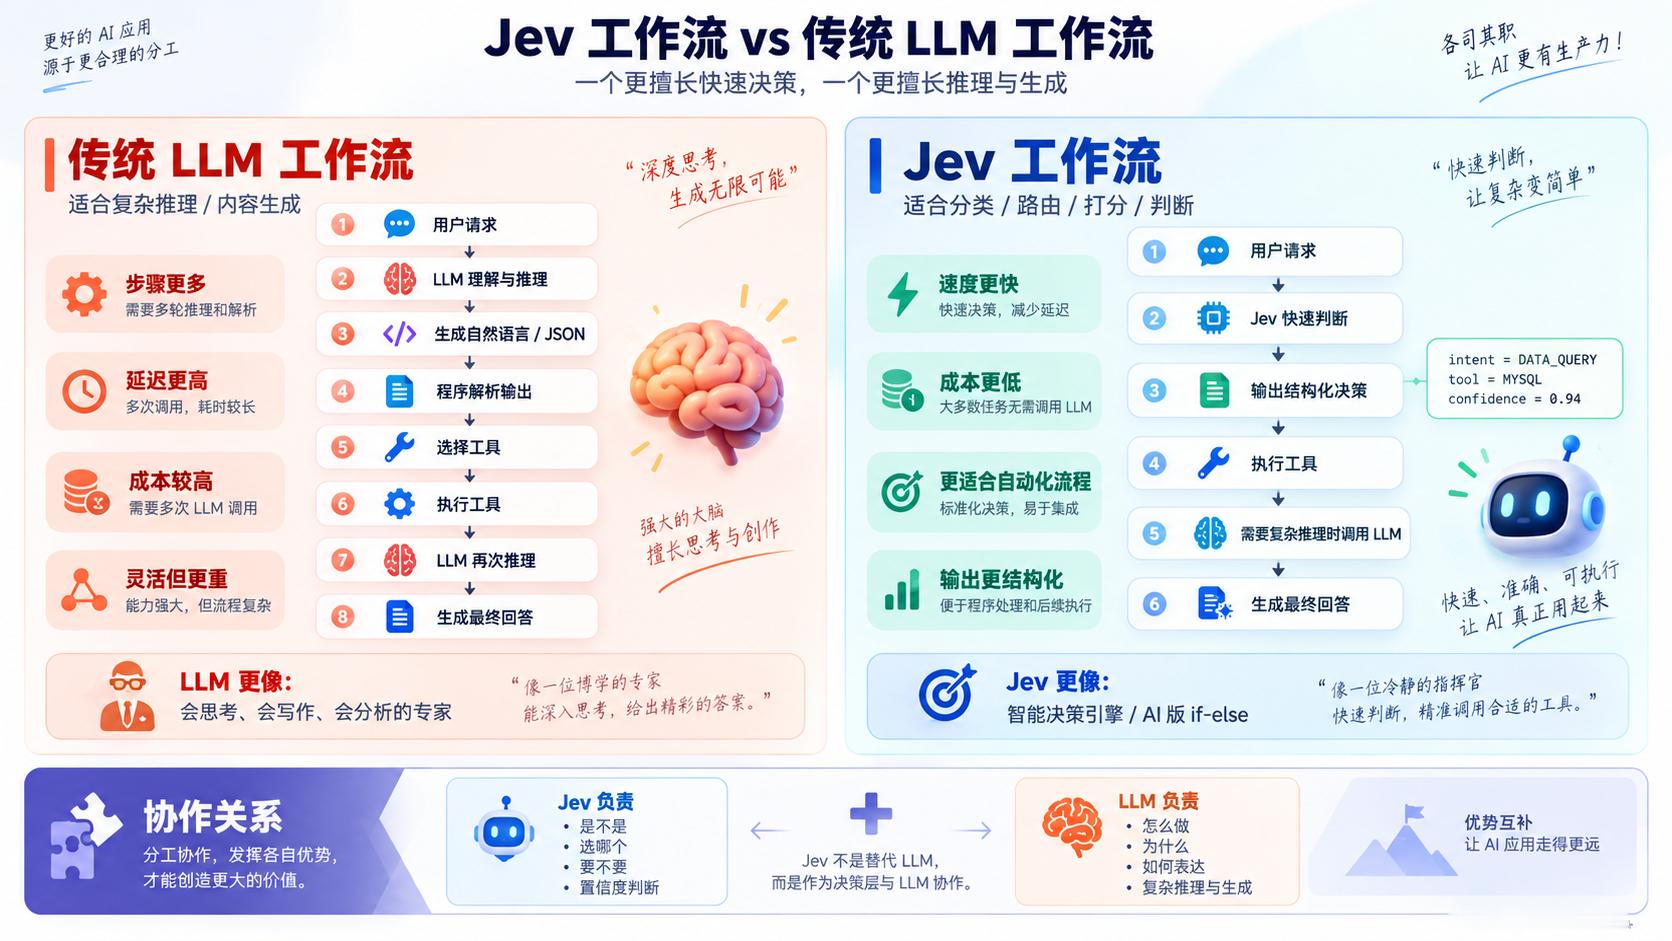
传统 LLM 更擅长“思考 + 生成”:你问它一个问题,它会分析、推理,最后生成一段文字告诉你答案。 而 Jev 更像是在“做判断做选择题”。 比如给它几个选项: A、B、C 它不会先思考半天然后长篇大论地解释,而是直接告诉你: A:92% B:6% C:2% 所以Jev可以这么理解: LLM 像一个会分析、会写东
2026-09-20 19:32
传统 LLM 更擅长“思考 + 生成”:你问它一个问题,它会分析、推理,最后生成一段文字告诉你答案。 而 Jev 更像是在“做判断做选择题”。 比如给它几个选项: A、B、C 它不会先思考半天然后长篇大论地解释,而是直接告诉你: A:92% B:6% C:2% 所以Jev可以这么理解: LLM 像一个会分析、会写东
第一页
下一页
作者信息
小白鼠热玩科技
谢谢喜欢,常来看看
分类: 其他
热门分类
推荐
热榜
军事
NBA
体育
社会
明星八卦
娱乐
财经
科技
汽车
历史
国际
游戏
动漫
公益
搞笑
商业
互联网
数码
国际足球
房产
家居
时尚
科学探索
职场
育儿
股票
教育
影视
情感
热点
中国军情
武器
中国南海
中国足球
亚洲杯
科比
综合体育
CBA
投资
楼市
大咖秀
外汇
创业
风口
SUV
豪车
概念车
优惠
新能源
美国
欧洲
朝日韩
俄罗斯
孕期
街拍
恋爱攻略
婚姻
正能量