MolRSI:科研智能体怎样积累经验?
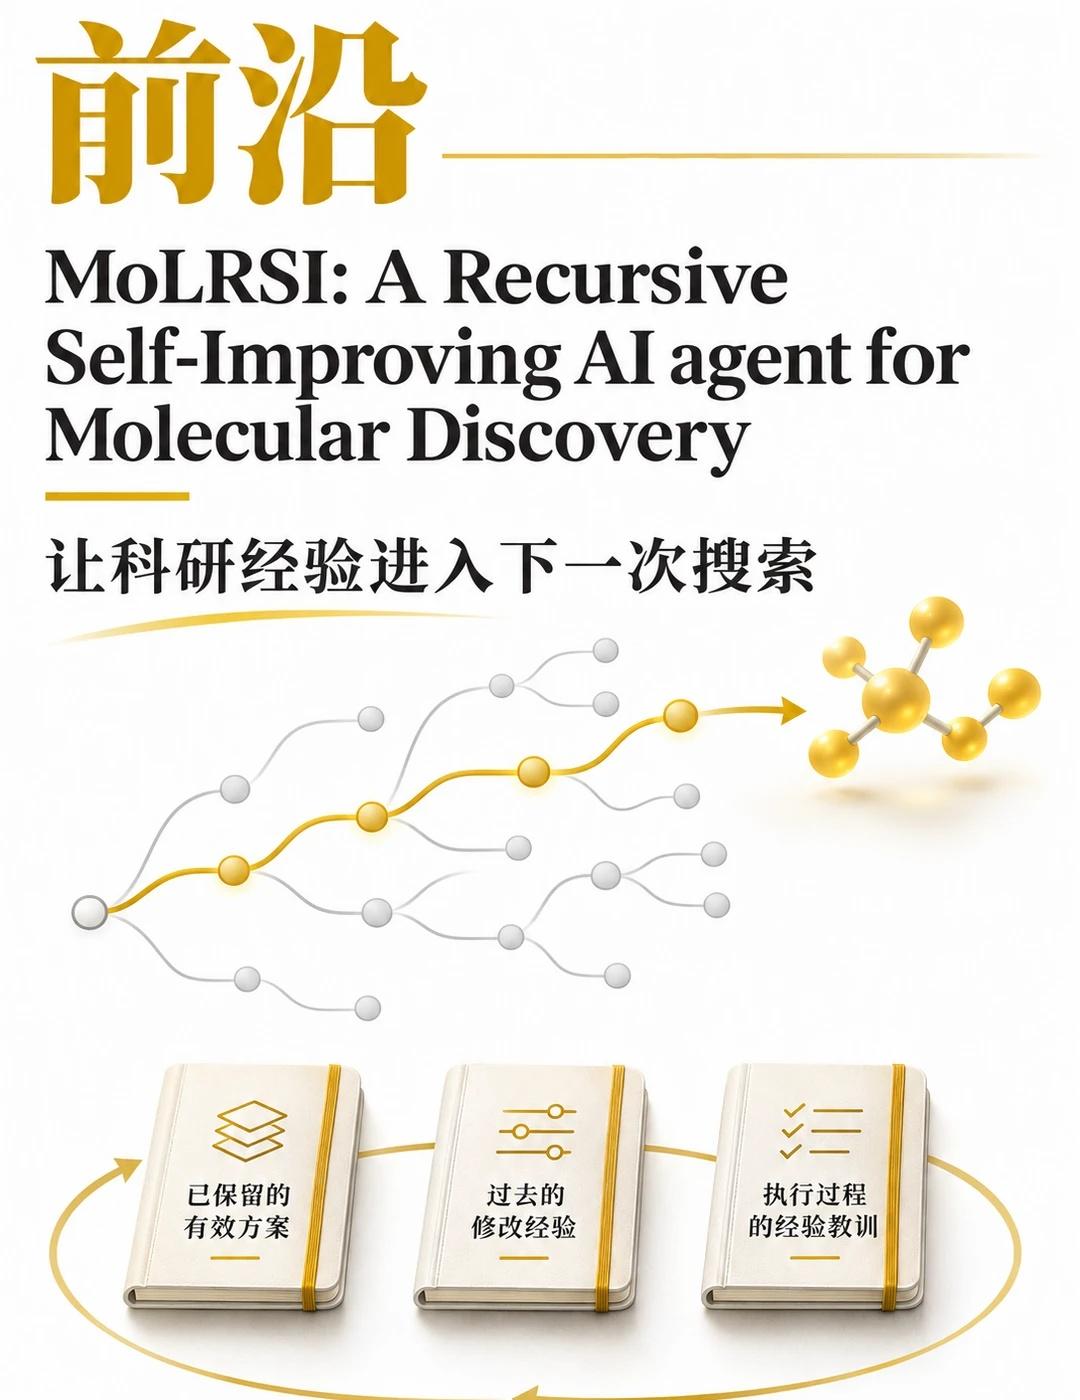
一个科研智能体完成项目后,下次还要从头摸索吗?MolRSI把工作流选择、修改成败和运行故障保留下来,让过去的搜索经验参与下一轮分子发现。论文讨论的“递归自我改进”,核心是搜索策略随经验更新。
机制分为两层。首先,Explore Agent从论文、代码和工具中构建可执行技能,检查依赖、接口并运行示例,修复后仍失败的技能会被移除。随后,智能体以工作流为节点做蒙特卡洛树搜索,在已有方案上修改模型、组件组合或参数,再执行评估。
选择哪条分支,既看当前任务得分,也看相关任务的历史表现,并给探索不足的方案留机会。搜索在规定预算内返回开发集表现最好的工作流;测试集用于搜索结束后的评价,不能混作开发反馈。
持续学习靠三种记忆:方案记忆保存代码、配置和得分;修改记忆记录改了什么、为何修改以及得分如何变化,失败和退步也保留;执行记忆记录资源消耗、报错和修复结果。后续任务据此选择起点、安排探索、减少重复调试。
这里更新的是经验驱动的决策过程。研究中MolRSI使用Claude Sonnet 5作为推理骨干;论文证据主要支持工作流搜索改进,不能据此推断底层大模型能力无限增长。
关键消融来自抗菌预测:先积累25个来源任务的经验,排除六个目标抗菌任务;在相同技能库、骨干和搜索预算下,有历史经验的版本在六项任务上都提高了平均测试AUPRC。所谓“零搜索迁移”仍会用目标训练数据拟合模型、用验证数据评价,只是省去新的工作流搜索。
体外验证中,系统选出的107个化合物有17个达到论文定义的抗菌命中标准,命中率15.9%;既往专家流程为21/241,即8.7%。两者使用相同训练数据和筛选库,但属于历史对照,实验协议不保证完全一致,论文也未报告组间显著性检验。
另一个pMHC结合体设计实验,在两个靶点分别得到5/251和3/266个可评价设计的命中,表现为对预定靶点的实验富集及相对已测脱靶的偏好。这些结果尚不能替代全面特异性、功能或临床验证。
价值在于把科研流程开发变成可积累经验的搜索过程。边界在于来源任务是否相关、开发指标是否贴近生物目标,以及搜索计算成本;论文也把实验结果进一步回流策略列为未来方向。
分子发现 机器学习