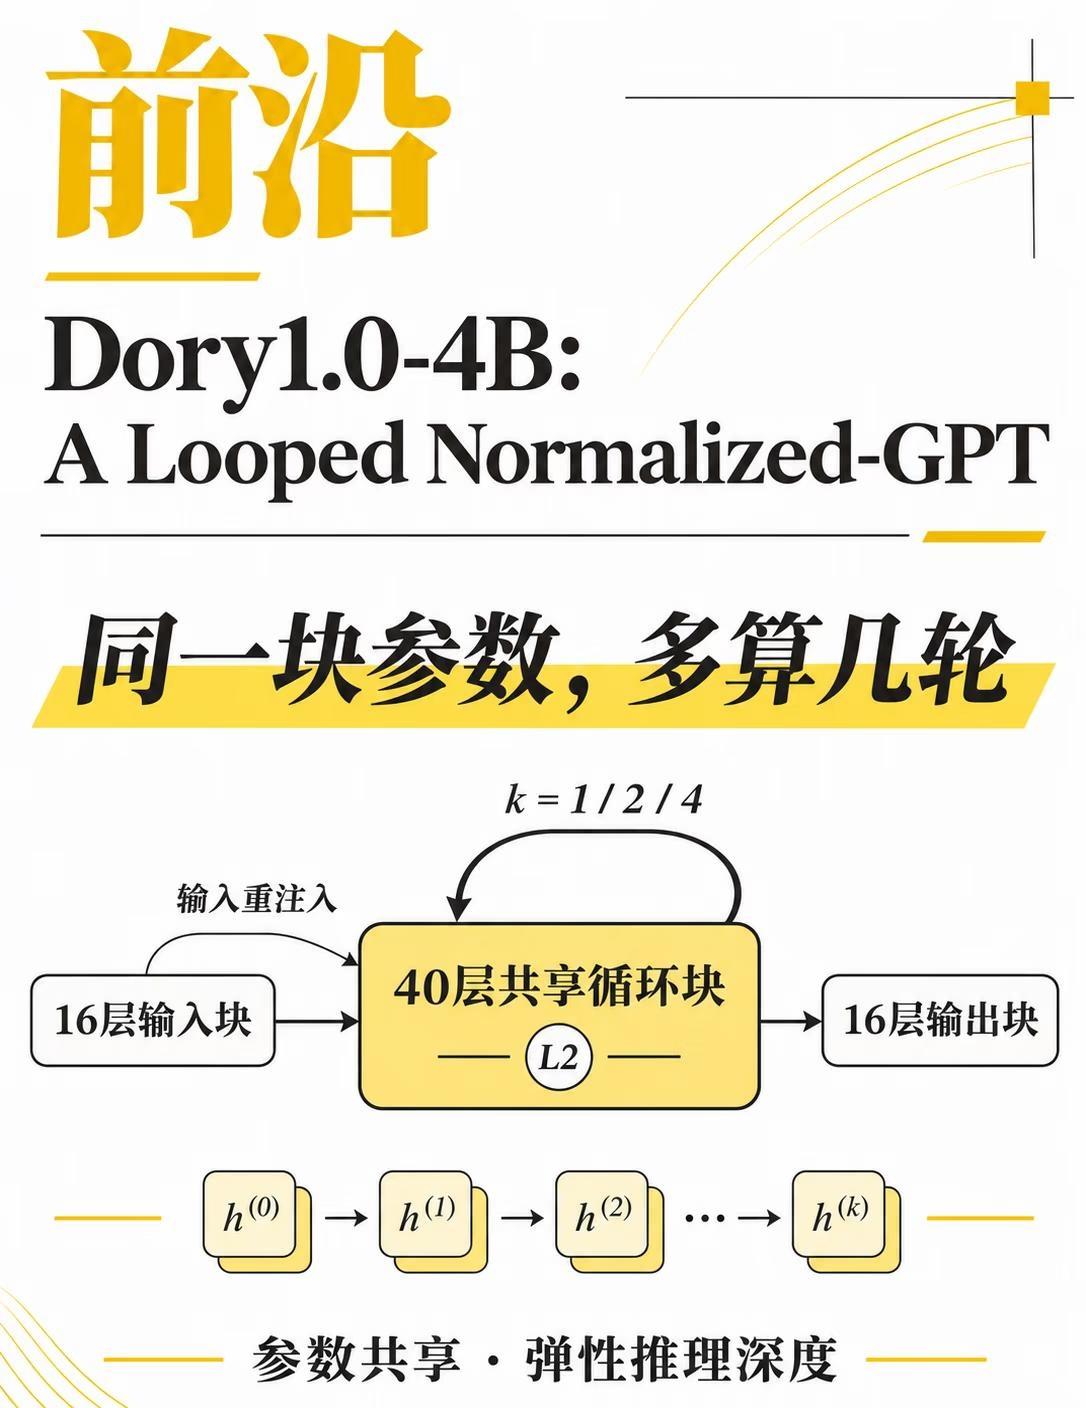
Dory:同一块参数怎样多想几轮?
模型答题不稳,除了扩大参数,还能把同一组层多跑几遍。英伟达的Dory1.0-4B把这条路线做成了可调深度的语言模型:每生成一个词元,先在隐藏状态里完成若干轮计算,再输出结果。这里的“多想”发生在网络内部。
结构是关键。网络有72个物理层,分成16层输入块、40层共享循环块、16层输出块。输入和输出各执行一次,中间同一块执行k次,权重及归一化缩放参数都复用。因此四轮不会把40亿参数变成160亿参数,却会增加每个词元的计算量;按层调用计,一轮72次,四轮192次。
为什么能反复算?每轮先把输入块的输出重新注入当前状态,再做L2归一化,送入共享块,输出再归一化。持续补入原始输入表征,配合归一化GPT的尺度约束,让迭代保持可控。它是在同一隐藏空间里更新状态,不需要为每轮另配一套网络。
训练也要适配循环。预训练和长上下文扩展累计约6.3万亿词元,循环训练覆盖1至4轮。强化学习阶段先用一轮模型估计题目难度,再让困难题更倾向进入深循环工作器,同时保留随机分配。这个难度路由用于训练;部署时选几轮,仍是明确的推理配置,并非模型已经学会自动决定何时停止。
收益有多大?同一后训练检查点,一、二、四轮的12项指标等权综合分为35.17、39.67、40.60,其中Elo经过换算,不能当统一正确率。SWE-Bench Verified得分从50.3升至59.5、61.8;GPQA正确率则二轮72.41%、四轮72.16%,说明加深不保证每项都上涨。
显存还有一招:循环层通常要为每轮各留一份KV缓存,作者改成只保留末轮的历史键值,新循环覆盖旧条目,让注意力KV容量保持一轮水平。但早期循环会读取历史词元的末轮表征,已改变训练时的对应关系。四轮测试中,相对逐轮缓存,分数变化为−2.12至+0.42个百分点;这不是无损替换,也不代表总显存恒定。
更有意思的是,四项智能体任务中,四轮每次尝试的输出词元约降至一轮的40%至77%,来自更少交互轮次或更短输出。不过每词元算得更多,不能直接换算成同比例提速。它的意义是把参数容量与计算深度拆开调节:在任务、延迟和内存预算之间寻找合适循环数,而非无限循环必然更强。
Dory论文与模型合集。
大语言模型 循环推理 模型架构