Vision-as-a-Tool |把视觉变成bash命令
Coding Agent 之所以强大,离不开 grep、diff 等简洁通用的 bash 命令。那做 Multimodal Agentic Coding 时,为什么非要让模型靠自己的“肉眼”硬看?
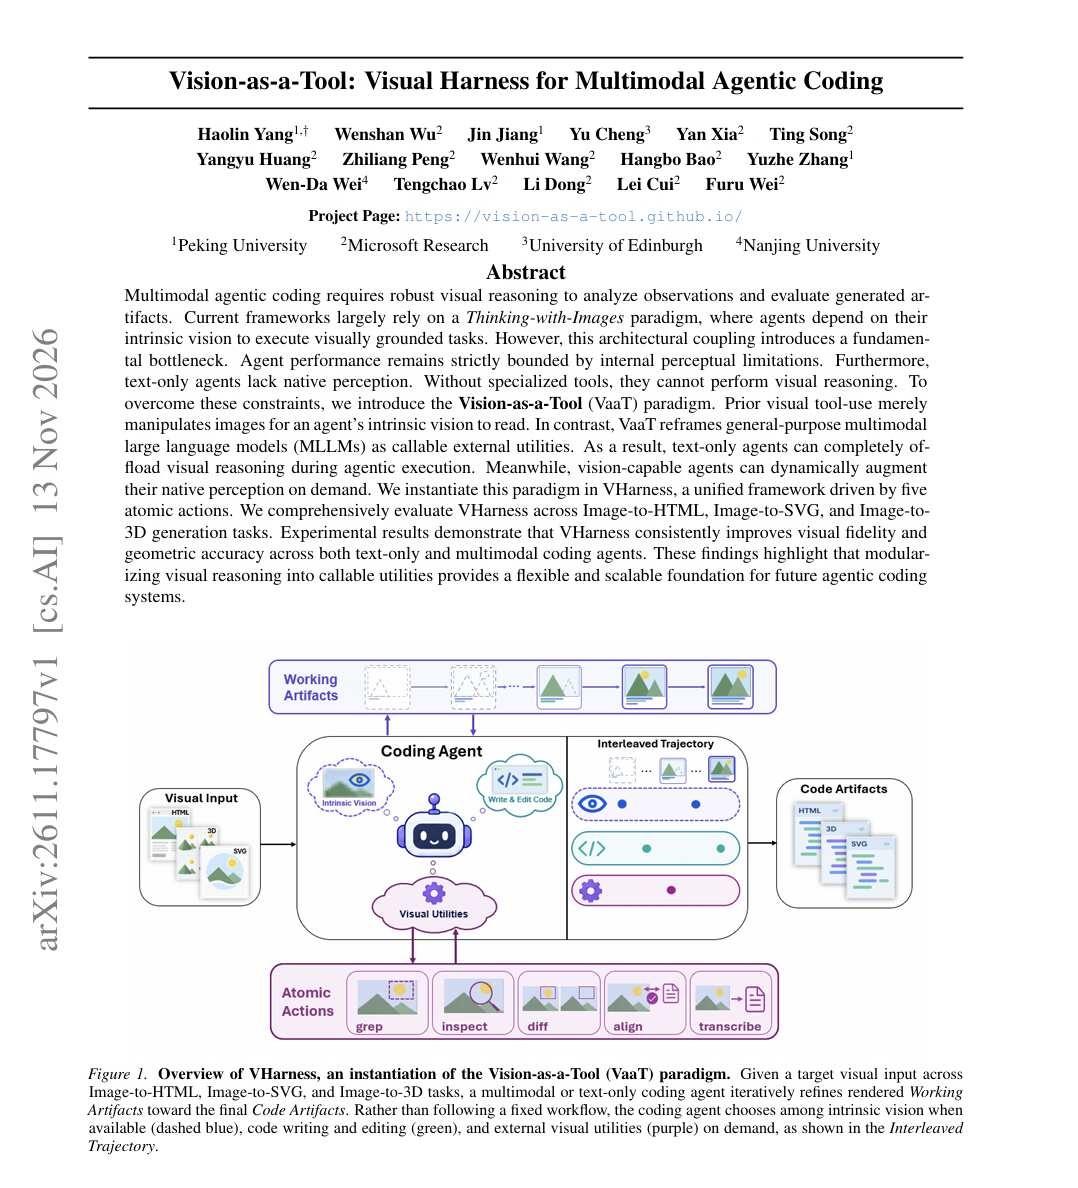
分享我们在北大、南大、爱丁堡大学与 MSRA 合作的最新工作 Vision-as-a-Tool (VaaT),把外部 MLLM 变成像 bash 一样随调随用的通用视觉工具。
💡 现有范式的硬伤
主流多模态编程大多遵循 Thinking-with-Images 范式——靠模型原生视觉看图改码,带来两个痛点:
1️⃣上限被自身视觉卡死,难兼顾顶级代码推理与细粒度视觉对齐;
2️⃣代码极强的纯文本模型因“看不见”被直接排除在外。
🛠️ 我们的解法:把视觉拆解为通用原子能力
我们提出 Vision-as-a-Tool 范式,彻底解耦“视觉感知”与“代码生成”,并将其在 VHarness 中实例化为 5 个直觉的视觉原子动作:
🔹 transcribe:提取全局结构,起草布局骨架
🔹 grep:精准定位目标视觉元素
🔹 inspect:局部放大,查询细节属性
🔹 align:视觉断言,检查局部渲染是否符合预期
🔹 diff:对比目标图与渲染图,定位差异
无需任何 task-specific workflow,Coding Agent 像敲终端命令一样按需调用即可完成任务。
📈 效果如何?
我们在易渲染验证的 Vision-to-Code 任务上进行了全面评测,横跨 Image-to-HTML、Image-to-SVG 和 3DCodeBench:
🔥 全模型跨任务一致涨点:GPT-5.5、GPT-5.6-sol、Claude Opus 4.8、GLM-5.3-Flash 接入后在所有指标上全面提升;哪怕在原生视觉极强的前沿模型 GPT-6-astra 上仍有稳定增益。
🔥 纯文本逆袭原生多模态:纯文本 Coding Agent GLM-5.2 装上 VHarness 后跑通全部任务,表现追平乃至反超原生多模态基线 GPT-5.5!
🎯 一句话总结
多模态Agent的突破口,或许是将视觉解耦抽象为bash般正交原子操作。
多模态大模型 codingagent llm 论文分享 科研 ai