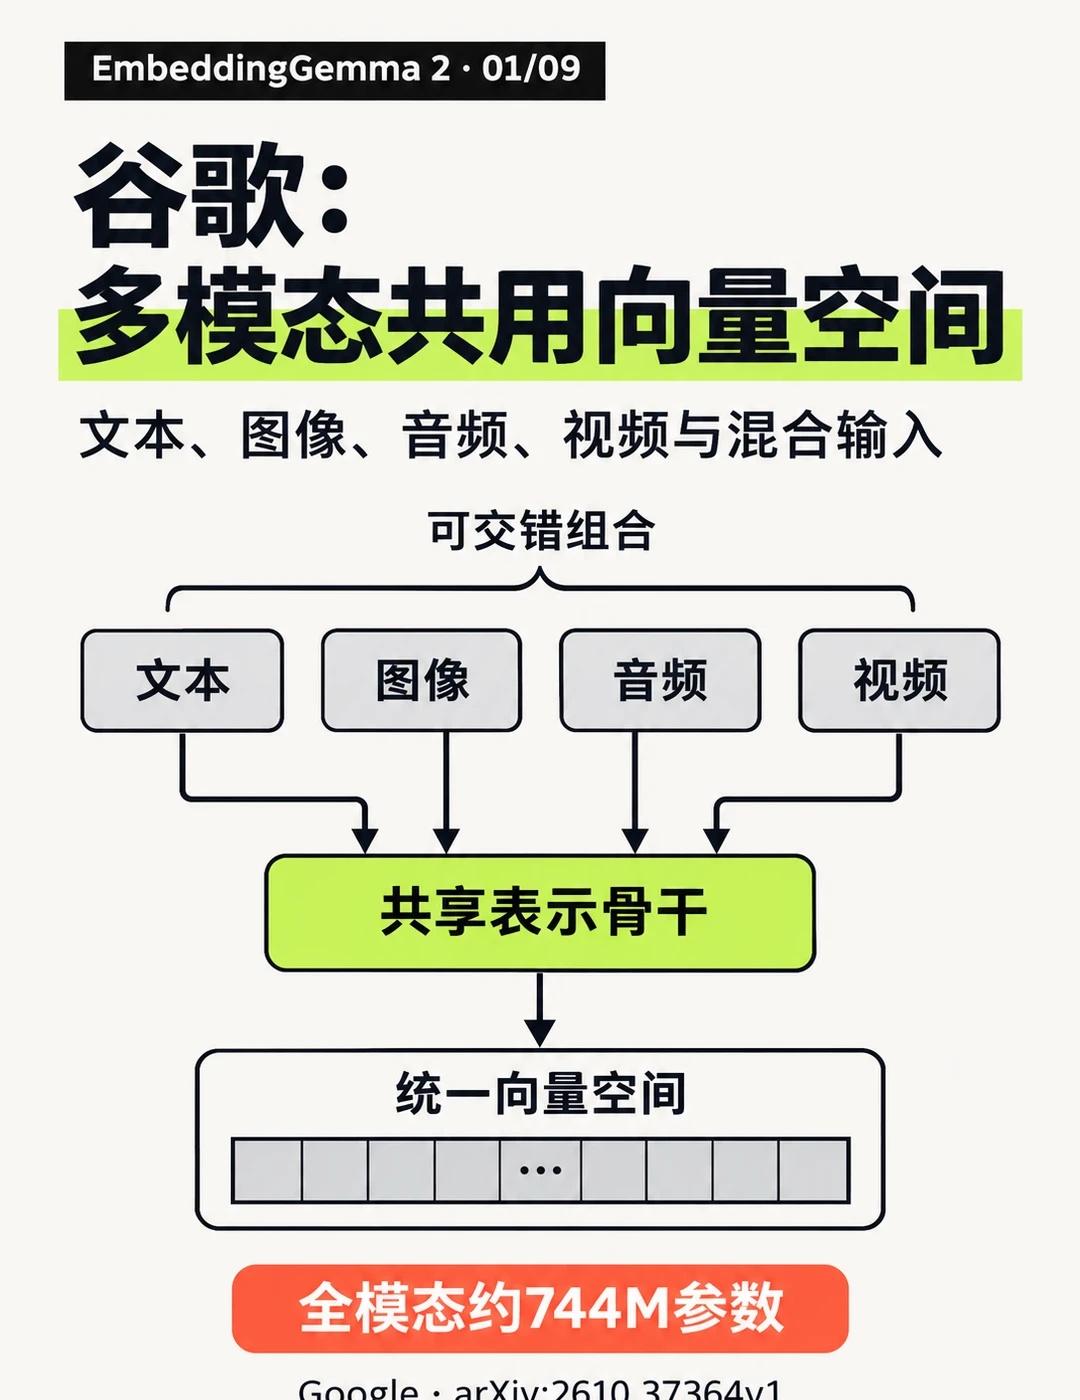
谷歌:多模态共用向量空间
图文影音,能共用一套检索表示吗?
📄论文:EmbeddingGemma 2: Unified and Efficient Multimodal Representations
🏢单位:Google EmbeddingGemma团队
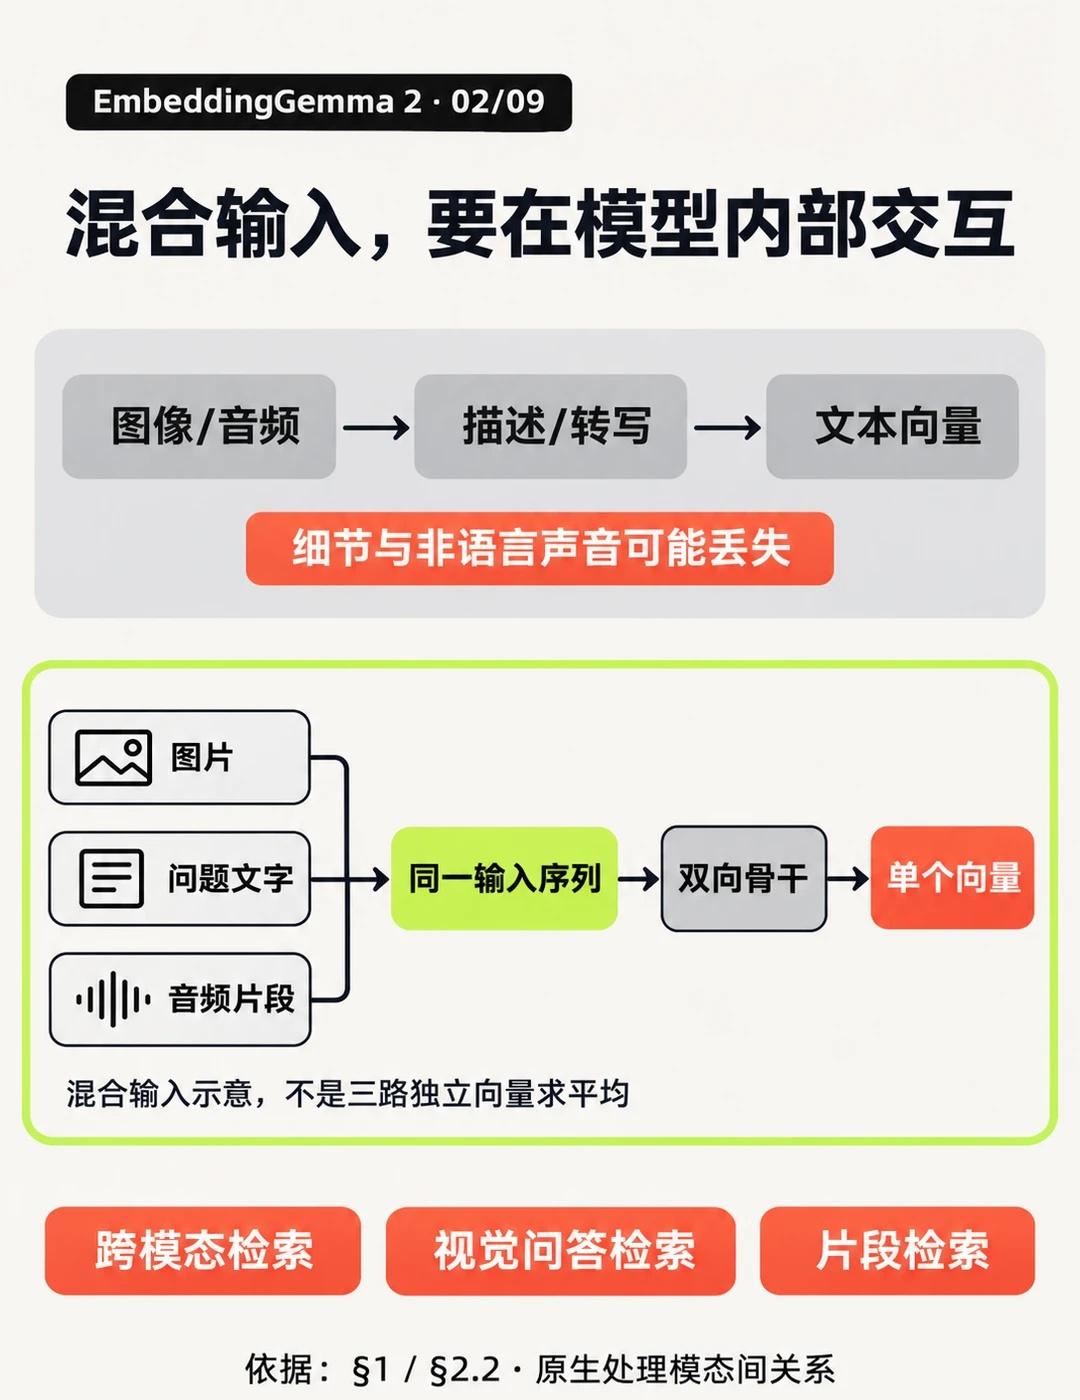
【问题】先转写或描述再检索会丢细节,大型多模态模型又增加资源负担。
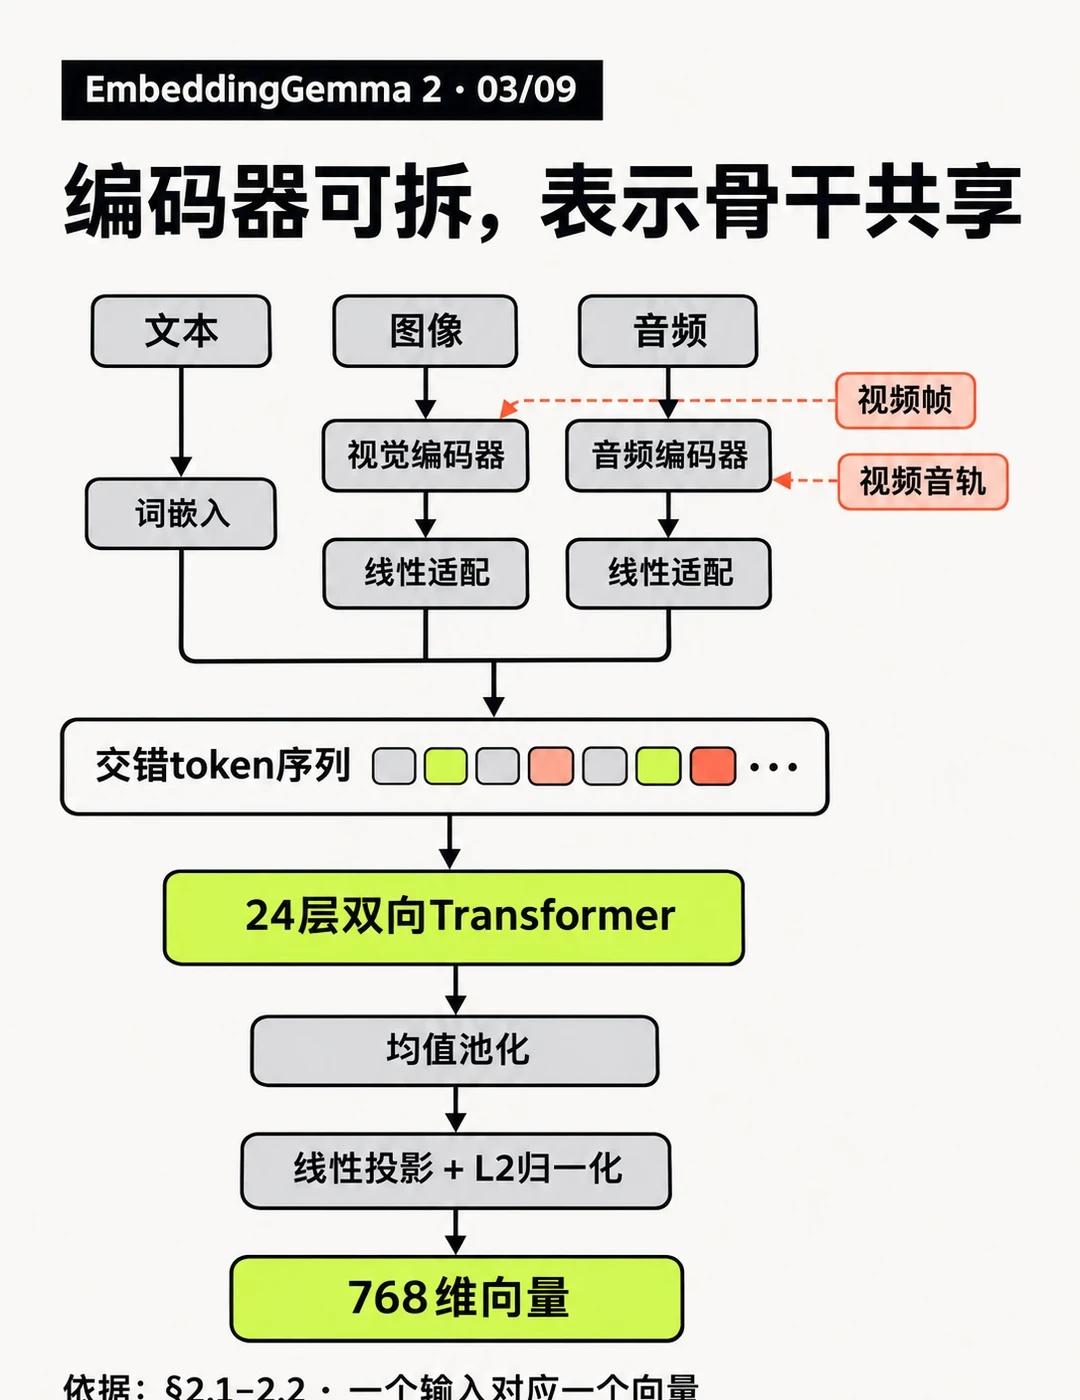
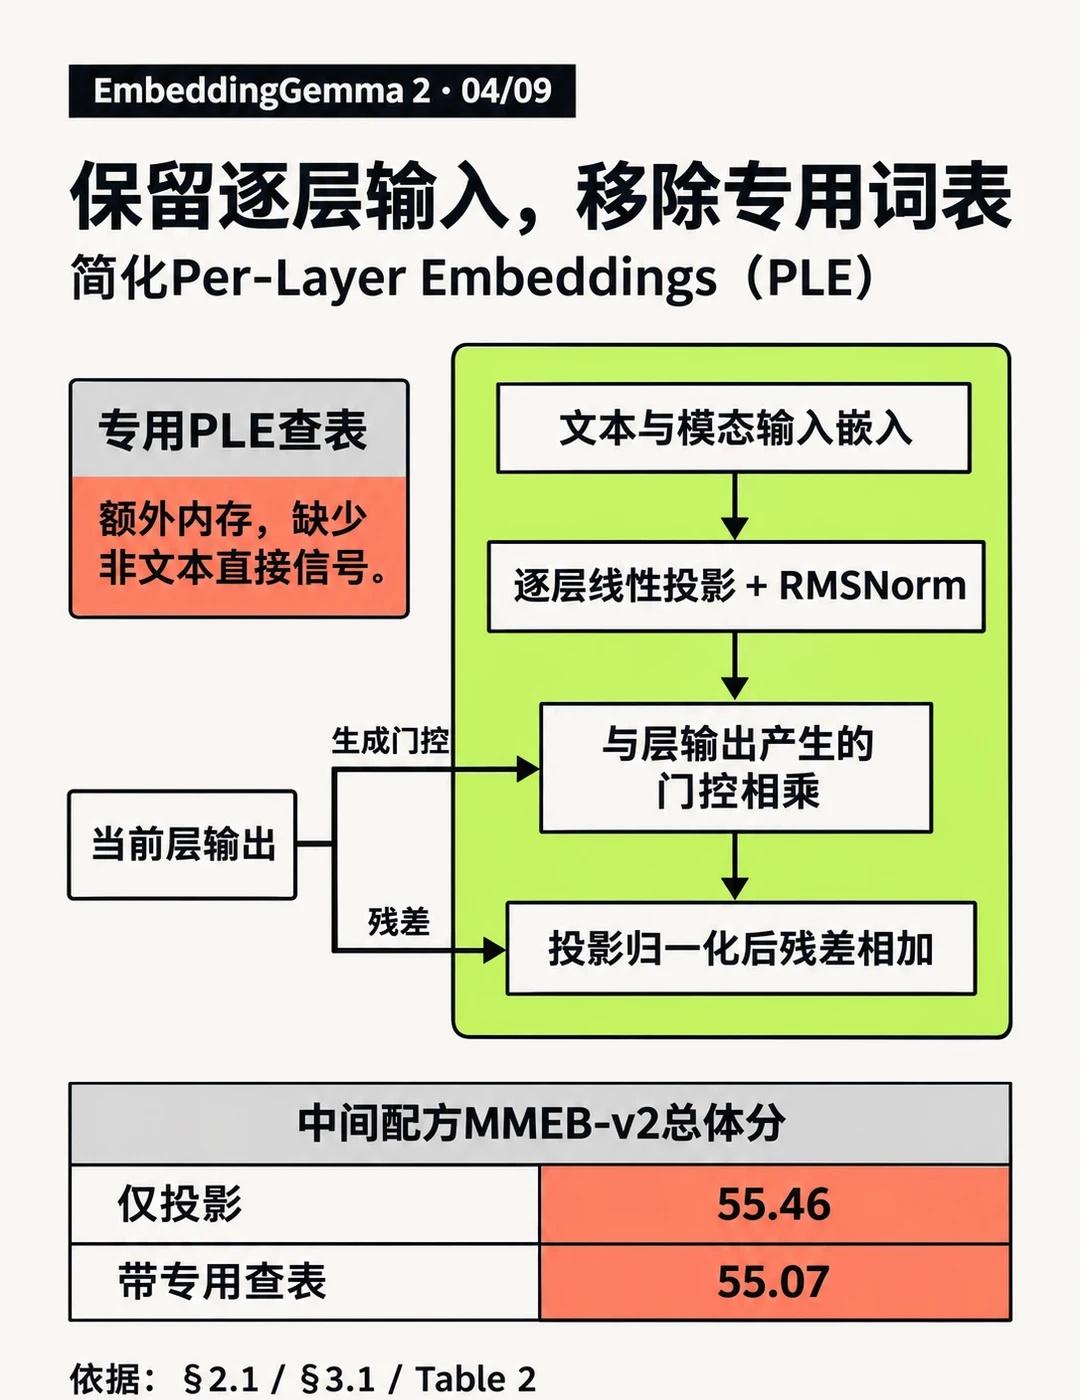
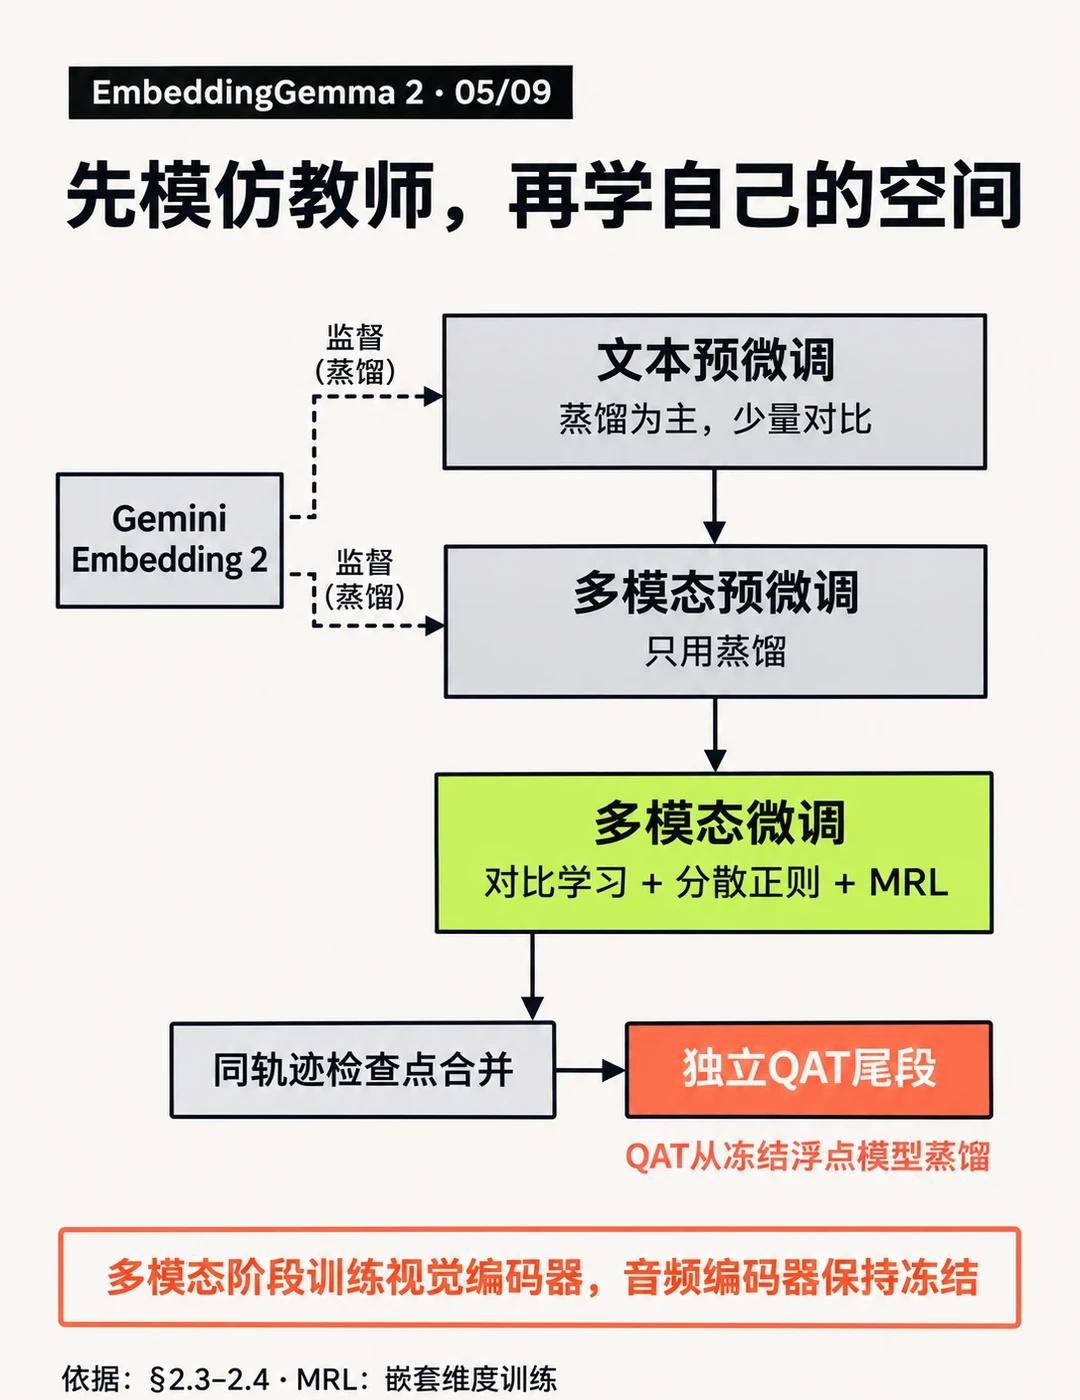
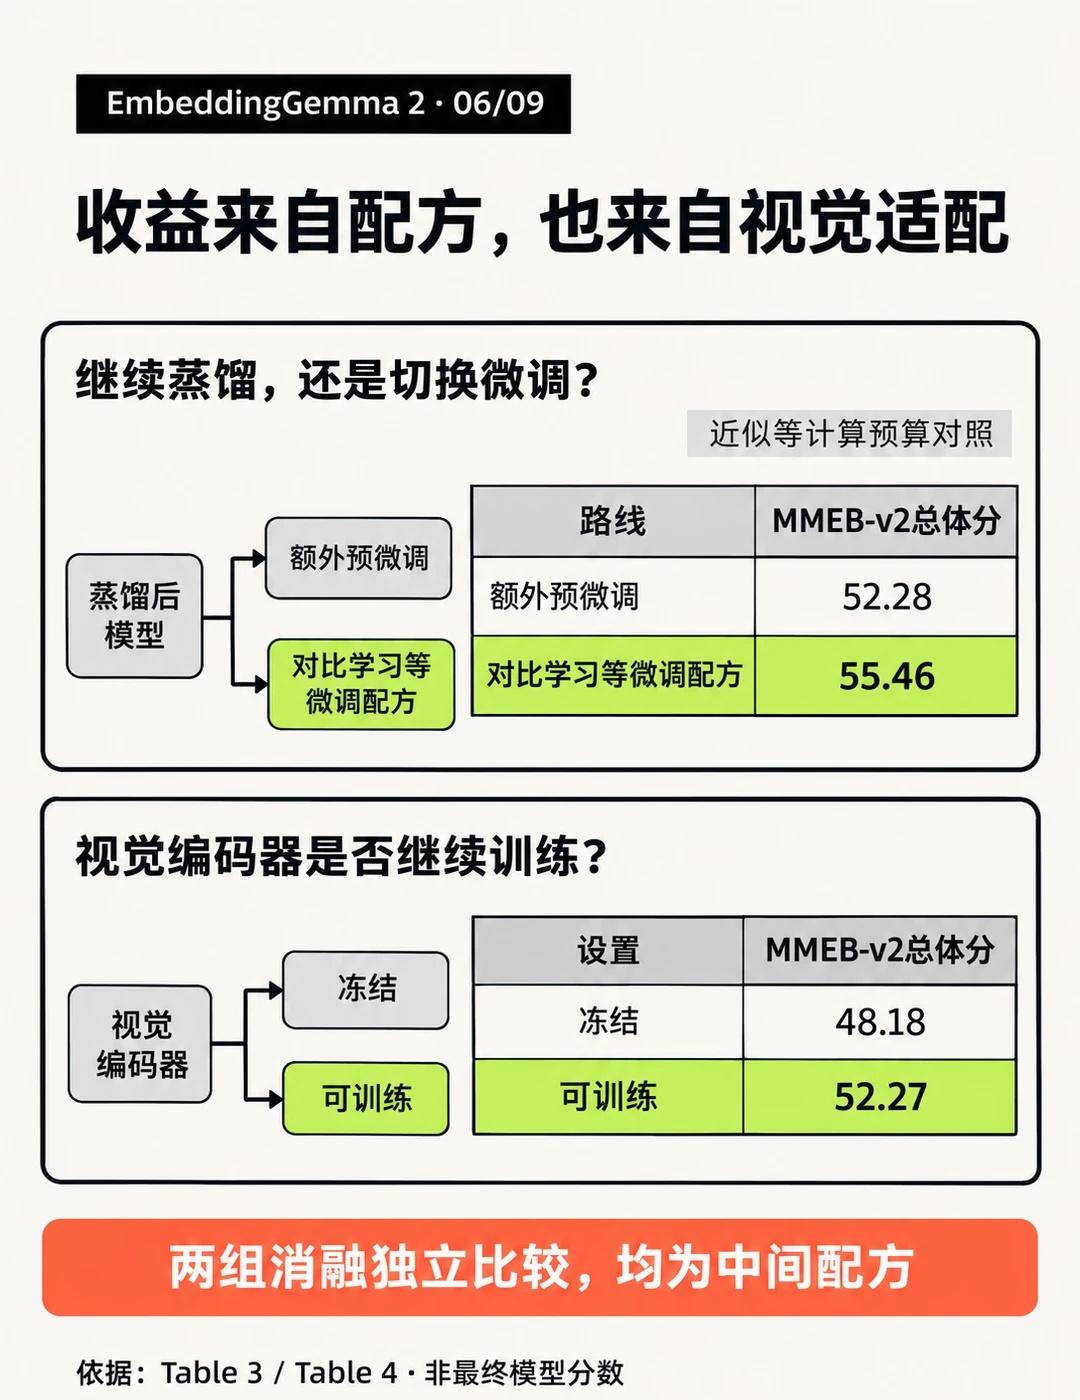
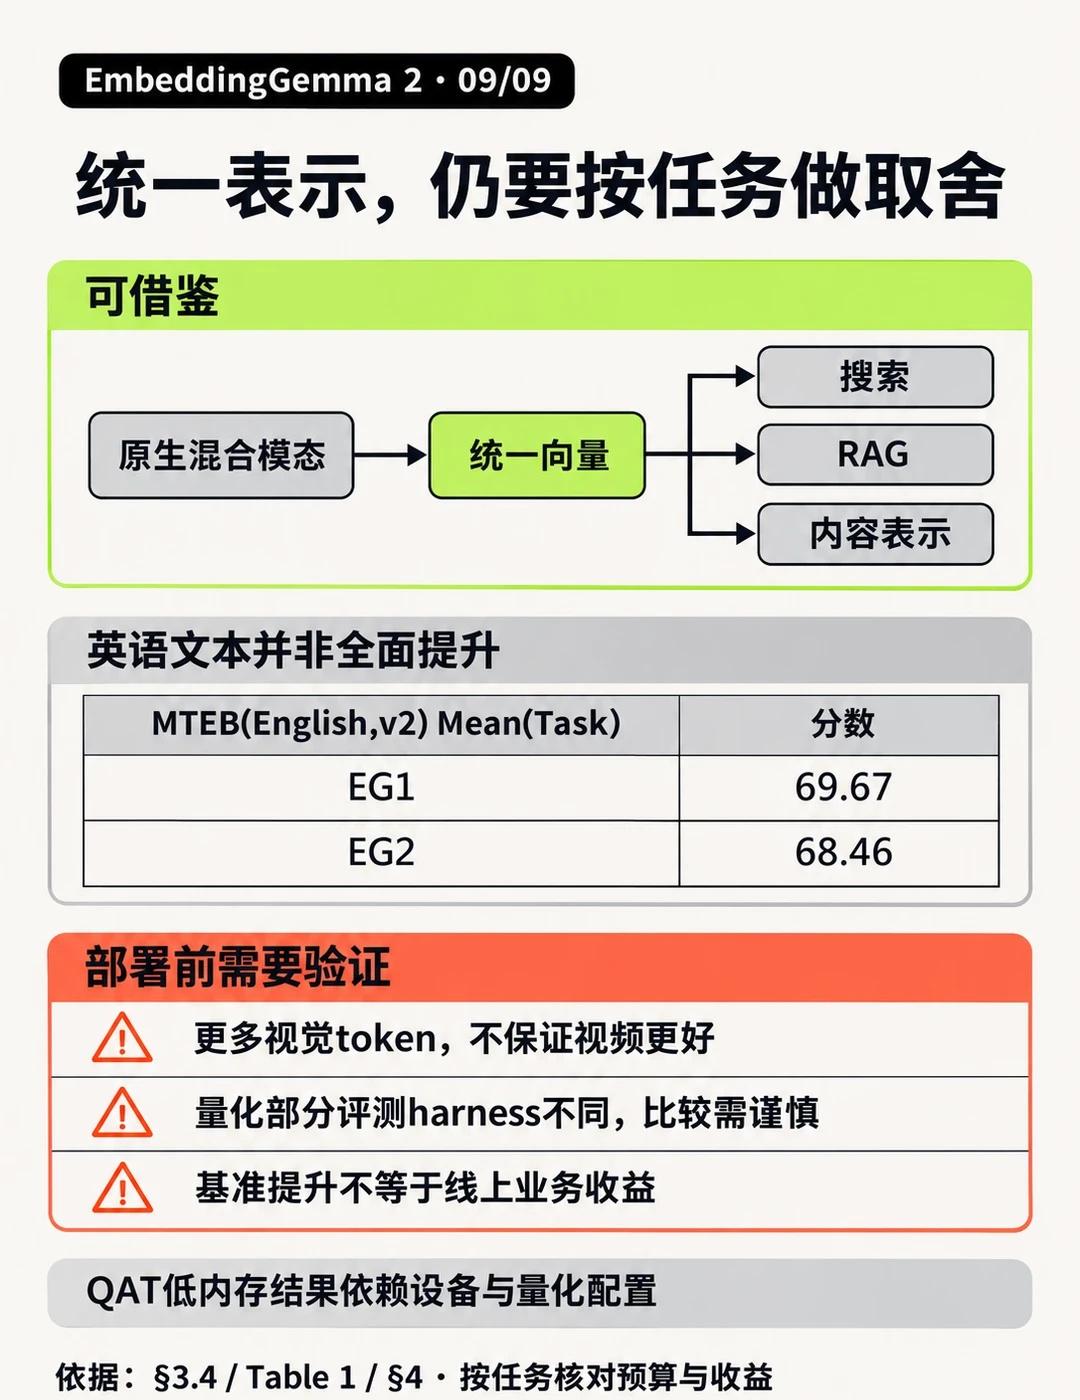
【方案】文本与视觉、音频编码结果交错进入共享双向骨干,经池化输出统一向量。训练先蒸馏Gemini Embedding 2,再转向对比学习、分散正则与嵌套维度训练。
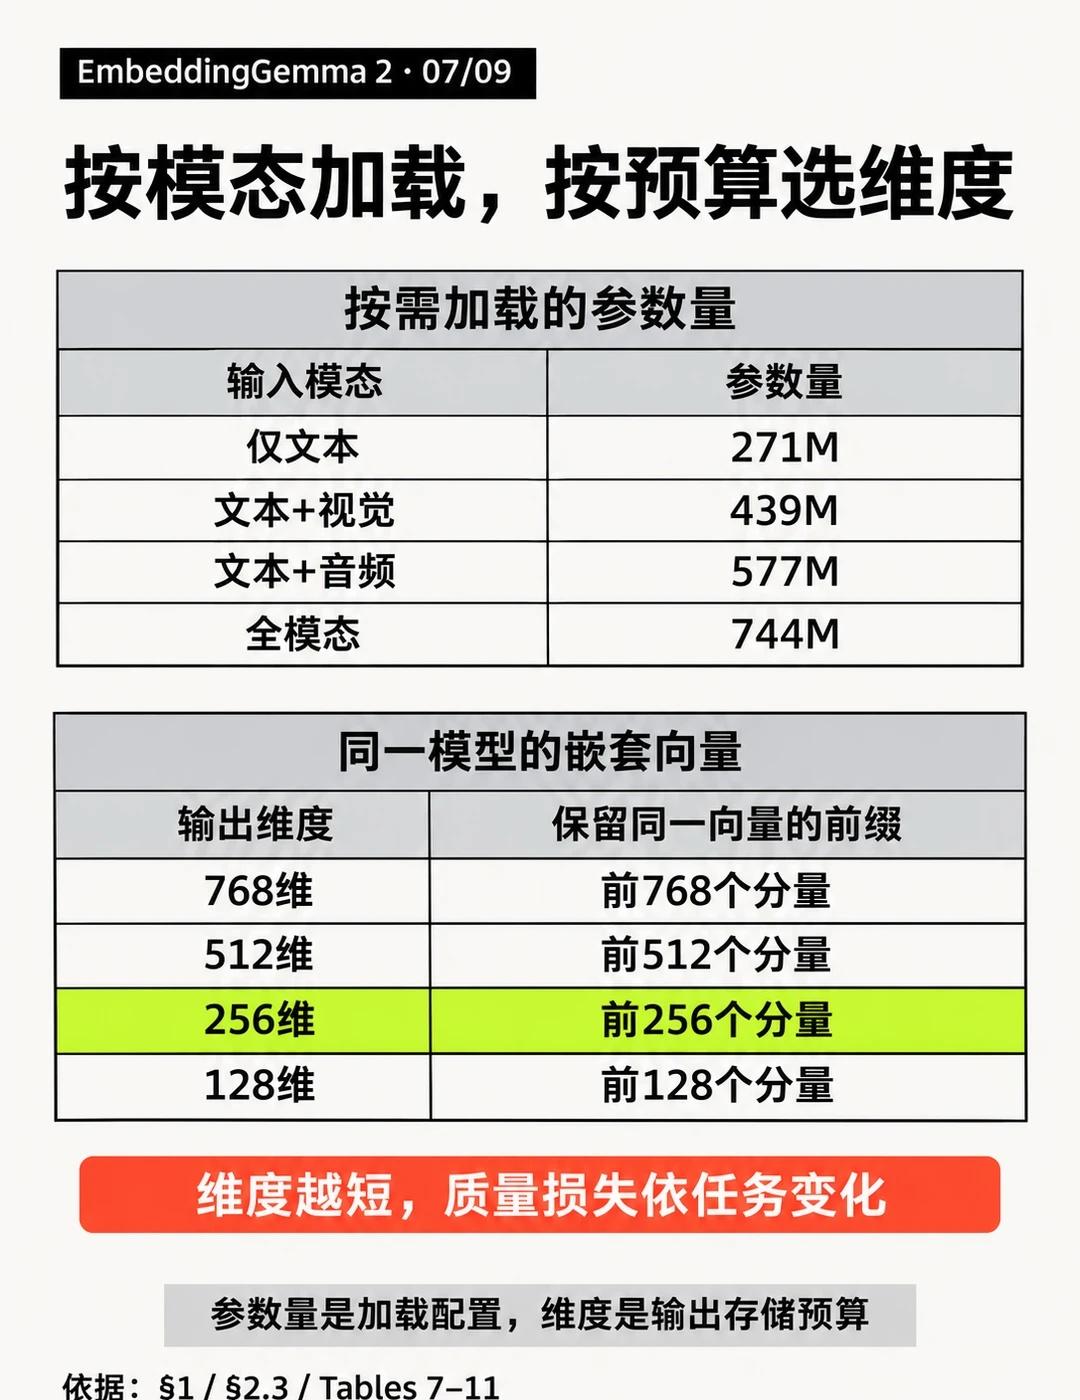
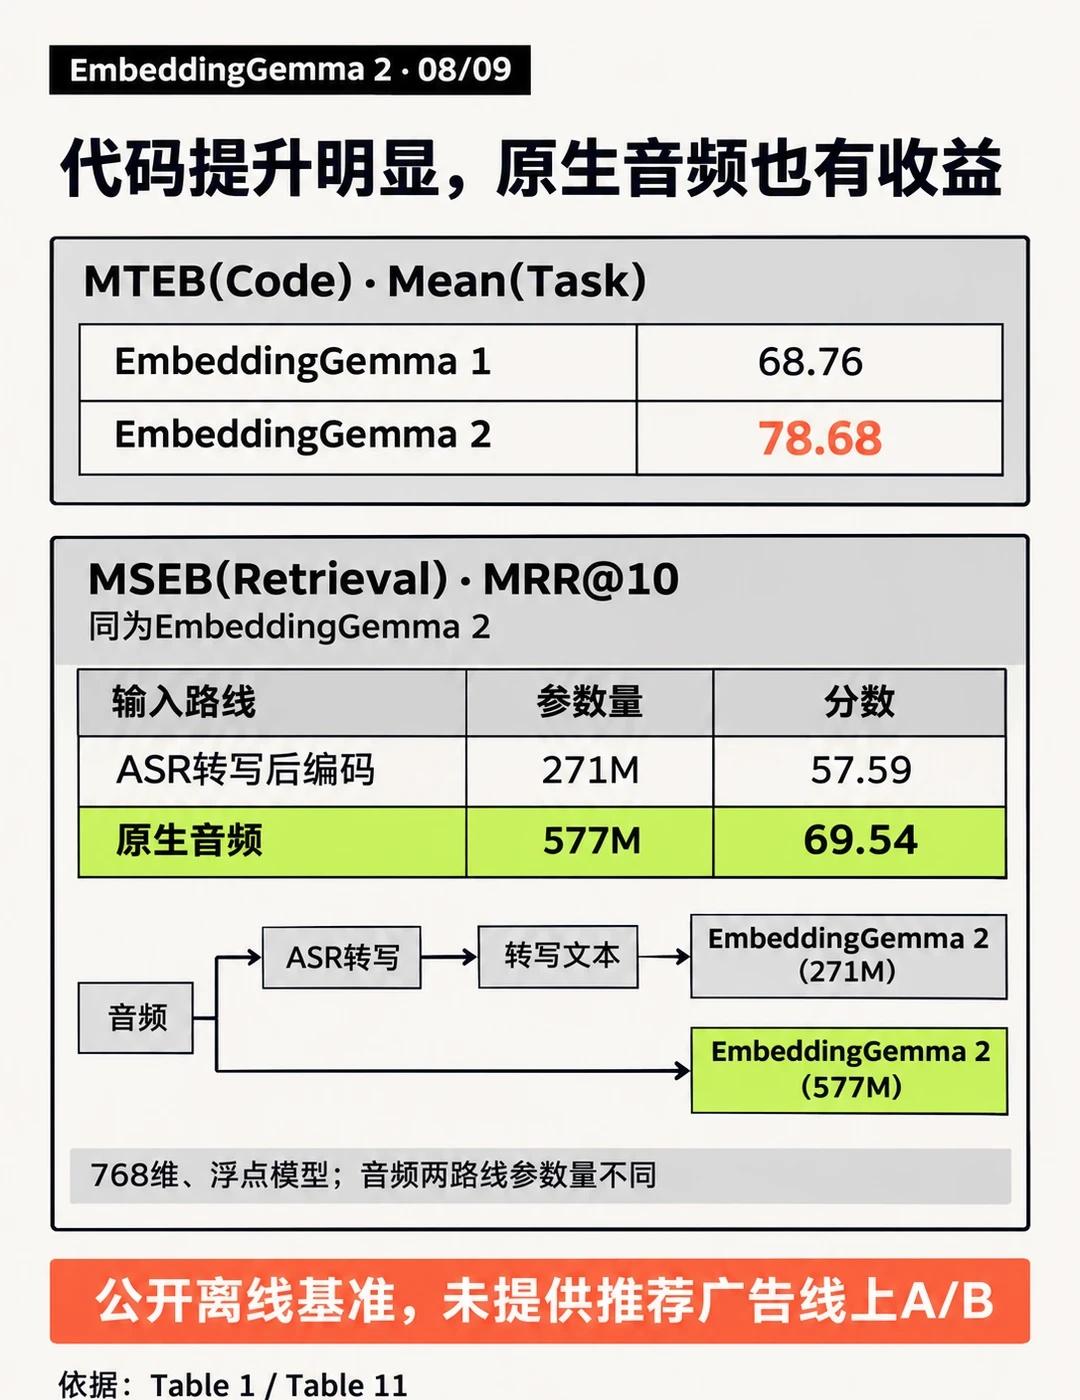
【贡献】全模态约744M参数,可按需加载编码器,支持四档向量维度与量化权重;MTEB(Code)平均分由上一代68.76升至78.68。
【价值】可作多模态搜索、RAG和内容表示底座;英语基准略回退,短向量与视觉预算需按任务验证,尚无推荐广告线上A/B。
多模态检索 向量检索 Embedding RAG 表示学习 端侧AI 论文阅读 论文分享 机器学习