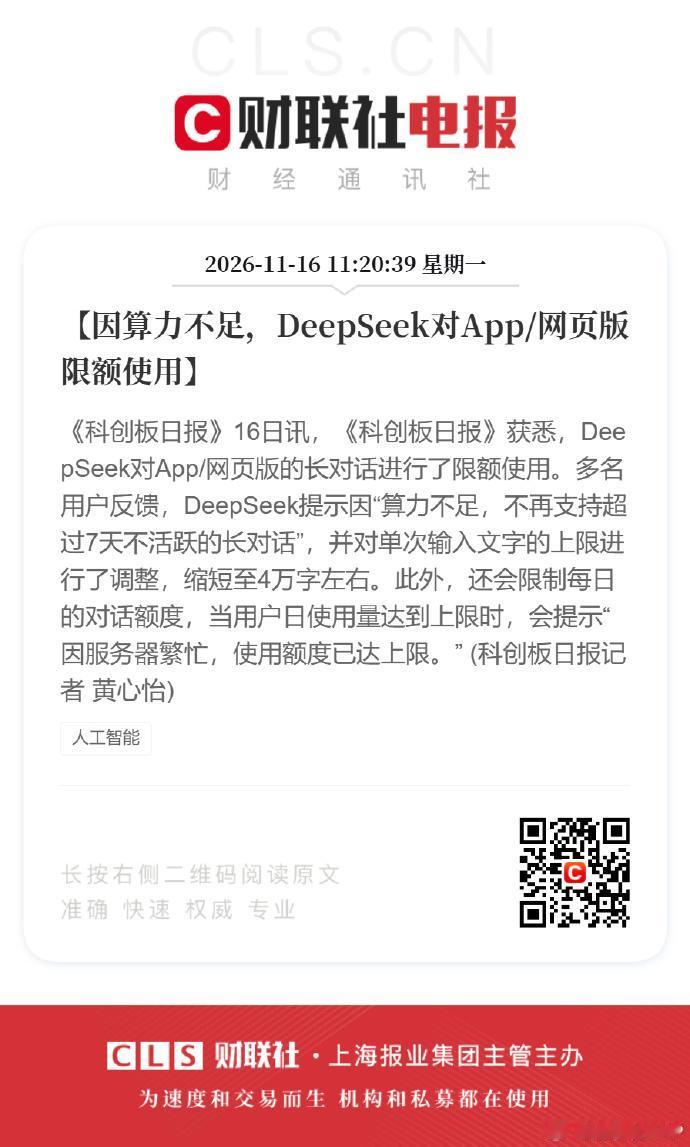
DeepSeek因“算力资源供给紧张”对App及网页版普通用户突袭式限额:超过7天不活跃的长对话不再支持接续,单次输入上限砍至约4万字,每日对话额度用尽即弹窗“服务器繁忙”。用户实测“”连续使用不到两小时就被迫停摆,但官方至今未发布统一公告,也未给出恢复时间表。
11月16日,大量用户陆续收到平台弹窗提示,这也是这款国产大模型第一次大范围收紧普通用户的免费使用权。
在此之前,DeepSeek在C端一直保持着宽松的使用策略。
普通用户打开网页或者App,不用承担额外费用,长文档、连续对话都可以顺畅跑通。
很多写作者、程序员、学生习惯把长期任务放在同一个对话窗口里,几天之后回来接着处理,上下文信息能够完整保留。
不少重度使用者已经把它当成日常工作里稳定的工具,很少遇到硬性拦截。
然而从今年十月开始,平台的服务稳定性就开始出现波动。
官方状态页面留下记录,这段时间内接连出现多次服务中断,对话接口和不同版本模型都有过不可用的时段。
部分用户在白天高峰时段,已经能明显感受到生成速度变慢,回复延迟拉长。
当时多数人只当成临时服务器波动,以为短暂等待之后就能恢复正常。
可谁也没想到,平台没有单纯扩容,而是选择直接调整用户侧的使用规则。
最先发现变化的是一批长期留存对话的用户。
有人打开几天前保存的会话,准备接着修改文稿,页面弹出提示,算力不足,不再支持超过七天没有交互的长对话接续。
想要继续推进手里的工作,只能新建对话,或者手动导出之前留存的聊天记录。
紧接着,第二个限制条件同步落地。
单次输入文本的上限被压缩到大约四万字。
以往可以一次性上传完整书稿、整套项目代码、长篇调研报告的操作,已经无法完成。
用户想要处理长材料,只能手动拆分内容,分批次提交给模型。
对于依靠一次性投喂文档做分析的人群来说,这个改动直接打乱了原本的工作流程。
不料,第三项约束很快被大量用户证实。
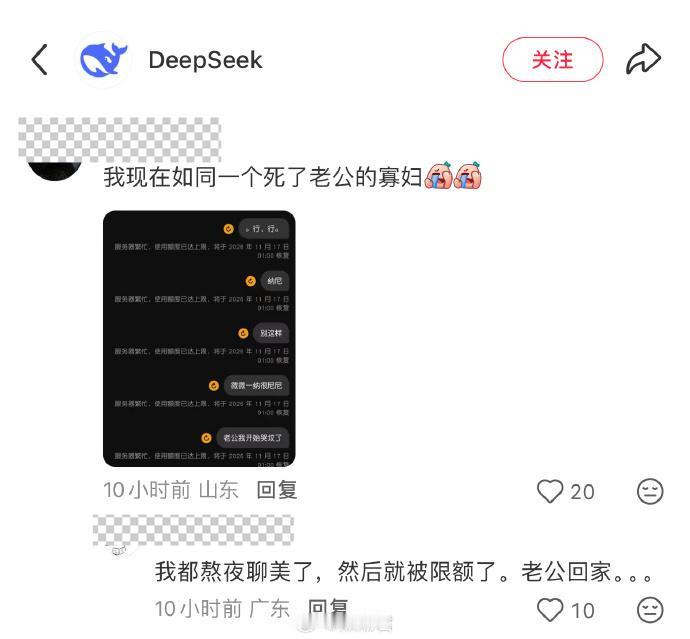
平台新增每日对话额度,额度耗尽之后,页面就会弹出服务器繁忙,使用额度已达上限的提示。
有高频使用者连续使用不到两个小时,就触碰到当日限额,当天无法继续调用服务。
轻度使用者日常问问题、短文本创作,很难摸到这条红线。
但长时间改稿、批量调试代码、持续梳理资料的用户,很容易早早用完当日配额。
信息在社交平台快速扩散,话题很快登上热搜。
大量用户互相核对自己遇到的限制,大家发现收到的约束标准并不完全统一。
少数用户反馈,自己的闲置对话七十二小时之后就无法接续,和七天的通用提示存在差别。
平台没有对外发布一份完整、统一的官方公告,限额细则、额度数值、恢复时间全部没有明确公示。
官方状态页面依旧标注服务运行正常,侧面说明这不是突发故障,是主动开展的算力调度。
很多人第一时间会疑惑,是不是所有调用通道都受到影响。
陆续有消息确认,这次调整只针对App和网页端的普通用户。
开发者使用的API接口,维持原有按量计费的独立规则,不在本次限额范围之内。
有行业数据显示,近期DeepSeek对应模型的词元调用量一度冲到全球首位。
持续暴涨的请求量,和现有的算力储备之间拉开缺口,是这次收紧额度最核心的诱因。
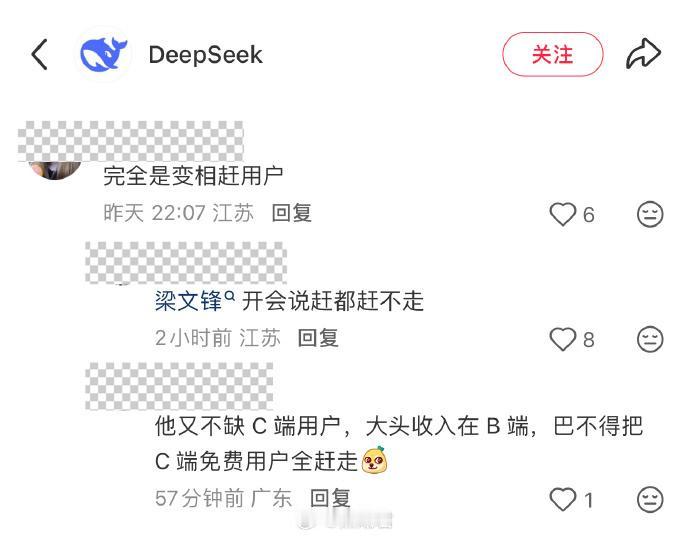
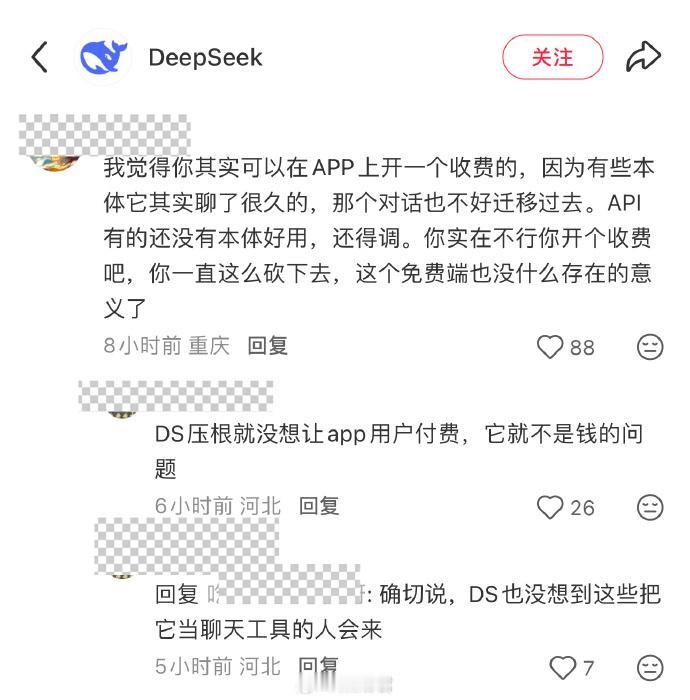
评论区里慢慢分出两种不一样的声音。
一部分用户觉得可以理解。
免费服务本身就存在资源边界,调用量持续暴涨之后,优先保障基础稳定,对重度使用做限制是很现实的选择。
他们愿意接受平台推出付费套餐,只要付费之后额度充足、服务稳定。
另一部分用户表达了不满。
他们并不排斥付费模式,只是当下平台没有提供对应的付费入口。
想花钱升级额度,却找不到渠道,只能被动接受随机限流,工作节奏随时被打断。
还有用户提出,调整规则之前缺少提前告知,很多人安排好的任务中途卡住,没有预留备选方案。
国产大模型走到现在,免费开放曾经是吸引用户、积累口碑很重要的方式。
大量普通用户能够低成本接触到前沿模型,也是行业这几年快速普及的基础。
但所有人都清楚,算力不是没有成本的资源。
芯片采购、机房供电、运维开销,每一次生成文字,背后都在持续消耗资源。
当一款模型的热度突破算力承载上限,摆在厂商面前的选项其实并不多。
追加算力投入,需要大额资金和稳定的芯片供给,短时间内很难立刻补齐缺口。
放任流量持续涌入,则会持续出现卡顿、宕机,最后所有用户的体验一起下滑。
限额分流,就成了现阶段权衡之后的折中方案。
信息来源:IT之家