小米今日官宣开源轻量级文档理解模型 Xiaomi-OCR-0,模型权重与推理代码已同步上线 Hugging Face 和 GitHub:
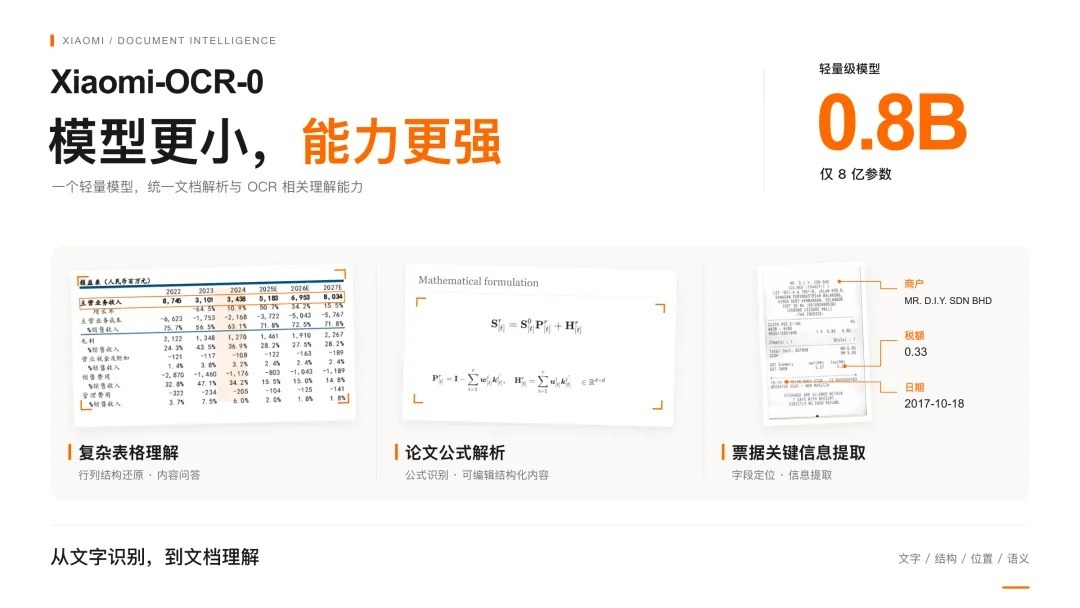
参数规模 0.8B,目标用单一模型同时覆盖文档解析、关键信息抽取与 OCR 视觉问答三类任务。文档解析方向可识别正文、表格与数学公式,按阅读顺序输出结构化结果,原生支持 Markdown、LaTeX;关键信息抽取面向发票、收据、卡证和业务表单,按指定字段定位并输出 JSON 等结构化数据,可直接接入自动化处理流程;OCR 视觉问答则支持围绕文档与图表做跨区域检索、数值计算和语义推理,而不只是文字转写。据小米介绍,这一组合打通了从底层文字感知到高层内容理解的链路。
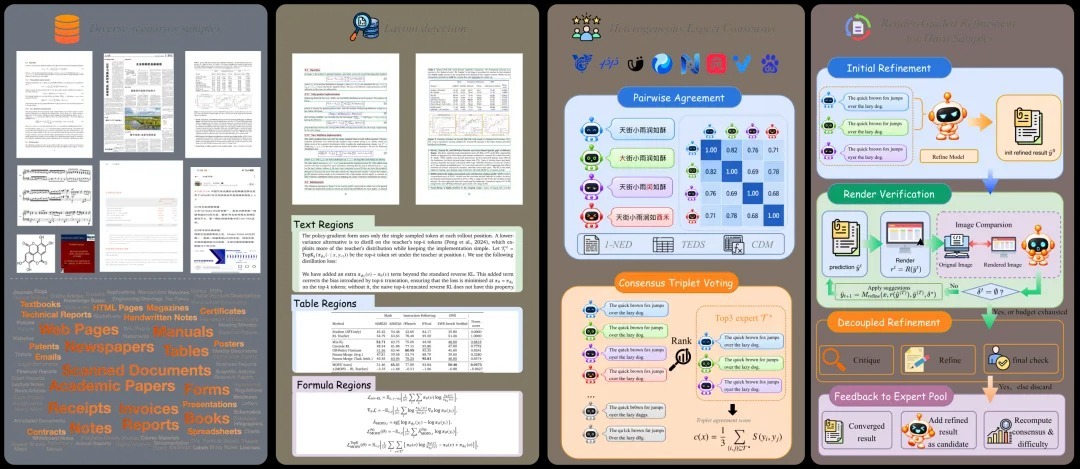
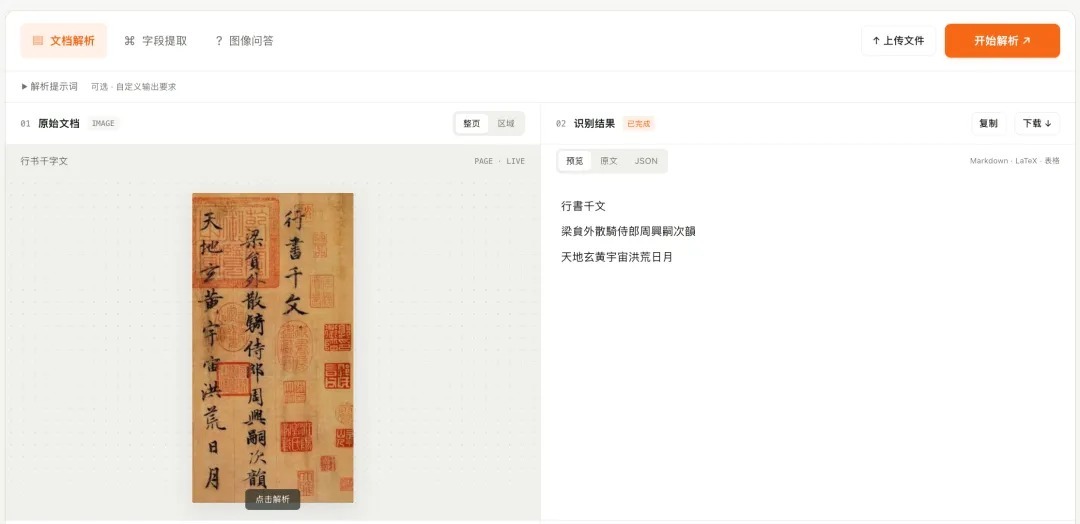
模型基于 Qwen3.5-0.8B-Base 基座构建,训练累计使用约 1.7 亿条 OCR 与文档理解样本。数据侧采用异构专家共识机制,对正文、表格、公式等不同区域由多个 OCR 专家模型交叉校验、投票筛选高置信标注。针对复杂表格与公式,团队引入“预测—重渲染—视觉比对”闭环校验,把候选解析结果重新渲染为图像,与原文档区域做像素和结构级比对,定位行列错位或符号缺失后定向修正;同时按版面复杂度、字体形态与物理退化因素合成困难样本,补充多语种、古籍手写、屏幕摩尔纹与扭曲光照等长尾数据。
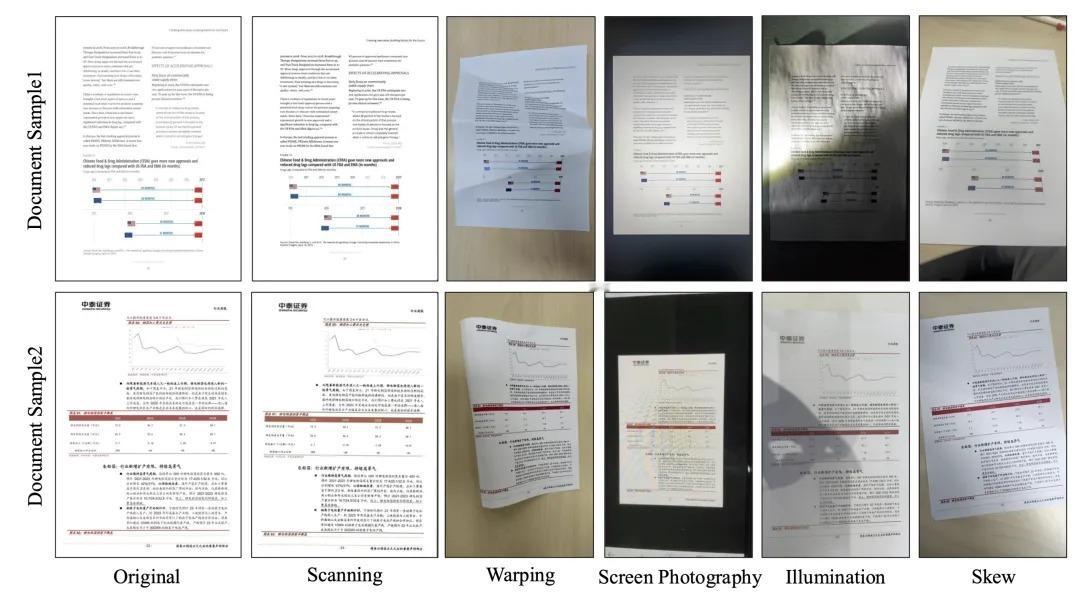
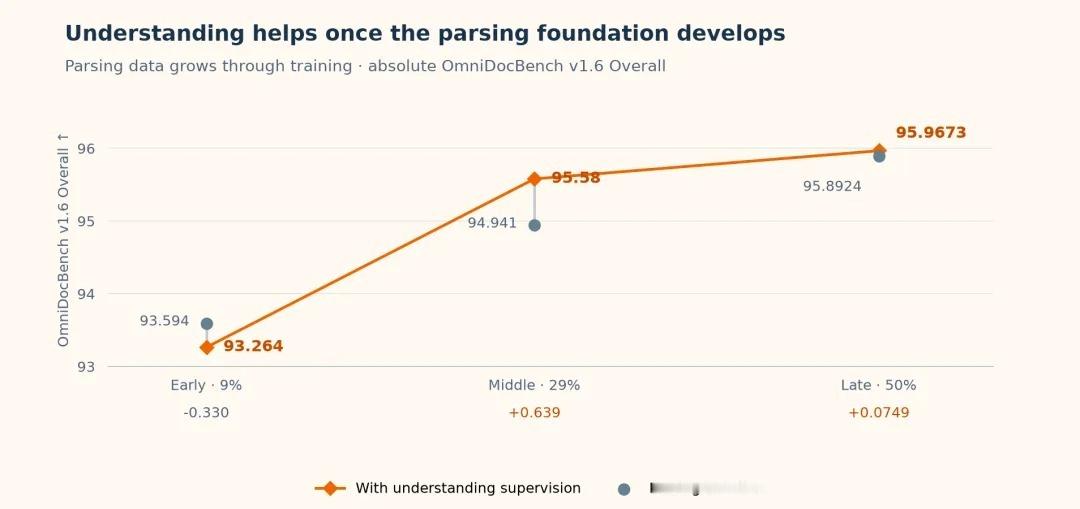
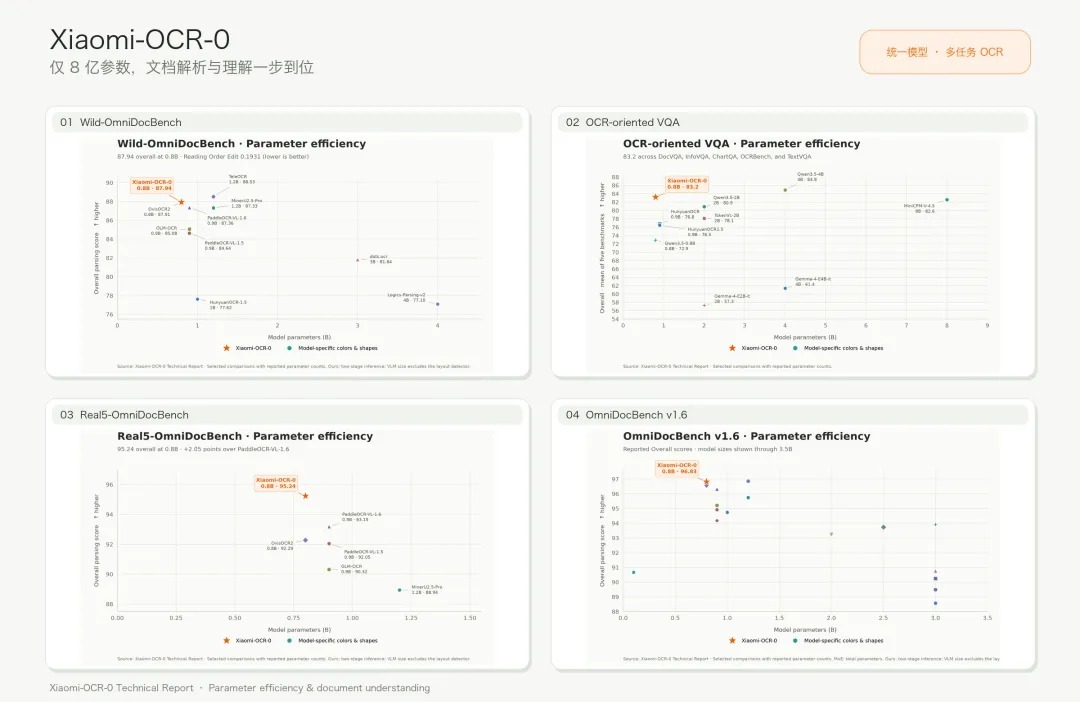
评测方面,在模拟扫描、纸张弯曲、屏幕翻拍、光照变化和倾斜拍摄五种真实采集方式的 Real5-OmniDocBench 上,Xiaomi-OCR-0 得分 95.24 分,在对比模型中排名第一;Wild-OmniDocBench 得分 87.94 分。综合基准 OmniDocBench v1.6 得分 96.83 分,位列总榜第二,与榜首相差 0.04 分,在 1B 以下参数模型中排名第一。专项测试中,数学公式识别基准 UniMER-Test 为 97.84 分,表格结构识别基准 PubTabNet 为 92.27 分。古籍与书法评测集 Chronicles-OCR(Mature Scripts)得 73 分,小米称该成绩与闭源模型 Seed 2.0 Pro 的 72 分处于同一水准。
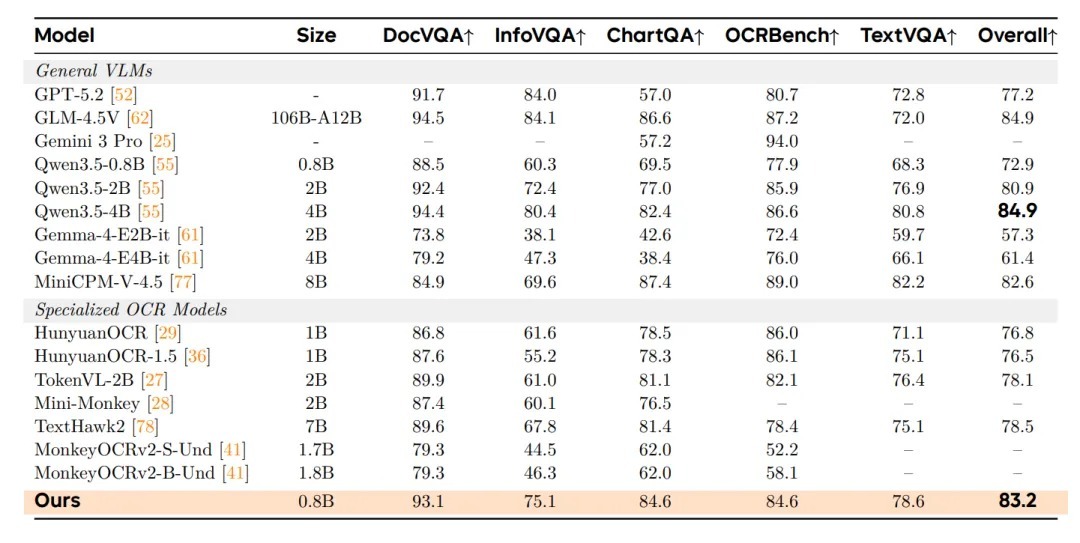
文档理解方面,DocVQA、InfoVQA、ChartQA、OCRBench 和 TextVQA 五项基准平均分为 83.2 分,高于 HunyuanOCR-1.5(1B,76.5 分)、TokenVL-2B(2B,78.1 分)和 TextHawk2(7B,78.5 分);同一组对比中,通用多模态模型 Qwen3.5-2B 为 80.9 分,MiniCPM-V-4.5(8B)为 82.6 分,Qwen3.5-4B 为 84.9 分。
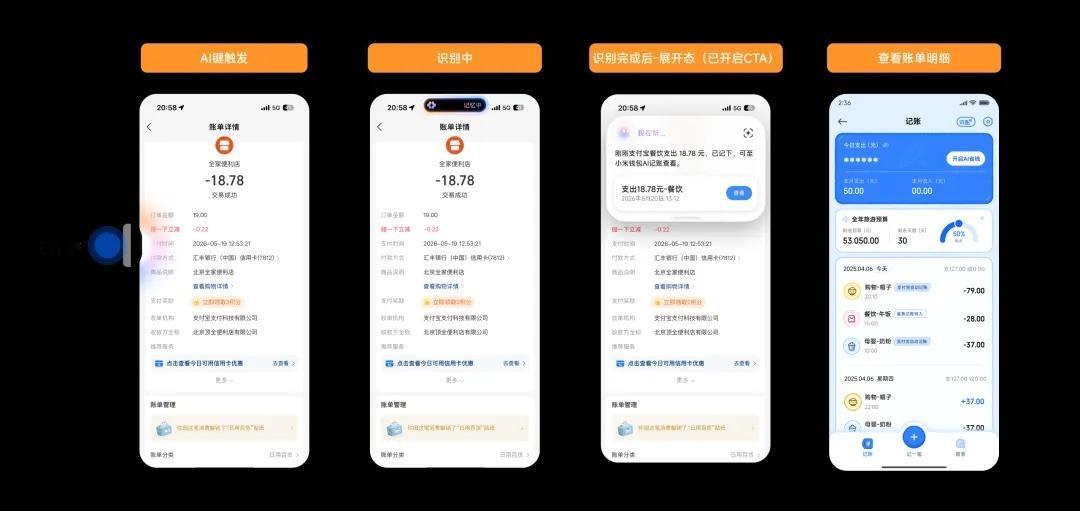
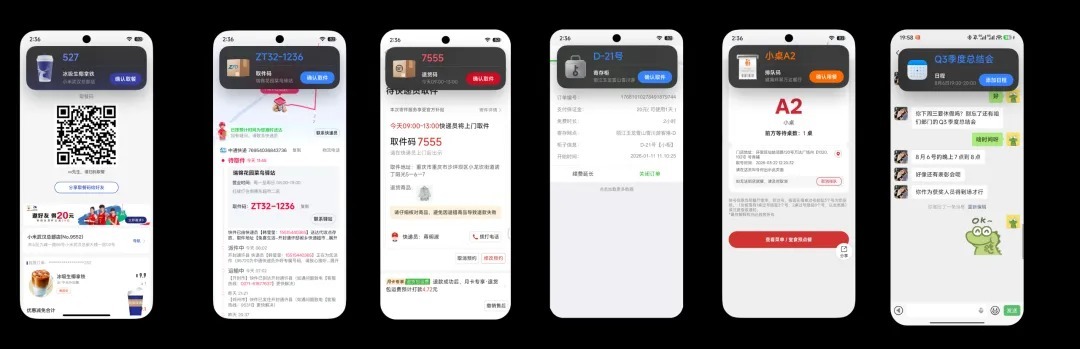
落地层面,小米表示相关技术已应用于手机端“超级小爱”。用户短按 AI 键、三指上滑或语音指令,可提取屏幕中的外卖取餐码、快递取件码、排队号等时效性信息并置于醒目位置;账单与卡证场景下,识屏可抽取交易金额、商户名称、支付时间与消费类别用于智能记账,纸质发票、身份证、银行卡等也可通过拍照完成字段提取;日程与出行场景中,系统能识别群聊会议通知或海报上的时间地点并生成日程卡片。