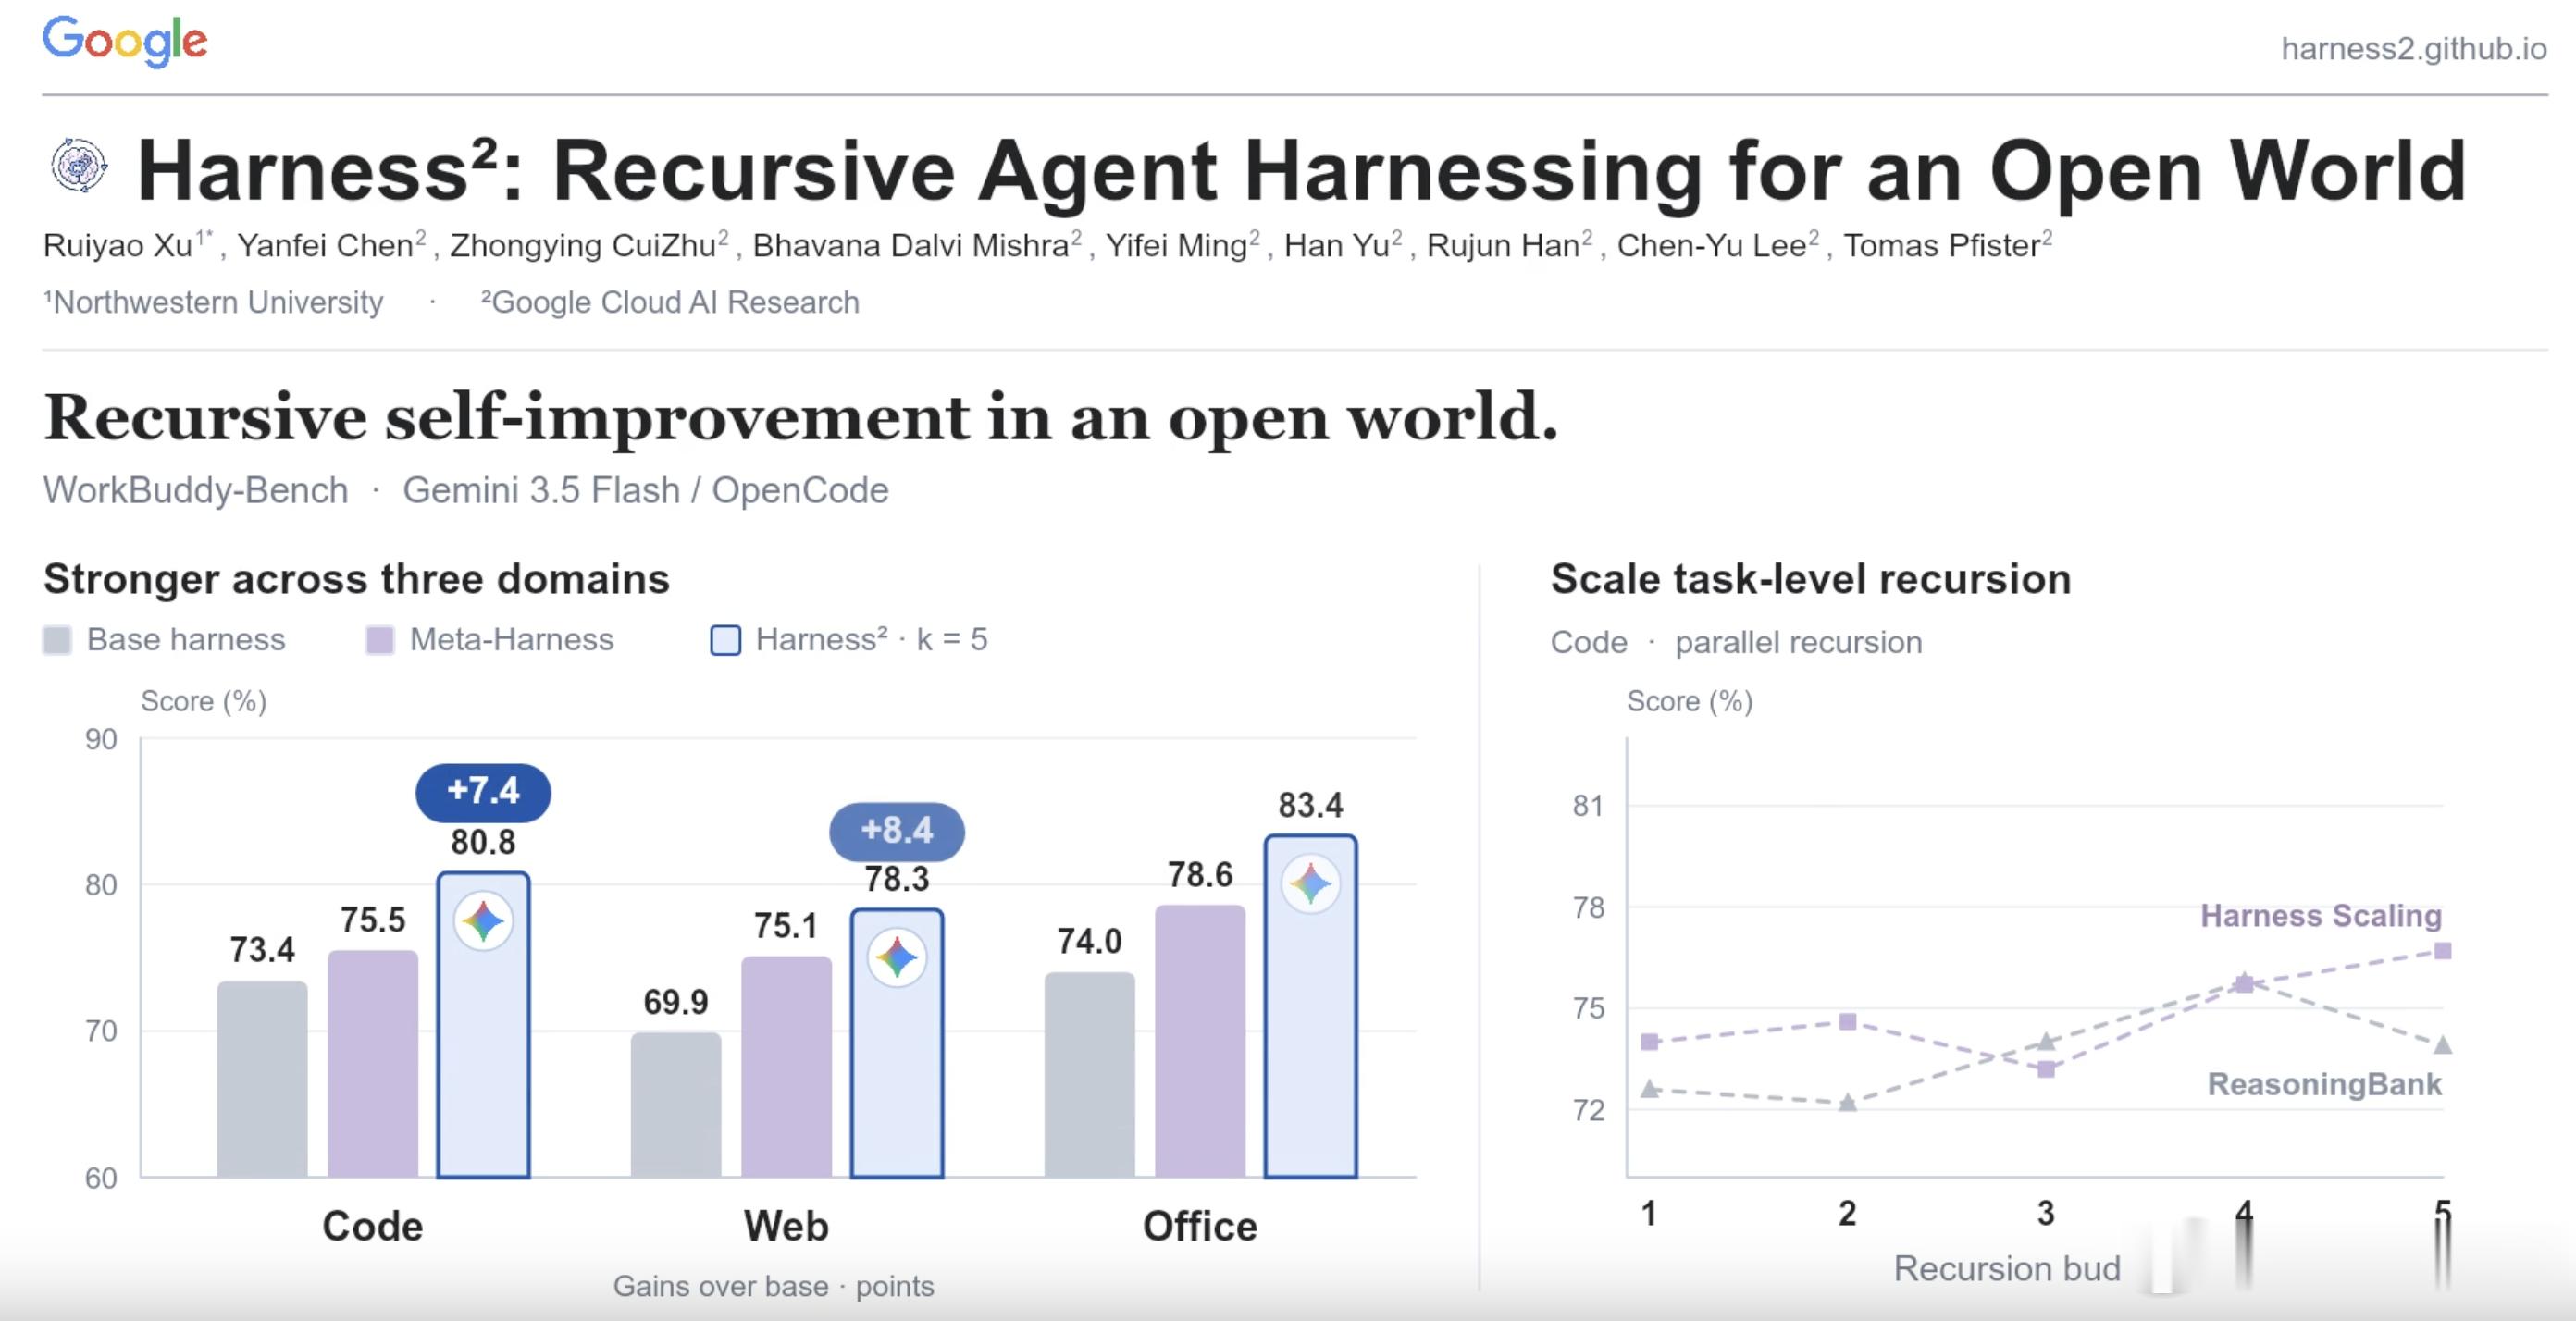
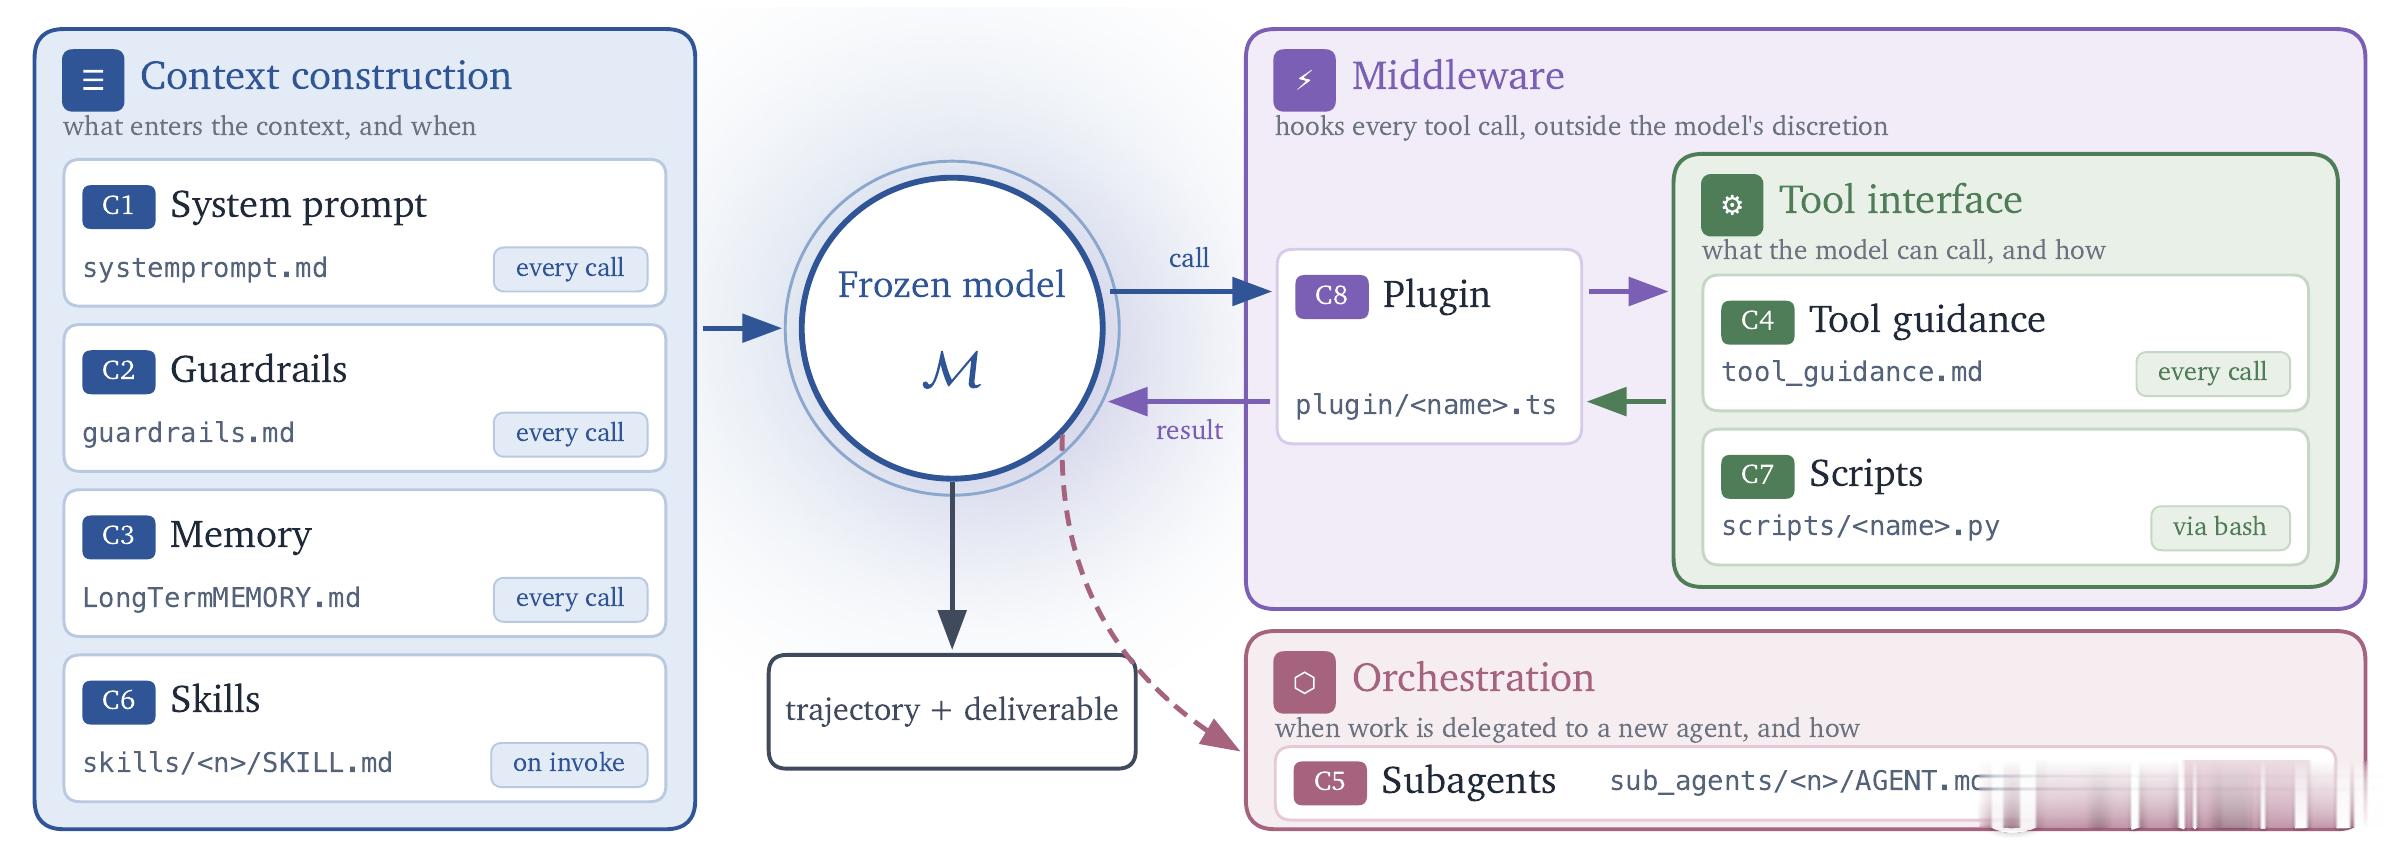
Google Research 的开源项目 Harness²,尝试让 Agent 在执行任务时改进自己的工作方法:模型参数保持不变,自动调整提示词、Skills、工具使用说明、辅助脚本和记忆等配置。
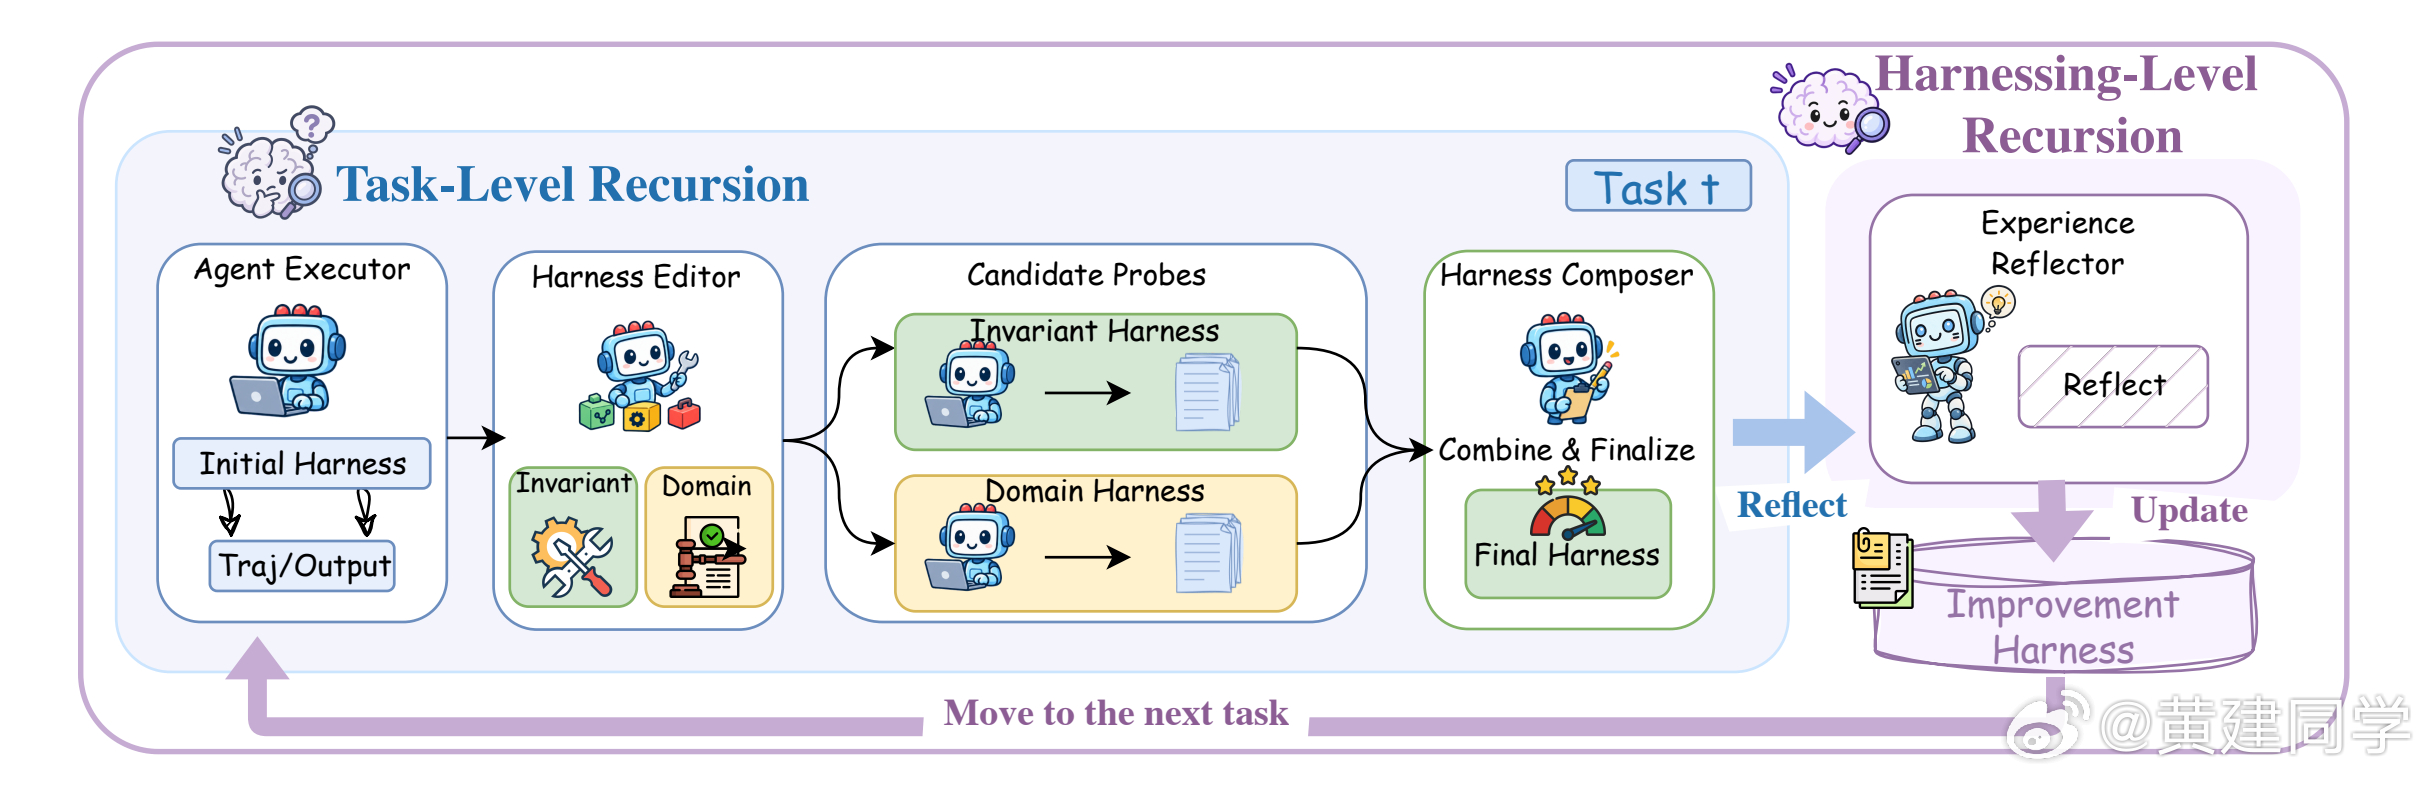
它把这个过程拆成了两层。
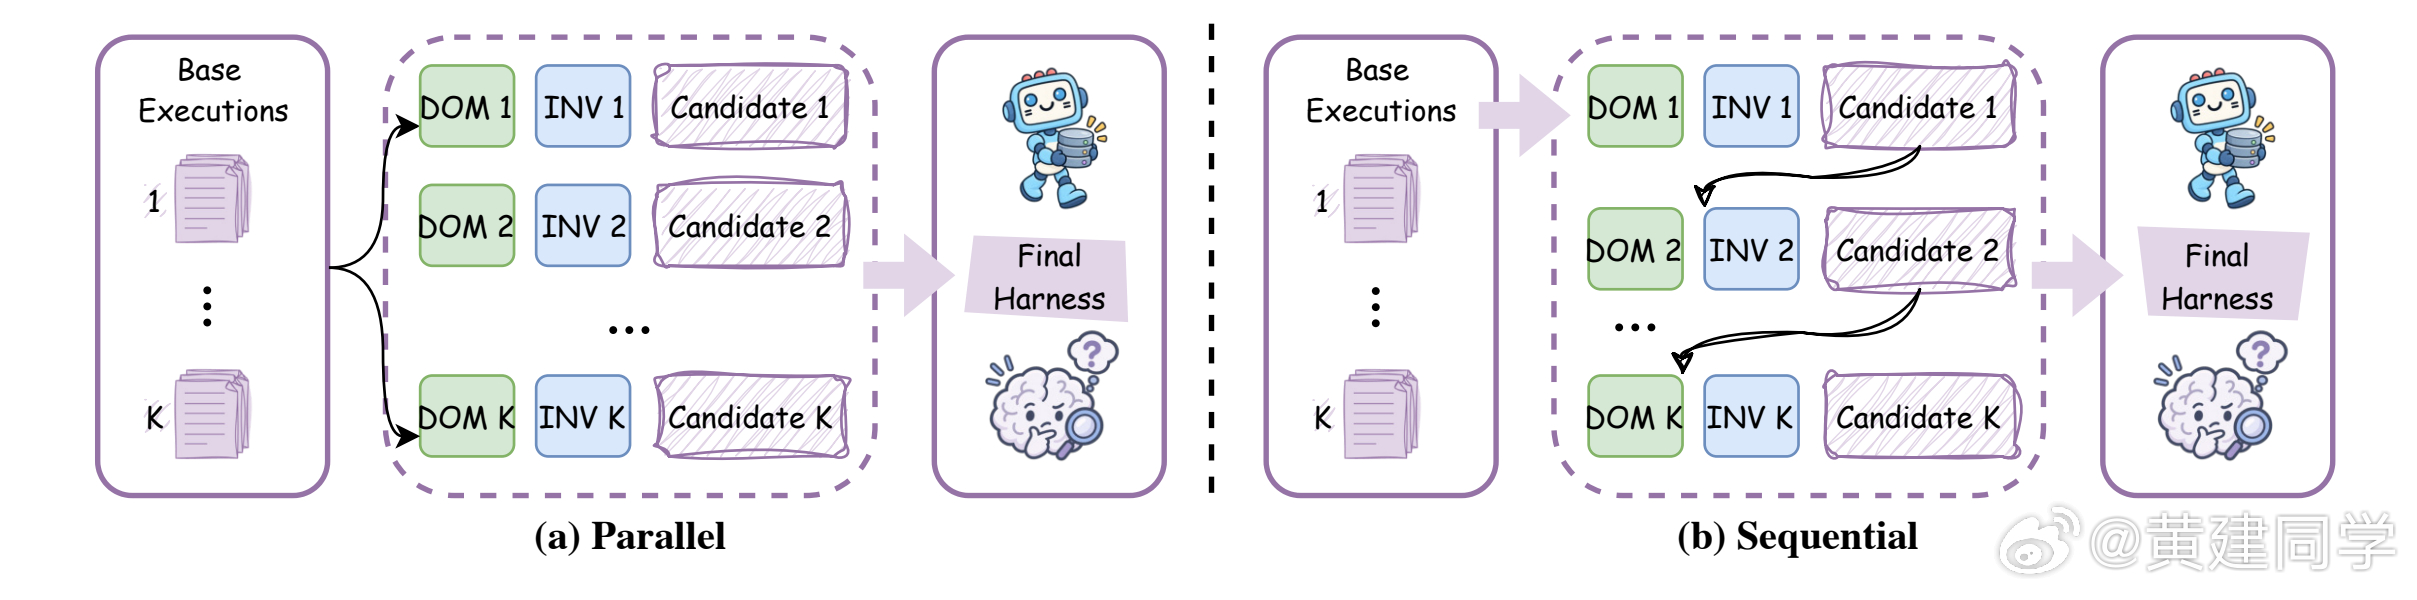
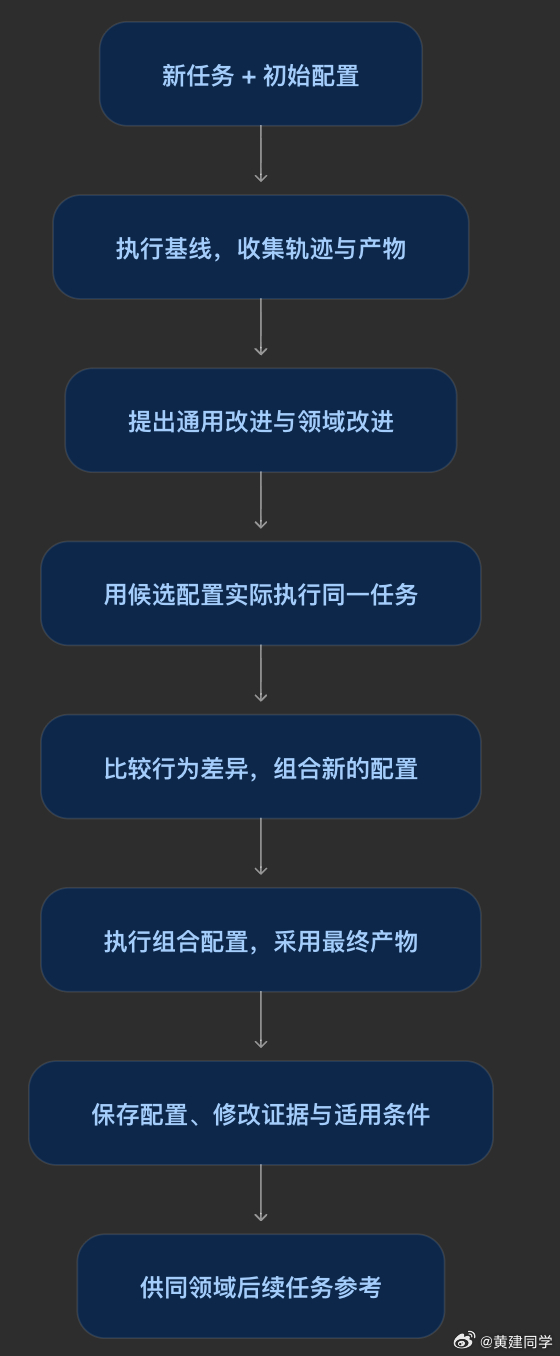
第一层,针对当前任务改进。先用基础配置运行,收集执行记录和产物,再提出通用改进与领域相关改进。候选配置会被真正运行,根据不同版本的行为差异,组合出新的配置,再执行任务。整个过程可以并行探索多个方案,也可以沿着一个方案逐轮优化。
第二层,把经验留给后续任务。系统保存被采用的完整配置,以及改了什么、有什么证据、适用于什么情况。同领域的新任务可以参考这些记录,再针对当前需求调整,不必每次从零摸索。
一个直观的例子是仓库自带的账目汇总演示:基础脚本只统计正数,漏掉了负数金额;改进版本删除错误的过滤条件,再保存“求和时保留正负符号”的经验。这里的修改规则是预设的,主要用于展示流程,但能看出它如何把问题落实到具体脚本,而不只留下一段反思文字。
项目目前支持 OpenCode 和 Codex 执行器,提供办公、网页、代码与专业工作等任务的实验入口。适合用来研究 Agent 如何根据执行证据调整配置,以及如何积累可复用的工作经验;接入自己的业务仍需要编写任务适配层。
需要注意,“不依赖标准答案”指的是改进阶段,最终效果仍要独立评测。它可能选错方案,默认流程也不保证改进结果优于原始结果。同时,同一任务需要多次试跑,会增加时间和模型调用成本,更适合可以隔离执行、值得投入额外计算的复杂任务。
项目:github.com/google-research/harness2
HOW I AI 程序员