全网还在好奇每百万 Token 输入 0.15 美元、输出 0.6 美元的极致性价比是怎么做出来的,DeepSeek 今天就直接把自家后厨给开放了。
这后厨,可比西贝的后厨刺激多了!
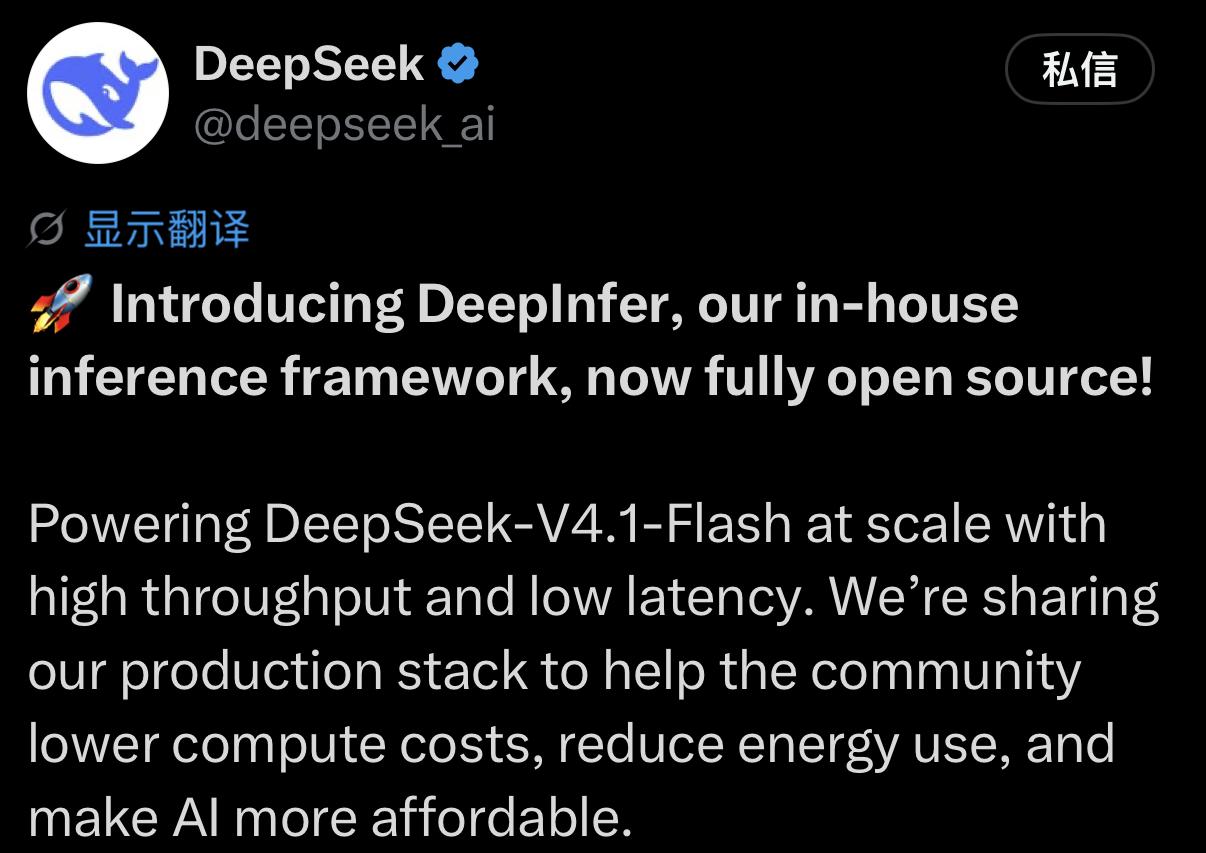
他们以 Apache 2.0 协议,把支撑线上服务的推理框架 DeepInfer 以及 API 同款编解码组件 deepseek-recipe 彻底开源。
这波操作,相当于米其林三星大厨不仅把绝密菜谱免费印发给你,还顺手把你家厨房换成了同款高压猛火灶,连切配摆盘的标准化工序也给打包送上了。
以前企业做模型私有化部署最痛苦的,不是买不起显卡,而是官方放了权重,你自己用通用框架搭出来的服务不仅吞吐慢、显存炸,最要命的是提示词格式和工具调用行为总是和官方线上 API 对不上号。
而这次随附的 deepseek-recipe,把官方线上正在用的 Token 编解码逻辑原封不动交了出来,直接抹平了本地部署和官方接口之间的“行为温差”。
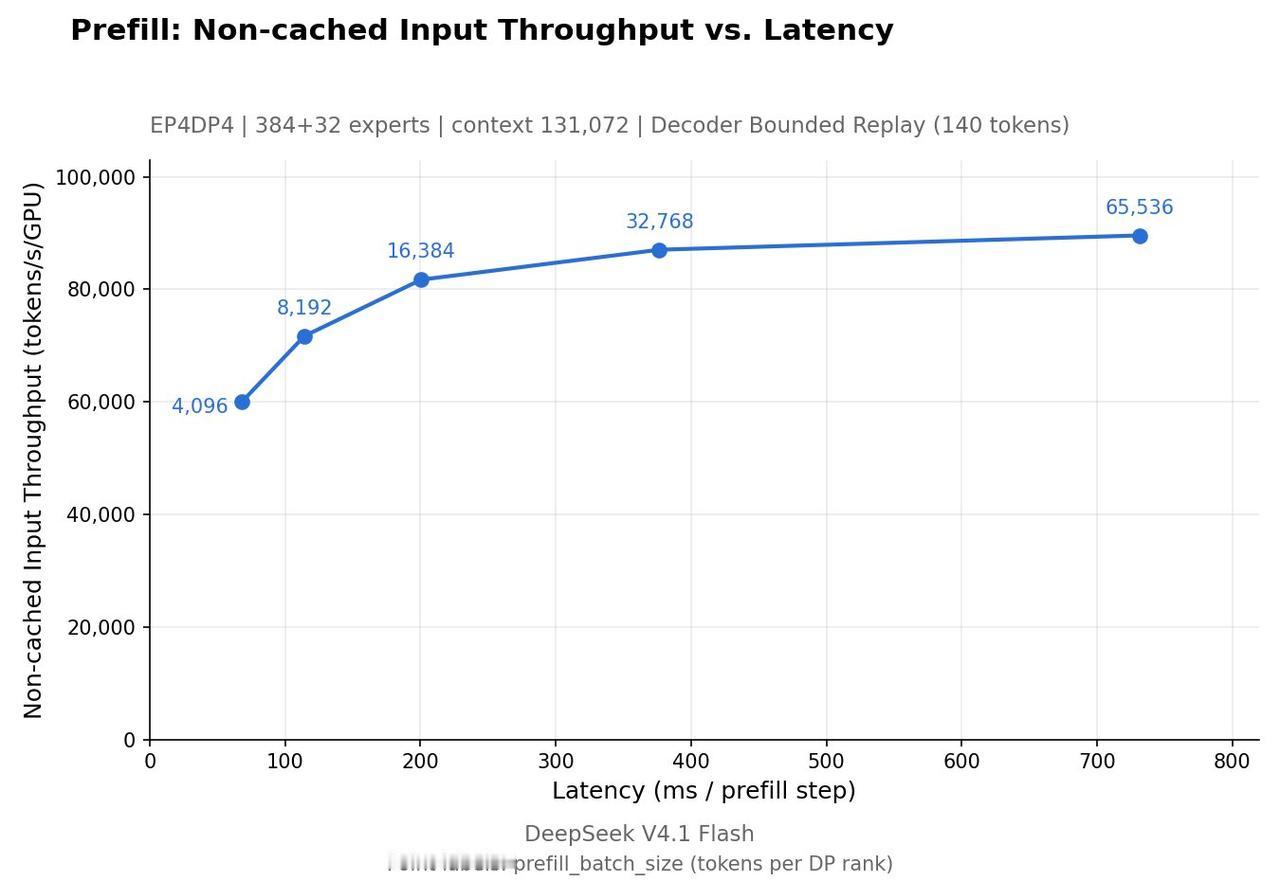
从官方公布的测试数据来看,在 EP4DP4 架构、384 加 32 专家模型以及 131K 上下文的配置下,结合 140 Token 的解码重放,其预填充吞吐量一举冲到了每秒近 9 万 Token 每 GPU。
这套引擎里集成了高性能算子、分布式推理、投机解码和 SWA Bounded Replay,直接把算力榨到了极致。
不过,面对全网的欢呼,准备做落地部署的工程团队还是得留个清醒。
翻开 GitHub 仓库的 README 就会发现,这次放出来的只是离线推理引擎。真正撑起完整线上高并发服务最核心的三块基建:KV 缓存系统、预填充与解码分离部署、多副本负载均衡,这次并没有随套件放出。
更耐人寻味的是它的硬件门槛。目前这套引擎只认英伟达最新的 Blackwell 架构 SM100 和华为昇腾 950 两款顶级芯片,支持的模型也仅限于刚发的新版 V4.1-Flash。
消费级显卡和单卡个人开发者,这次连凑热闹的资格都没有。
但这行看起来极度苛刻的硬件限定,反而暴露了比框架本身更狠的产业信号。头部国产大模型厂商已经不再等待芯片厂商来缓慢适配自己,而是亲自下场写底层算子。一边吃透硅谷最顶尖的 SM100,一边把国产昇腾 950 直接焊进了全球第一梯队的生产标准里。
对于做私有化部署和算力适配的架构师来说,赶紧去把 deepseek-recipe 的编解码对齐逻辑和底层算子吃透,那里藏着能省下大把调优工时的真金白银;至于手握单卡的个人开发者,老老实实调它家几毛钱的 API,绝对比自己搭建集群划算得多。
当一家公司连自己压箱底的印钞机图纸都敢往外送的时候,它图谋的早就不是赚你那点 API 差价,而是要让整个 AI 时代的工业生产线,全长成它的形状。