Mac + AI 就是这个时代最强大的生产力
只靠桌上两台 Mac Studio,MetaCEO扎克伯格直接在本地跑起了 816B 的新旗舰 Muse Spark Open,强烈推荐给所有想在本地跑满血旗舰大模型、又被天价算力卡劝退的人。
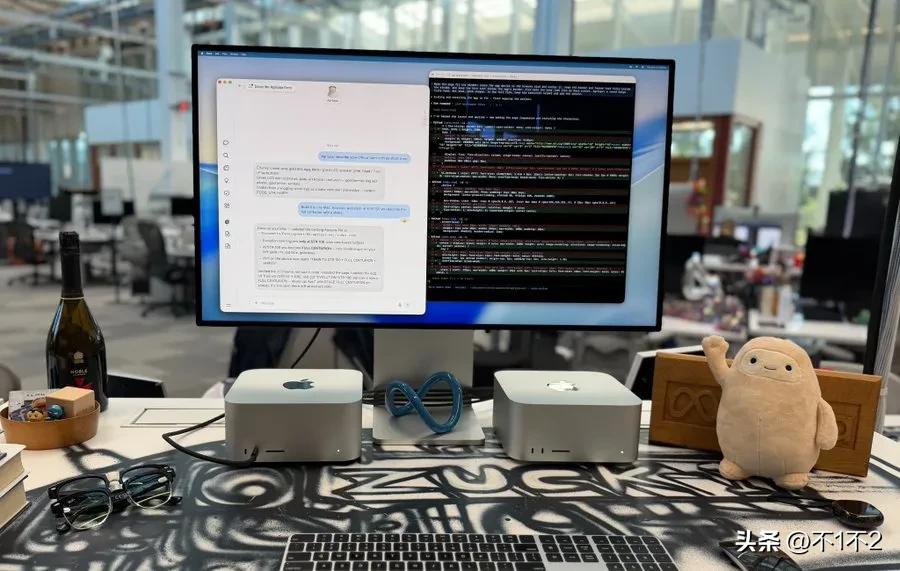
扎克伯格晒出的那张办公桌照片,其实已经把本地算力的底牌亮透了,不需要轰鸣的服务器机柜,两台并排的 Mac Studio 靠着苹果统一内存,就能在桌面上直接吞下这个今天刚开源的庞然大物。
真正能复制扎克伯格桌上那套 Muse Spark Open 816B 的硬核路径,整条配置逻辑其实极其清晰:摸清统一内存门槛 → 选对量化权重(oQ4e / oQ3e / Q2_K) → 敲一行命令拉起服务 → 锁死采样与推理参数。
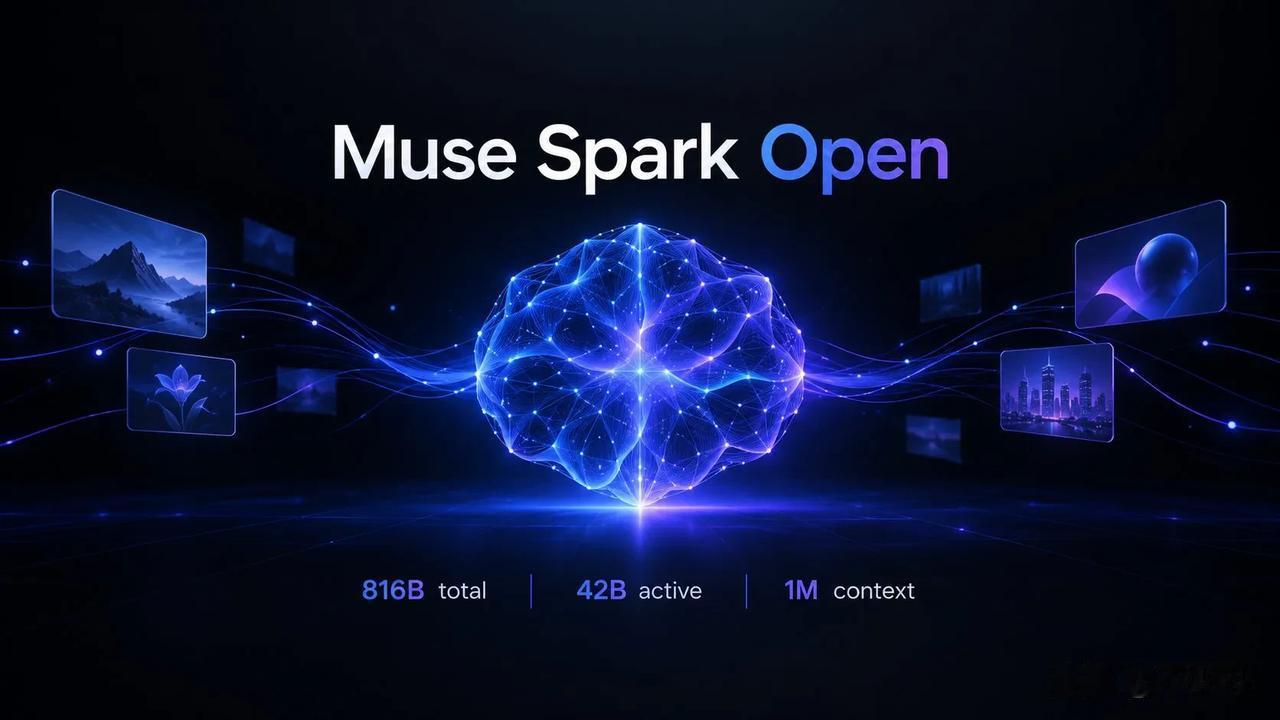
苹果新帅 John Ternus 亲自跑去评论区互动的背后,是一个极其关键的架构红利:816B 的总参数虽然吓人,但靠着 MoE 稀疏架构,每次实际激活的参数只有 42B。
只要你的内存装得下权重,推理时的计算压力比想象中温和得多:
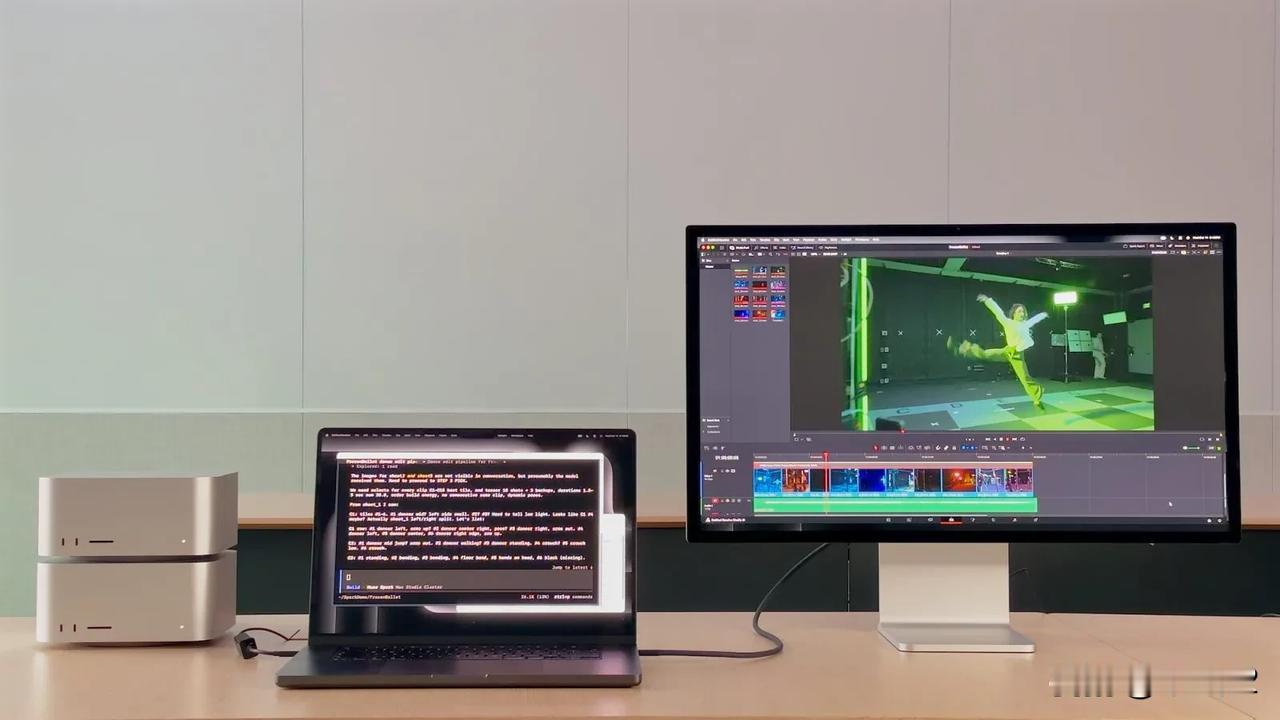
手里有两台顶配 Mac Studio 凑够 1TB 内存,直接上 MLX 的 oQ4e 量化,吃掉 476GB 空间就能跑出接近满血的质感,单台 512GB 的机器,选 oQ3e 版本刚好占掉 340GB,256GB 内存的工作站,用 Unsloth 或者 GGUF 的 Q2_K 极限压到 210GB,照样能把这个旗舰模型在本地拉起来。
以前超大模型是数据中心的专利,现在稀疏架构加上大统一内存,硬生生把顶级智能送到了了普通人的桌面上。
具体的一键启动命令:
Muse Spark Open (816B-A42B) 各档位一键启动命令,大家可以按手头的机器配置对号入座:
512GB 内存 · Mac Studio 单机(约占 340GB)
uv tool install mlx-lm
mlx_lm.server --model "mlx-community/Muse-Spark-Open-816B-A42B-oQ3e" --port 8080
(注:1TB 双机并联可直接换用约 476GB 的 oQ4e 权重)
256GB 内存工作站 · 极限量化版(约占 210GB)
llama serve -hf ggml-org/Muse-Spark-Open-816B-A42B-GGUF:Q2_K
企业级 GPU 集群 · 4×B200 或 8×H200(700GB+ 显存)
VLLM_USE_RUST_FRONTEND=1 vllm serve meta-models/Muse-Spark-Open-816B-A42B-NVFP4 \
--tensor-parallel-size 4 --enable-expert-parallel --max-model-len 1048576