RTX Spark是英伟达于2026年10月16日正式上市的革命性消费级超级芯片,首次将CPU与GPU深度集成于单芯片,通过统一内存架构解决本地AI推理的带宽瓶颈,使Windows PC能高效运行百亿参数大模型。其核心突破并非单纯提升算力,而是重构数据传输逻辑,让PC从工具升级为AI协作搭档。以下结合技术细节与市场现状展开分析:
一、技术突破:拆掉数据“过路站”
1. 统一内存架构是核心创新
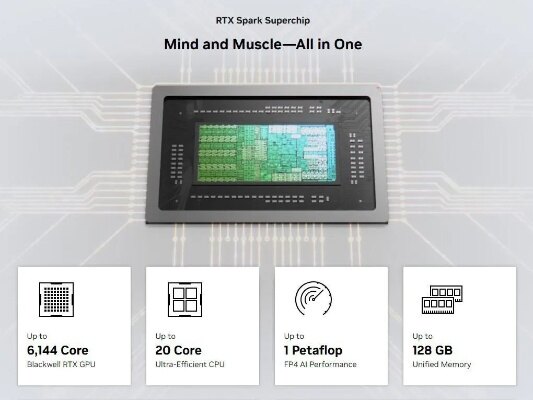
- CPU与GPU共享128GB LPDDR5X内存,通过NVLink-C2C实现600GB/s双向带宽(传统PCIe 5.0×16仅约64GB/s),数据无需跨总线搬运,直接在统一内存池中处理。
- 关键价值:本地运行大模型时,模型权重一次性加载至共享内存,CPU与GPU可零拷贝共享上下文,将推理瓶颈从“数据传输”转向“实际计算”,大幅降低延迟。
2. 硬件规格与性能定位
- CPU+GPU一体化设计:集成20核ARM架构Grace CPU(联发科协同开发)与6144 CUDA核心的Blackwell GPU,FP4精度下理论AI算力达1 Petaflop(千万亿次/秒)。
- 能效优化:笔记本功耗控制在45W-80W,离电性能仅比插电状态低约1%,打破“离电即残血”行业惯例。
- 需注意:1 Petaflop为FP4稀疏精度下的峰值理论值,实际应用受模型量化精度影响(如Qwen3.8-27B Q4量化时,输入64K tokens需140秒才开始响应)。
二、产品定位:从工具到AI协作搭档
1. 本地AI智能体的核心载体
- 无需依赖云端:可本地部署Hermes、OpenClaw等开源智能体,直接调用系统文件、创意工具(如Adobe套件),避免私密数据外传。
- 安全与权限管理:微软Execution Containers(MXC)提供系统级隔离,NVIDIA OpenShell Secure Runtime进一步管控网络权限,确保智能体仅访问授权资源。
2. 三合一场景覆盖
- 专业创作:支持渲染90GB级3D场景、8K 4:2:2视频剪辑,Adobe Photoshop/Premiere已适配TensorRT加速。
- 游戏体验:借助DLSS 5,2K分辨率下《黑神话:悟空》影视级画质可达40 FPS(不开光追),NBA 2K27通过帧生成技术进一步提升流畅度。
- AI开发:本地运行1200亿参数模型(如Qwen3.8),LoRA微调9B模型仅需约3分40秒,视频生成速度较上代提升4倍。
三、已上市机型与价格
1. 首发品牌与配置
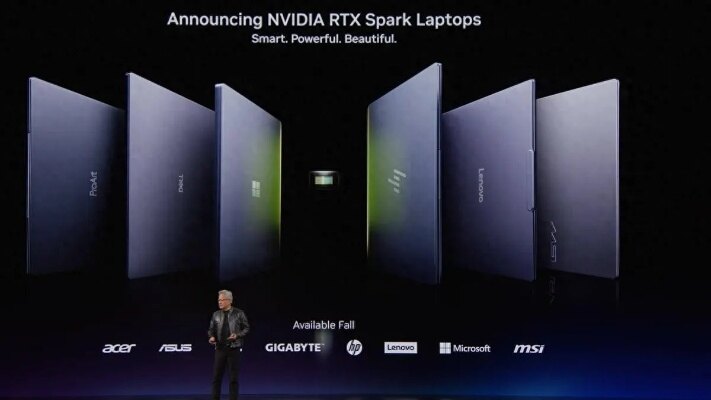
- 华硕:ProArt 创14(35999元起,128GB内存版)、创16(37999元)。
- 联想:YOGA Pro 15(42999元起,128GB+2TB顶配)。
- 微软:Surface Laptop Ultra(21988元起,最低配24GB内存)。
- 微星:尊爵N16 Flip(45999元,128GB+2TB)。
2. 价格与适用人群
- 高端定位:起售价普遍2万元以上,顶配超4.5万元,主要面向开发者、专业创作者及AI重度用户。
- 普通用户需理性看待:仅浏览网页、办公的用户难以感知128GB内存与1 Petaflop算力的优势,性价比更适配高频本地AI任务需求者。
四、与竞品对比的关键差异
1. vs 苹果M系列
- 统一内存规模:RTX Spark最高128GB(M4 Max仅128GB,但实际GPU可用容量受限)。
- AI框架生态:CUDA生态拥有500万开发者,本地大模型适配远超Core ML/Metal,对开源模型支持更友好。
- 软件兼容性:Windows on ARM仍需Prism转译部分x86应用,macOS生态成熟度仍占优。
2. vs 传统x86轻薄本
- 离电性能:传统轻薄本离电时性能腰斩,RTX Spark通过低功耗设计维持99%插电性能。
- AI工作流:无需反复上传数据至云端,高频、私密任务本地化处理更高效(如批量视频生成、代码调试)。
总结:RTX Spark的真正意义不在于参数堆砌,而是通过统一内存架构将本地AI推理体验从“能用”推进到“好用”。它并非替代传统PC,而是为需要本地化处理敏感数据、高频运行大模型的用户提供了新选择。若你的工作流涉及私密项目开发、实时创意生成或AI智能体协作,其价值远超硬件成本;若仅日常办公,则现有设备仍更经济实用。