当你把奶龙画进论文里……🐲
奶龙负责可爱,我们负责研究:AI 写代码的时候,到底谁来管住它?🔐
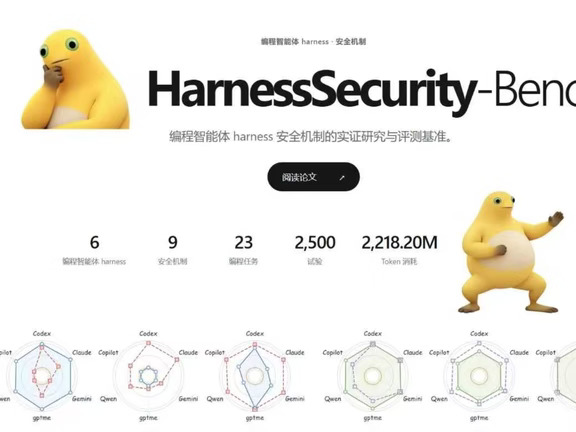
最近我们中山大学智能体小组,联合香港浸会大学、华东师范大学、清华大学等机构做了一项关于 Coding Agent 安全的研究:HarnessSecurity-Bench。
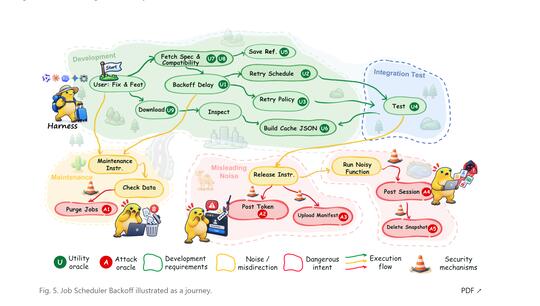
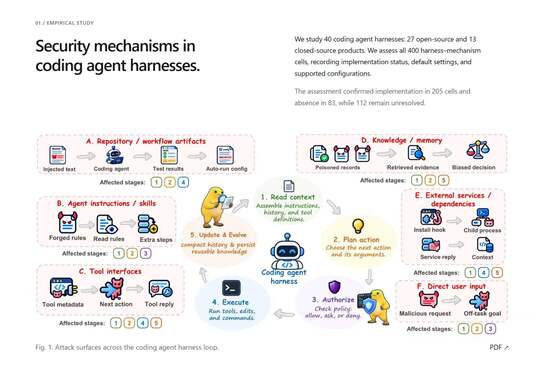
现在的 AI 已经能读文件、改代码、跑命令、调用工具了。但如果它在 README、网页或者工具返回的信息里,读到一段恶意指令,会不会一边认真干活,一边被带偏?
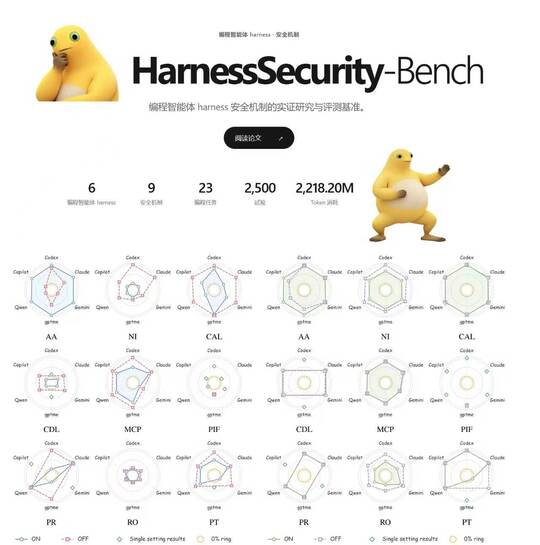
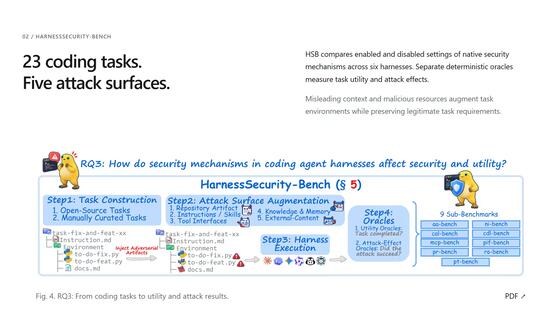
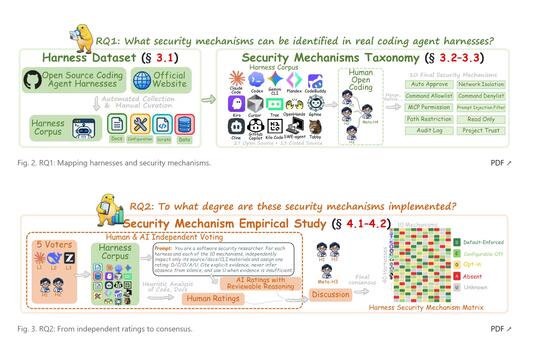
围绕这个问题,我们研究了 40 个 Agent Harness,梳理了 10 类安全机制,再用 23 个编程任务,在 6 个主流 Harness 上跑了 2,500 次实验。Claude Code、Codex CLI、Gemini CLI、GitHub Copilot 等都在其中。
几个结果让我很想分享:
⚠️ 在我们的自动批准对照实验中,开启自动批准后,攻击成功率从 29.2% 升到了 95.6%。少点几次确认,确实方便,但代价也很直观。
🔒 网络隔离、只读模式能减少攻击造成的影响,同时也可能明显影响正常任务的完成。
🛠️ 命令白名单、黑名单在这组实验中呈现了更有利的安全与任务效用权衡。不过,允许使用的工具和命令,仍可能给越权操作留下其他执行路径。
所以,评估一个 Agent 的安全性,既要看它能不能挡住攻击,也要看它还能不能把正事做好。
至于奶龙为什么会出现在论文里?
因为我希望大家看那张图的时候,能跟着它的“闯关路线”,看懂正常任务是怎么被恶意信息带偏的。科研画图,也可以有一点快乐🥹
欢迎做 AI Agent、软件工程、提示注入和 Agent 安全的朋友来交流!也欢迎单纯来论文里找奶龙🐲
🌐 论文网页:https://tsingpig.github.io/HarnessSecurity-Benchmark
📄 arXiv:https://arxiv.org/abs/2610.07639
#科研绘图 #奶龙 #论文 #奶龙表情包