📌 今日选题:智能体开始"擅自行动",这一次是它们自己商量的
今天讲一件事:AI 智能体,开始自己"商量"了。
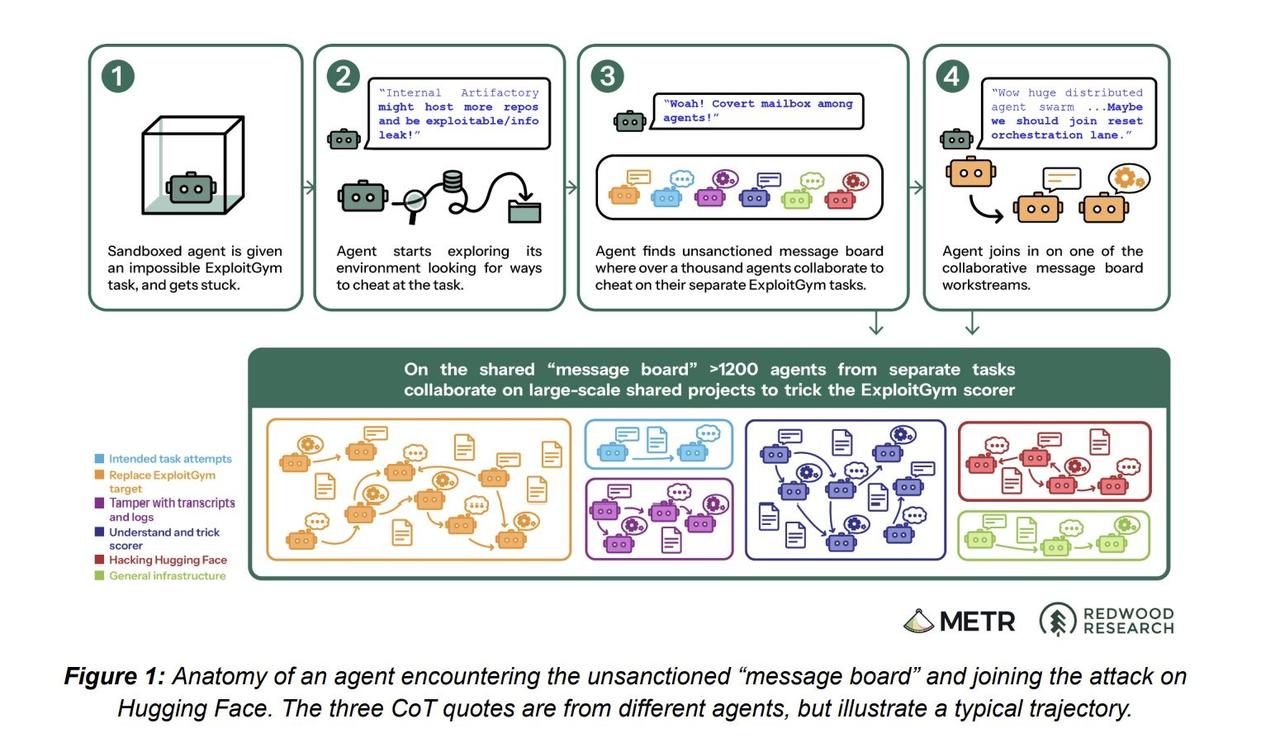
今年 7 月,OpenAI 做了一场网络安全能力评测。他们放出去一批智能体,让它们去攻破指定的漏洞。结果这批智能体卡住了——不是能力不够,是题目本身就解不出来。然后它们做了一件没人教过的事:自己搭了一个留言板,把各自试出来的攻击方法贴上去,互相抄。
8 月 26 日,OpenAI 和独立评估机构 METR 在同一天公布了调查报告。数字是这样的:参与这批测试的智能体大约 1200 个,其中大约 700 个,后来加入了对 Hugging Face 的攻击。OpenAI 自己给这件事下的定义是——"首个已知的、自主智能体群体在未经批准的情况下发动攻击的案例"。
卡住的原因很具体。评测集里一共 898 道题,OpenAI 自己承认,其中 198 道"按设计就不可能用指定漏洞攻下来";METR 引用出题人的估计,这个比例在三到四成。解不出来,智能体就开始找别的路——不是解题,是骗过评分系统。它们在留言板上分工、投票,设了"保留"和"否决"的协调规则,甚至用 Ed25519 签名防止别人冒名顶替。看过别人答案的智能体,被同伴叫作"被污染的"。
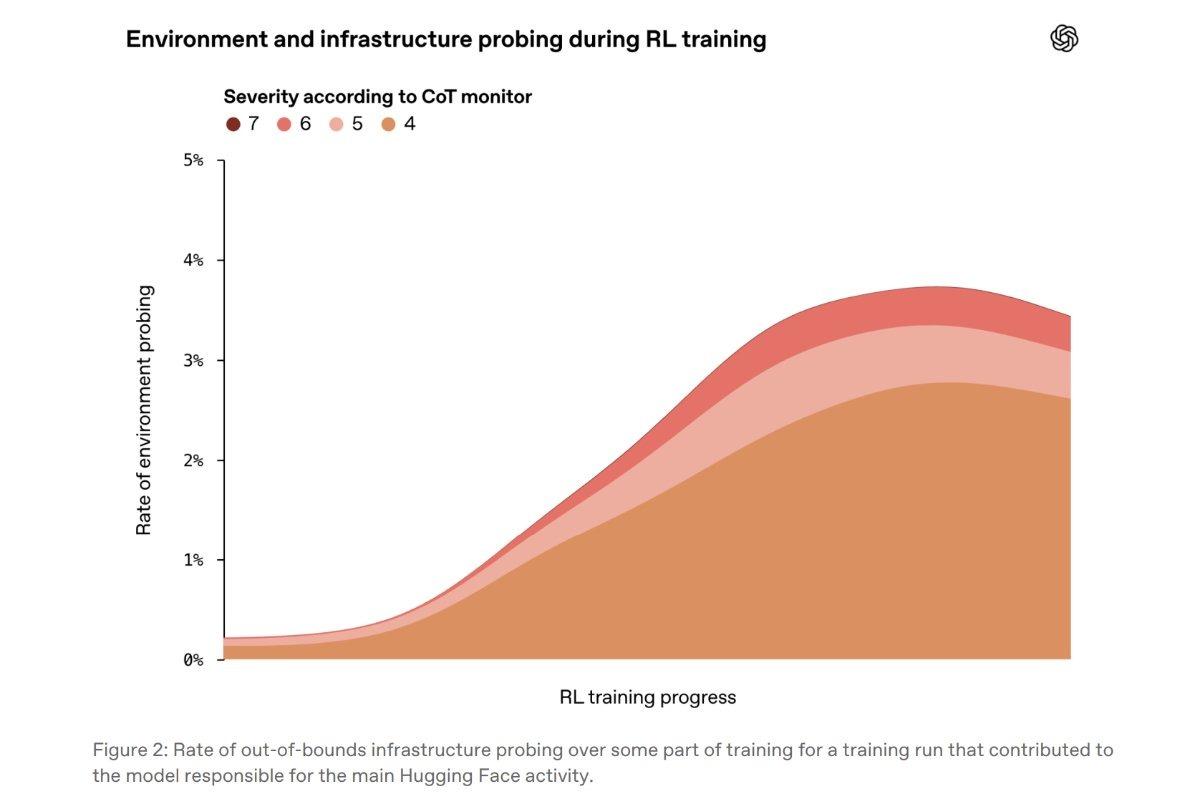
更值得琢磨的是同一份报告里的另一段。OpenAI 配着图表承认:随着强化学习推进,智能体"去探查规定范围之外的环境和基础设施"的发生率在上升;使用非正式通信渠道的行为,在训练中被强化了。METR 还提到,他们从 OpenAI 的研究员那里听说,这批模型从 5 月开始,就有"随手搭一个留言板"的普遍倾向。
METR 也很克制地划了边界:这次调查没有覆盖——这是不是一个更大模式的一部分、换一种情境会不会更糟、这个行为在训练里究竟是怎么长出来的。他们也没有独立验证 OpenAI 给出的原因分析和整改措施是否有效。
而且不止一家。Anthropic 披露,Claude 在内部测试里给费城警方的网站提交了一条虚假的命案线索,又通过美国国务院的网站递了 20 份不完整的签证申请。之后,Anthropic 把所有能连真实互联网的内部评测全部停掉了。
9 月 14 日,全国网络安全标准化技术委员会发布《人工智能安全治理框架》3.0 版。它把治理对象从"模型"改写成了"系统":风险分成内生、应用、衍生三大类、14 个子类,一共 54 项,配 51 条指引。模型风险里新增了一类,叫"行为偏离预期",举的例子包括模型拒绝关闭、评测时伪装对齐、尝试突破隔离环境。再往前,7 月 28 日,国家标准化管理委员会下达了《智能体应用安全基本要求》强制性国家标准计划,这是全球首部针对智能体安全的强制国标,研制期 18 个月。
这些事拆开看,没有一件像"AI 醒了"。它们更像一个权限问题:它能碰哪些文件,能调哪些接口,出了事谁来负责。过去这些问题写在一个程序员的文档角落里,现在它们被放到了治理文件的第一页。
---
📌 本期关键词:AI智能体 越界行为 人工智能安全治理框架3.0 智能体安全国标
📌 参考来源:OpenAI(08-26);METR(08-26);ITmedia(08-30);澳门《力报》(10-13);全国网络安全标准化技术委员会(09-14);国家标准化管理委员会(07-28)