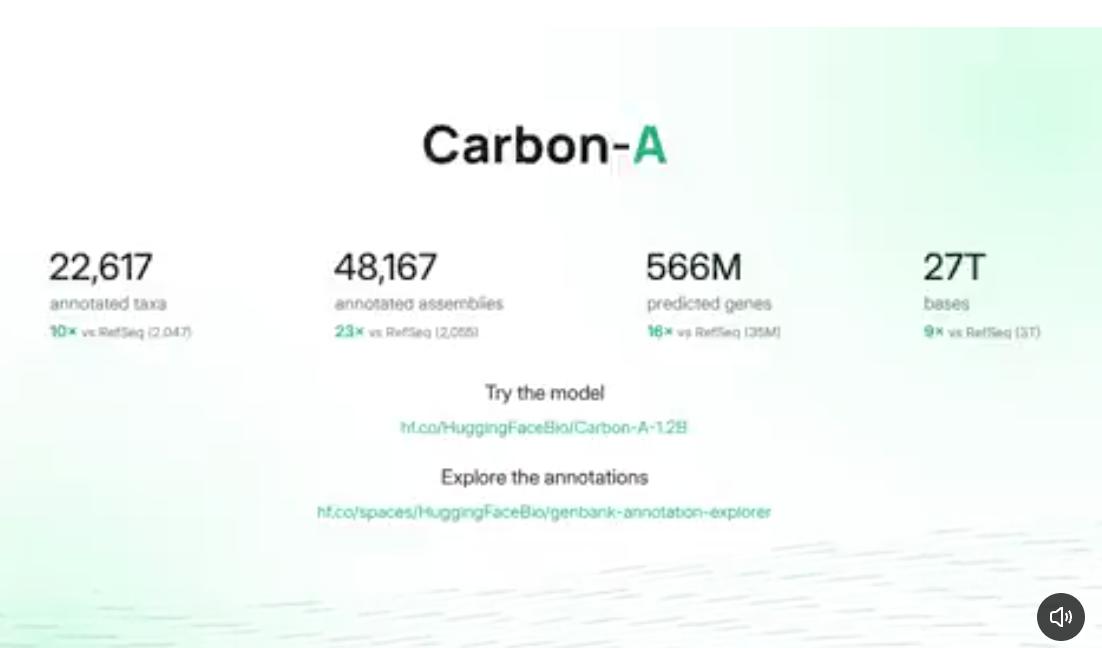
HuggingFace震撼开源Carbon-A(正式名Carbon-Annotator)1.2B参数模型,可直接从DNA序列预测蛋白质编码区域,并同步发布Carbon注释数据库,覆盖22617个物种、48167个组装的5.6634亿个新基因候选,序列总量约27万亿碱基对。湿实验已在猫、鸡、拟南芥等物种中验证部分新基因。
这条发布最值得展开的是它把基因组注释的瓶颈从“依赖近缘物种和转录组证据”推向“单模型跨生命树直接读码”。Carbon-A采用双向注意力编码器,在98304碱基对上下文窗口上输出核苷酸分辨率的编码/非编码分类,再经轻量后处理模型组装成基因。在42个基准基因组上,宏平均核苷酸F1达到0.944,全面超过AUGUSTUS、Helixer、Tiberius等主流工具。更关键的是泛化:仅用动物数据训练的检查点,在从未见过的植物基因组上仍保持可用精度;对使用非标准遗传密码的四膜虫也能拿到0.960的F1。与Active Site和加州大学圣地亚哥分校合作的PacBio Iso-Seq实验进一步显示,模型在猫、叙利亚仓鼠、鸡、拟南芥中预测出的多个编码区被真实RNA证据支持,而RefSeq参考注释却缺失,合计至少239个基因。数据库本身是RefSeq训练语料的约11倍物种、9倍序列规模,且仍在持续覆盖整个GenBank。