上一篇拆了几个 Jev 打游戏的爆款,没找到 Jev 自己「越玩越强」的可靠证据。那它到底会不会学?我和我的 agent 拿分类题、老虎机、迷宫这几个简化任务做了大量对比实验,结论是会。
就像大模型照着范文写出相似文风,Jev 也能不改模型参数,只靠这次输入里的例子和记录调整判断,即上下文学习。但能强多少,很大程度看怎么喂;要多看几步的,目前看来还不太行。
我们的实验用到了「老虎机」,它是测 AI「边试边学」的经典小游戏。有几个按钮,每个中奖概率固定,但 AI 事先不知道,只能从按出来的结果里摸索出哪个最容易中。
1️⃣ 每类给几个例子,Jev 就从瞎猜学到九成多。让它给句子分五类,标签故意起成没含义的 L1–L5,哪个标签指哪类只能从例子里看出来。不给例子只对 23%,和瞎猜的 20% 差不多;每类给 1 个例子就到 85%,给 4 个到 97%。
2️⃣ 看历史记录也能学,但怎么喂效果差很多。在老虎机游戏中,我们给 Jev 一串「按了哪个、中没中」的记录。记录里差按钮按得多得多,中的次数也就往往更多,光数中了几次就会选错,Jev 50 题里还是挑对了 39 题;同一份记录,问的时候多提醒一句比较中奖率、别数次数,就挑对 48 题。
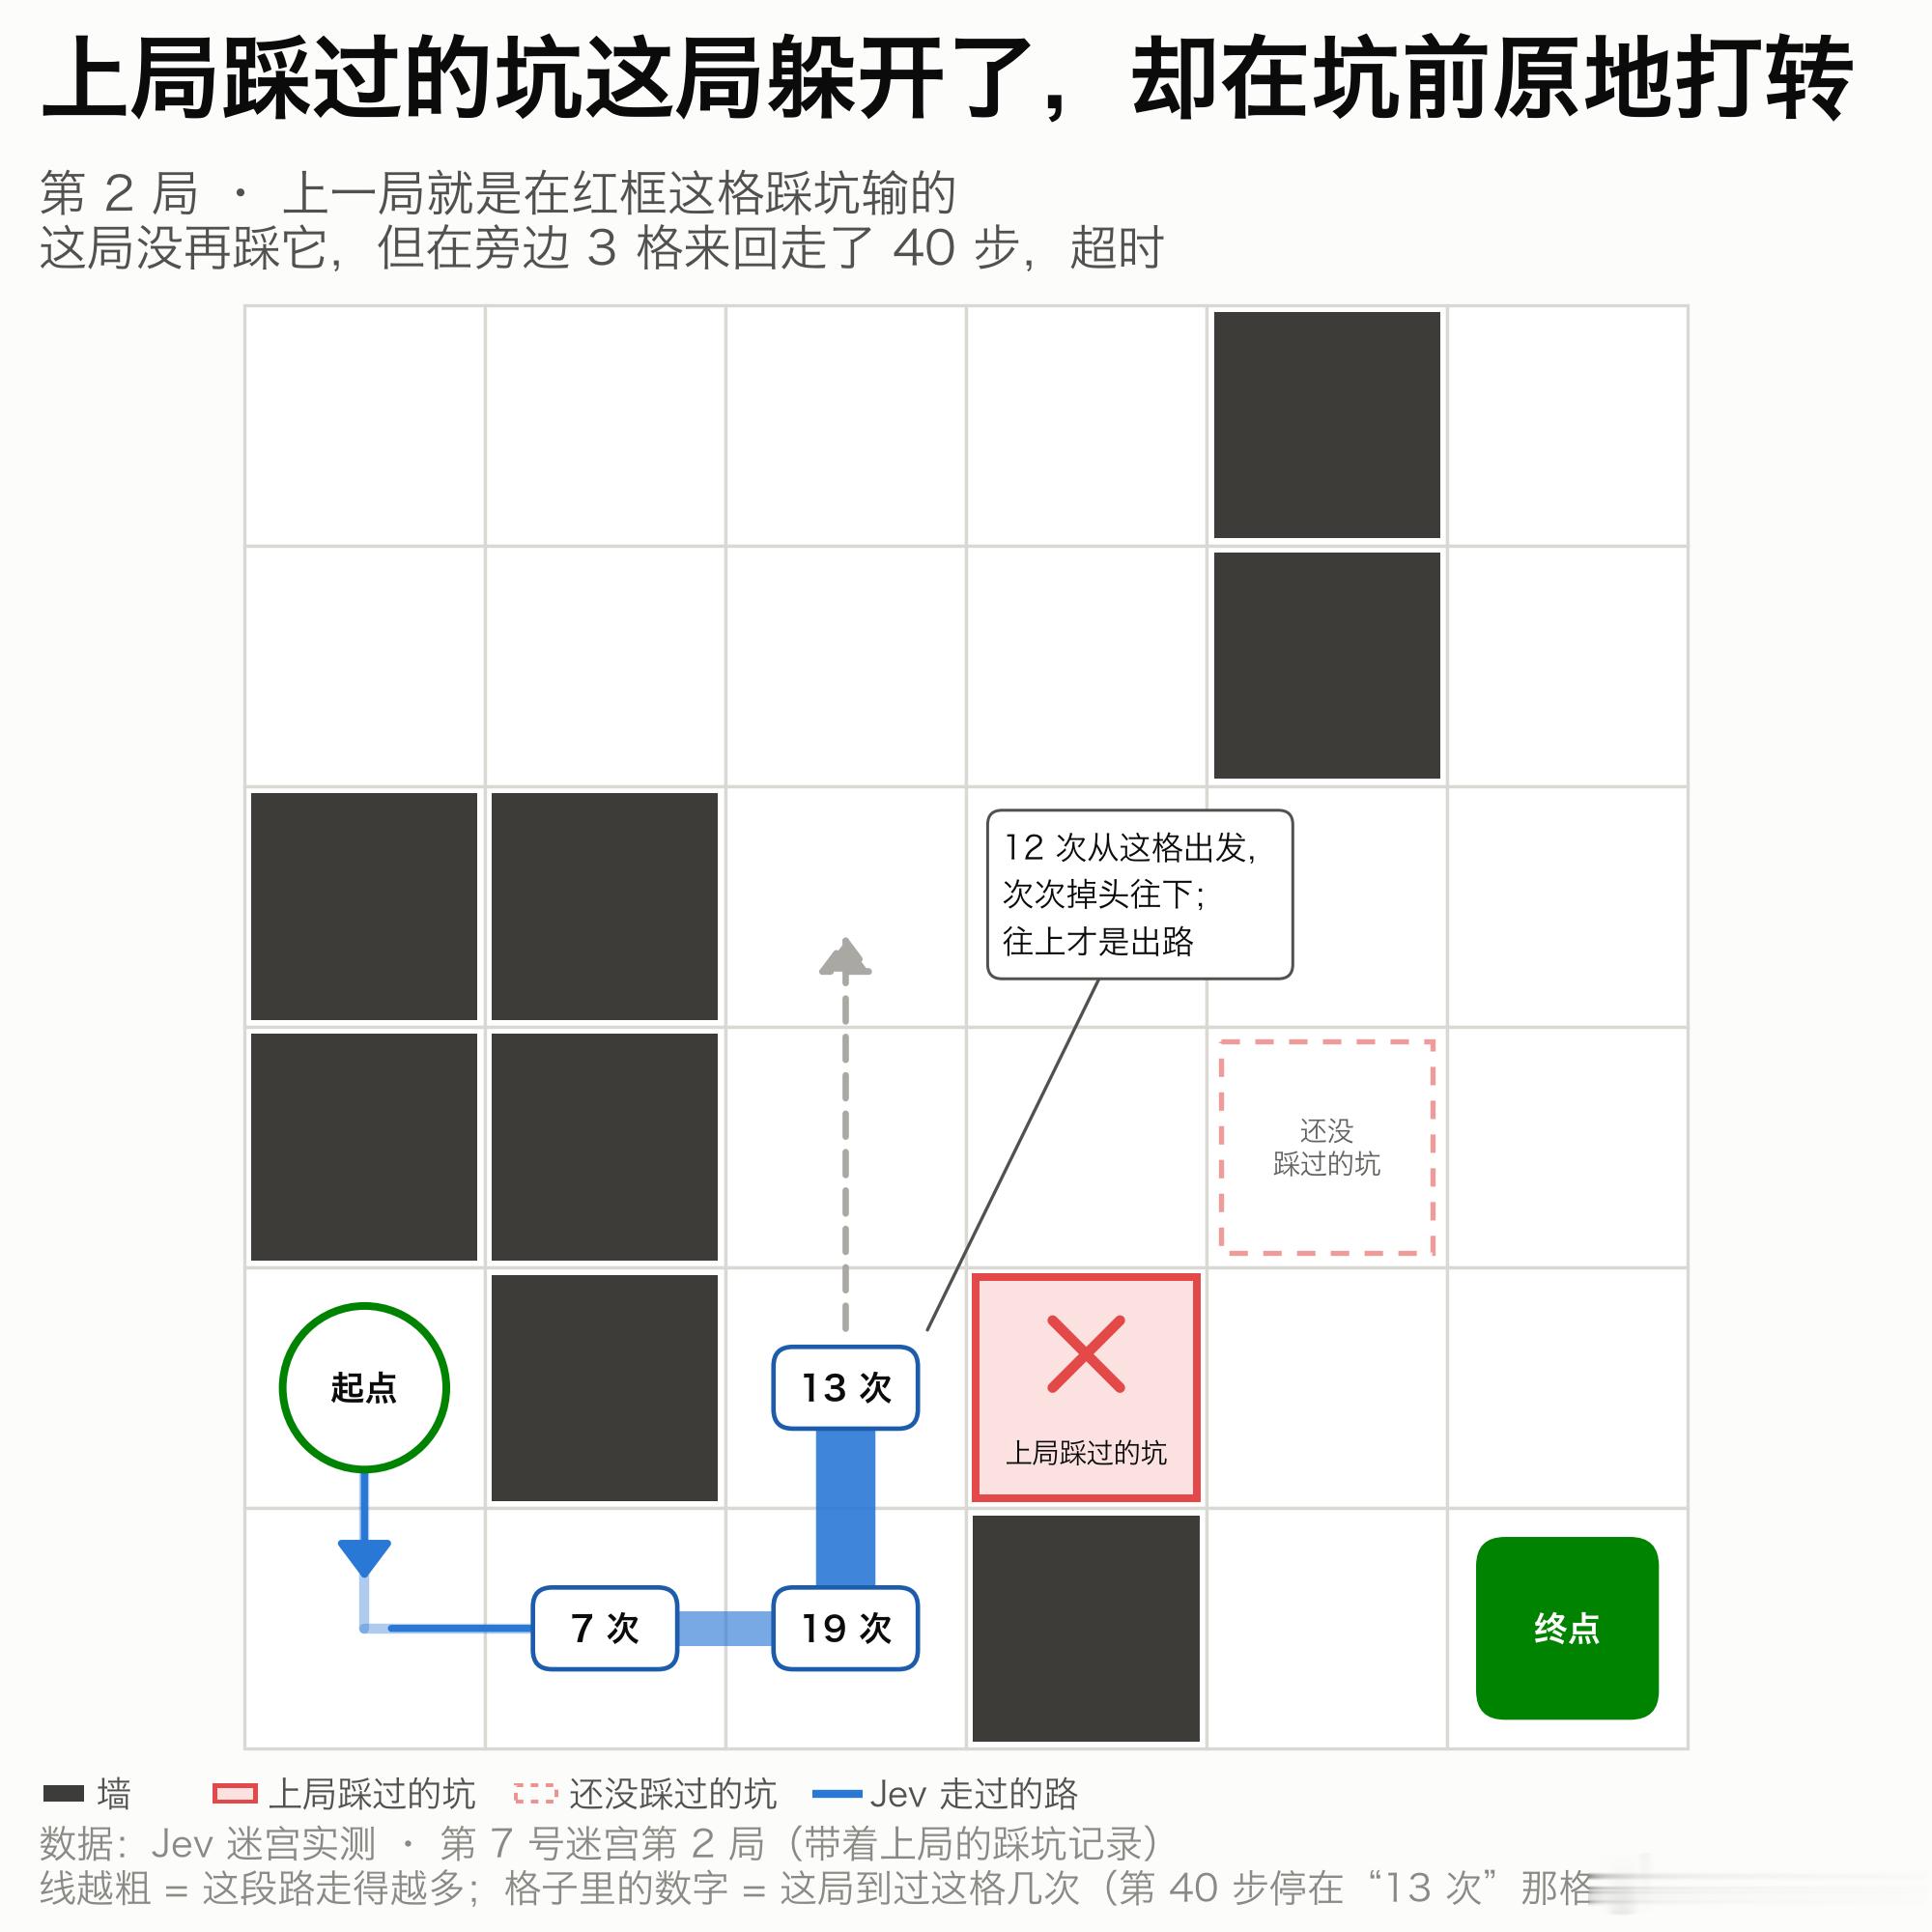
3️⃣ 迷宫游戏里,躲坑学得会,绕远路目前看来还不太行。我们在迷宫里藏了看不见的坑。把前几局踩坑的位置写进输入,每局第一次走到已知的坑跟前,Jev 约九成能避开,却常在坑前来回打转、没去绕远(见图),120 局只通关个位数。难在绕路。拿掉坑只留墙,从起点一路朝终点走就能到的,几乎都走到;要比直走多绕 4 步以上的,只有约四分之一。Jev 每步直接给出答案、不写推理,表现得像只凭直觉、看不到绕远之后的路。
为什么 Jev 不先把思路写出来再走?官方把这类模型叫 System One,说是受卡尼曼《思考,快与慢》启发,取的是「快思考」那一侧;官方演示里,Jev 打 Doom 每秒做约 10 次决策。估计 Jev 也能训练成先想再答,但那样就慢了,有违靠直觉快速拍板的初衷。
看起来,Jev 会上下文学习,给它例子和记录,它能把判断调准;想让它越玩越强,还得有人帮一把,把 state(材料)和问题组织好,有点像给大模型写提示词。
Jev人工智能