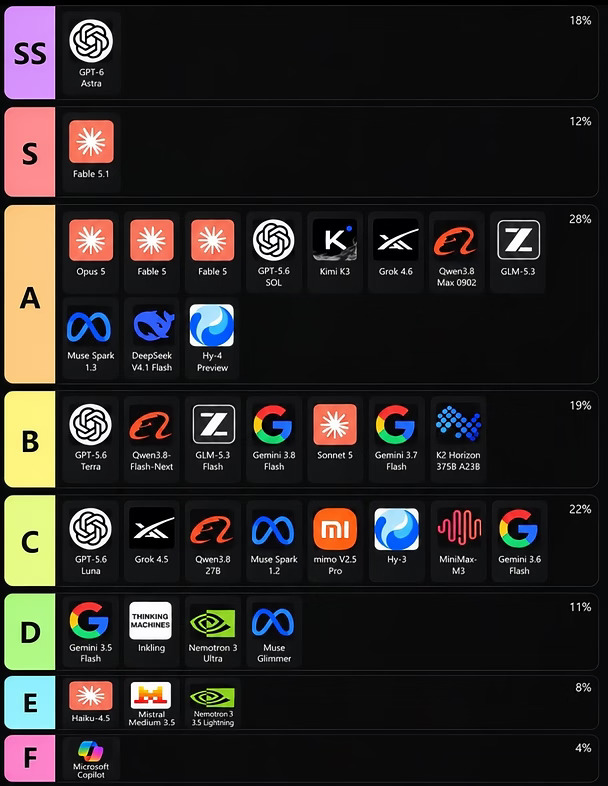
最近看到一张很有意思的模型梯队图。
GPT-6 Astra、Fable 5 直接冲到 SS / S;
Opus 5、GPT-5.6 Sol、Kimi K3、Grok 4.6、Qwen、GLM 等进入 A;
而 Gemini、DeepSeek、Llama 系列则分布在 B/C/D……
但我觉得真正有意思的,不是谁排第一。
而是你会发现:
AI 模型正在从“单一能力比拼”,进入“场景分化”的阶段。
写代码是一套排名,
做研究是一套排名,
写作、推理、Agent、长上下文,又是另一套排名。
所以现在再问:
> “哪个模型最强?”
其实已经越来越没意义。
真正应该问的是:
“我的任务,应该把哪个模型放在最合适的位置?”
未来的 AI 产品,很可能不是押注一个模型,而是:
模型路由 + 多模型协作 + Agent 工作流。
模型本身越来越像基础设施,
真正拉开差距的,是谁能把模型用对地方。
这也是为什么,接下来 AI 产品的竞争,可能不再是“谁的模型参数更大”,而是:
谁更懂任务,谁更懂数据,谁更懂怎么调度模型。
#ai#大模型 #ChatGPT #claude#kimi #AI反常识howto