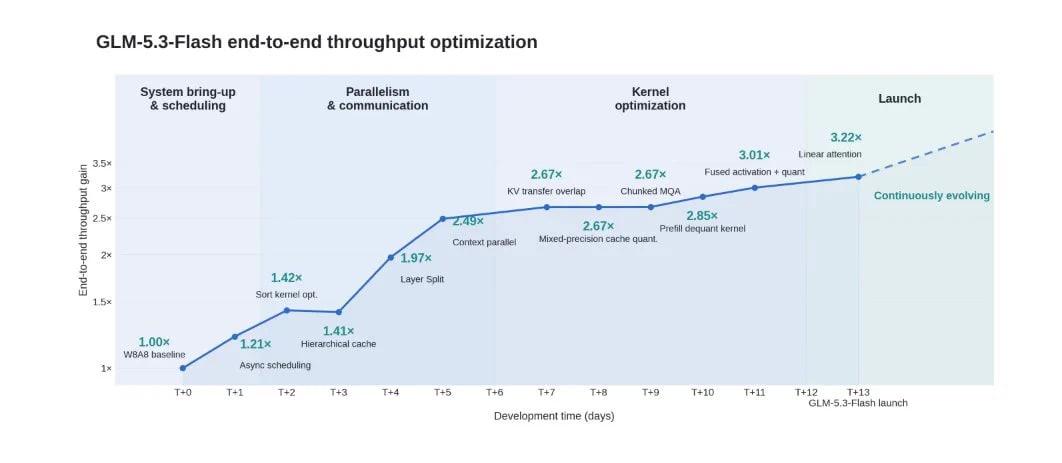
看到GLM-5.3自己优化自己服务栈的报道,第一反应很容易脑补成模型已接管生产系统。但拆开看,这更像一次被工程目标框住的人机协作。
链路是这样的:GLM-5.3被用来改写服务GLM-5.3-Flash的推理基础设施,从首次跑通到生产可用不到两周,端到端吞吐相对初始基线提升到3倍,运行环境在10万+加速器规模上。模型确实在分析、提假设、写代码、做实验,但目标函数、性能预算、不能动哪些接口,这些边界由工程师划定。例如Prefill与Decode阶段的延迟对齐,Agent把Python GIL释放出来,把Prefill+KV Transfer与Prefill之间原本超过20%的差距压到1%以内,这种调优空间依赖熟悉运行时和推理栈的工程经验。
把结果直接套到递归自我改进叙事上得打折扣:吞吐翻 3 倍的对比基线是项目最初版本,不是其他生产推理栈,负载与请求长度分布未披露;10万+加速器是部署规模,不是优化本身新增的算力。模型能力有了,工程经验也沉淀进下一轮迭代,但通用AI自我优化生产系统目前还停留在演示级。
值得盯着的是两件事:GLM-5.3-Flash之外更大体量的模型能否复制这条链路;团队会不会把目标设定、边界约束、性能基线沉淀成可复用工具。把人定边界、机填代码的分工拆清楚,这条路才有持续跑下去的可能。
下一轮目标你更愿意先让Agent啃Python运行时和GIL这类开销,还是直接扑向算子kernel这种更硬的瓶颈?