刚开工写需求,海外主流编程 Agent 额度就见底了,肉疼得很。
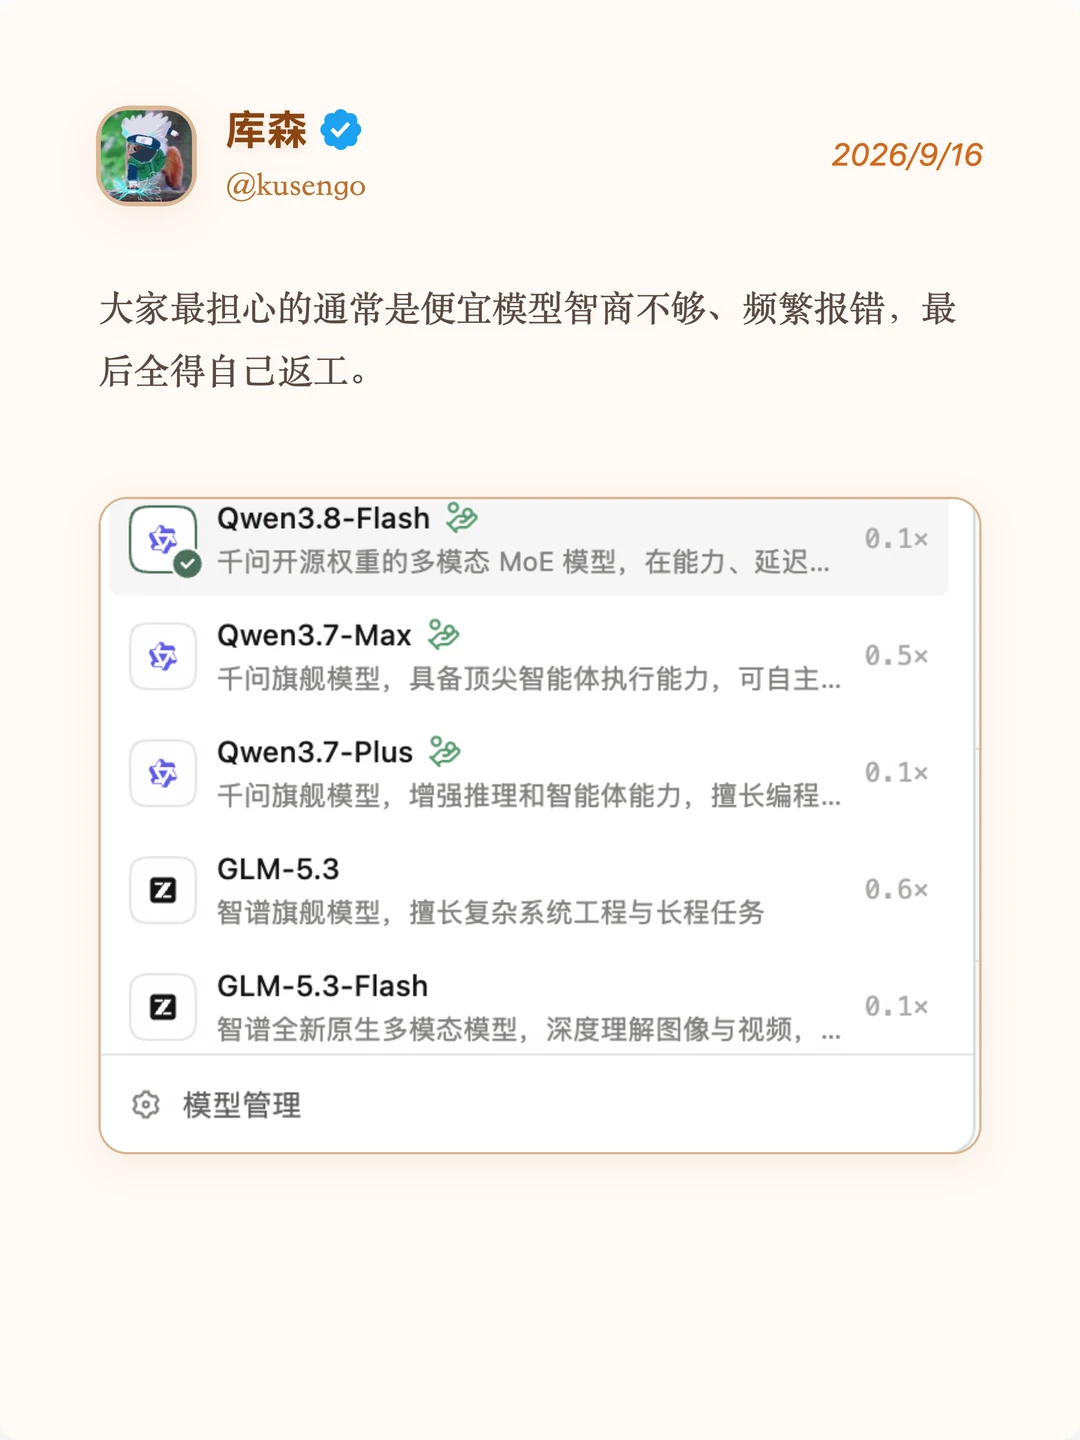
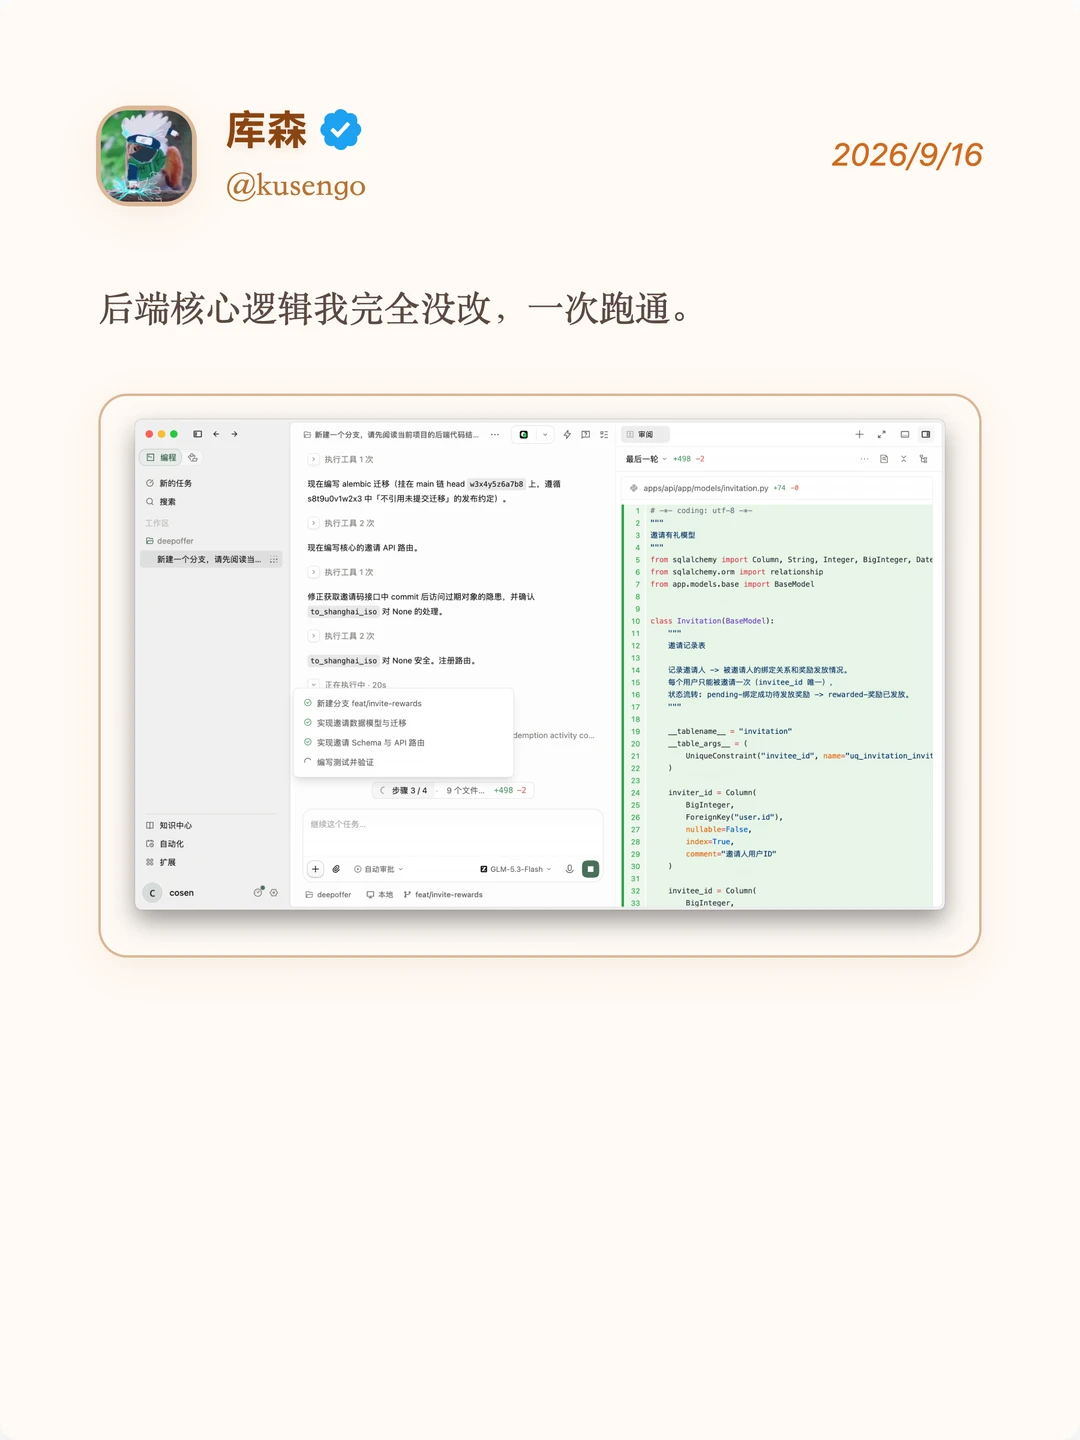
这次我抱着试试看的心态,拿 Qoder 里的便宜档 Flash 模型接着干。 直接按擅长领域分工, 后端接口与防刷交给 GLM-5.3-Flash, 前端页面与组件复用交给 Qwen3.8-Flash。
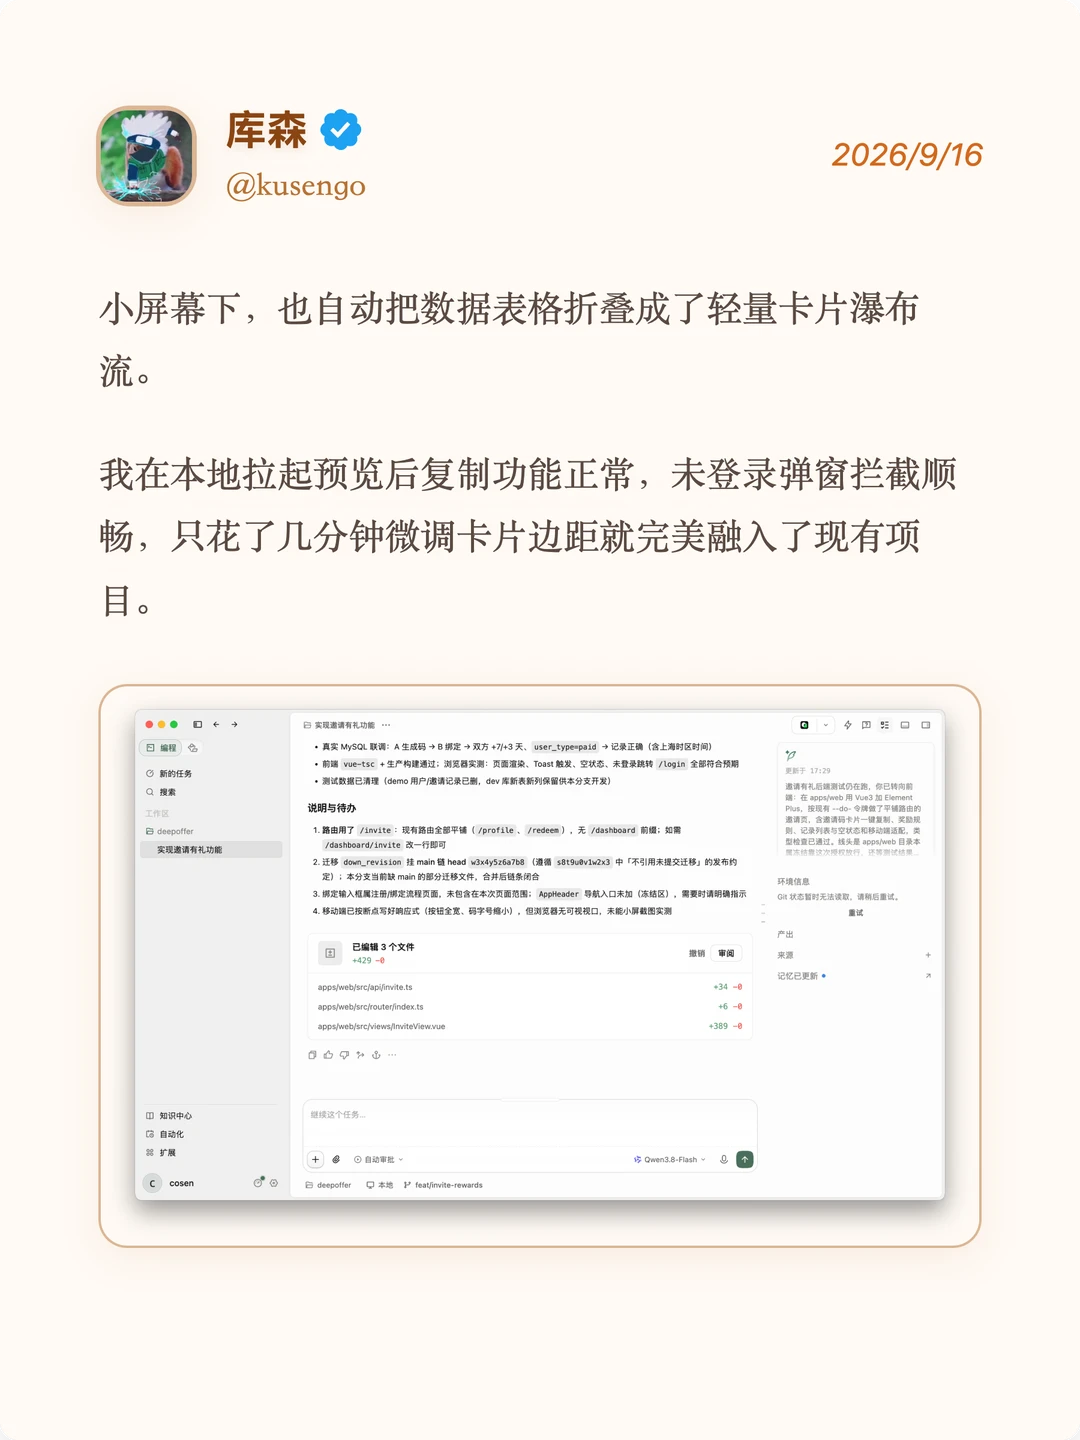
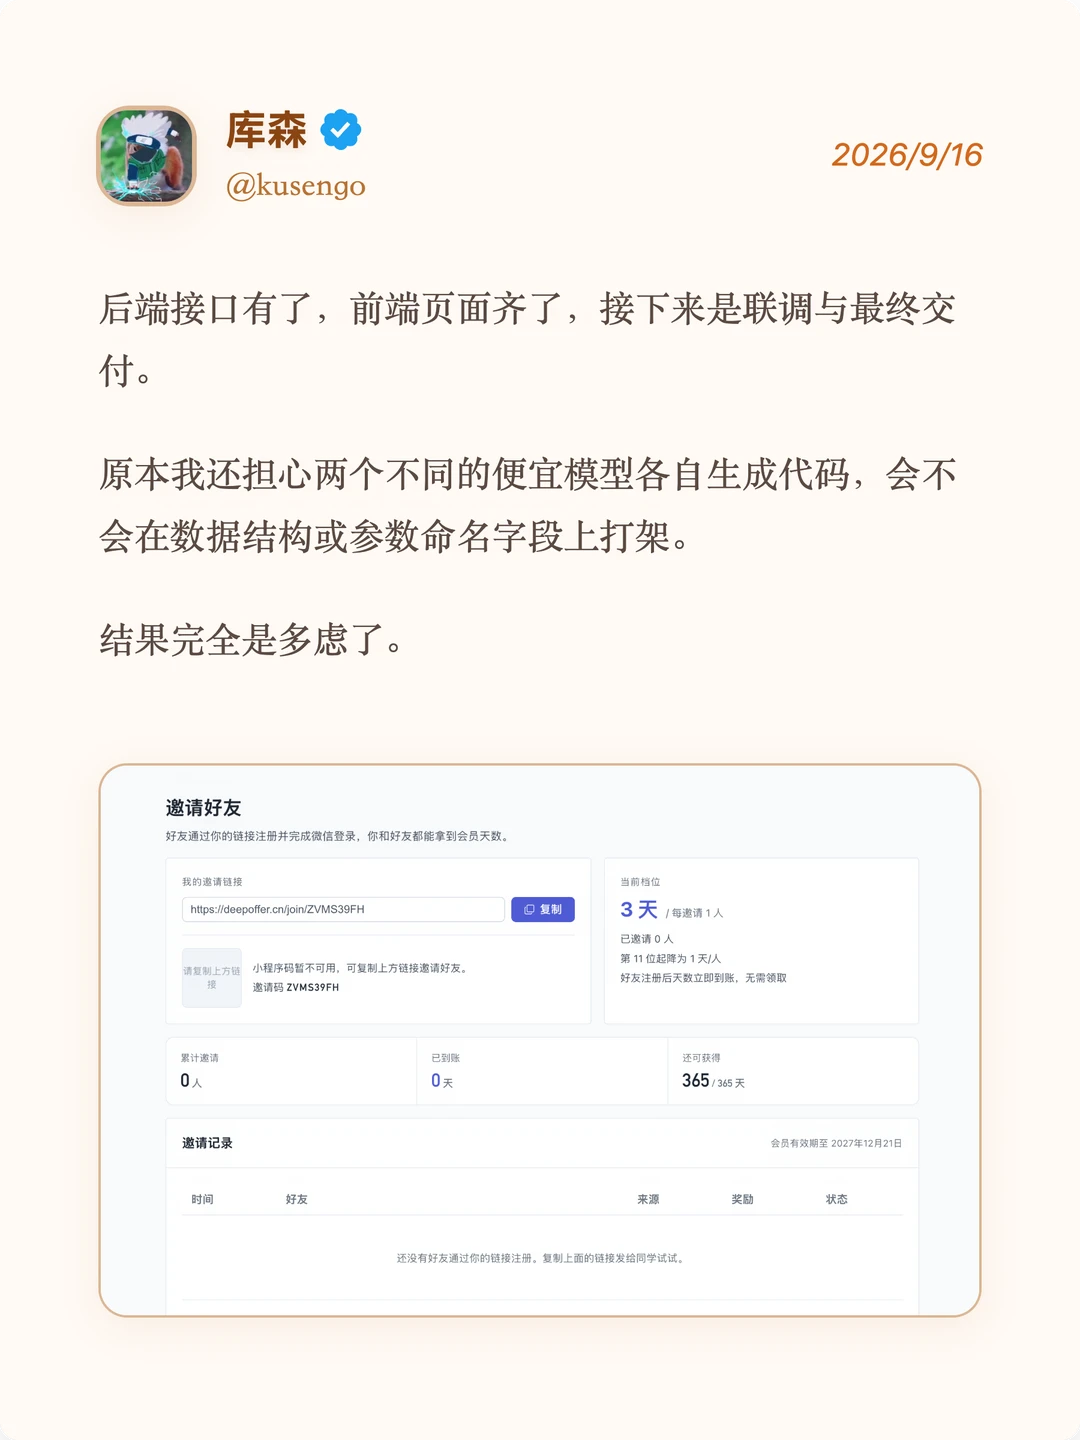
实测下来远超预期, GLM 写的表结构和事务逻辑非常严密, Qwen 准确复用了现有 Tailwind 变量和卡片组件,移动端自适应一步到位。 两个模型接口字段完全对齐,前后端联调一把过。
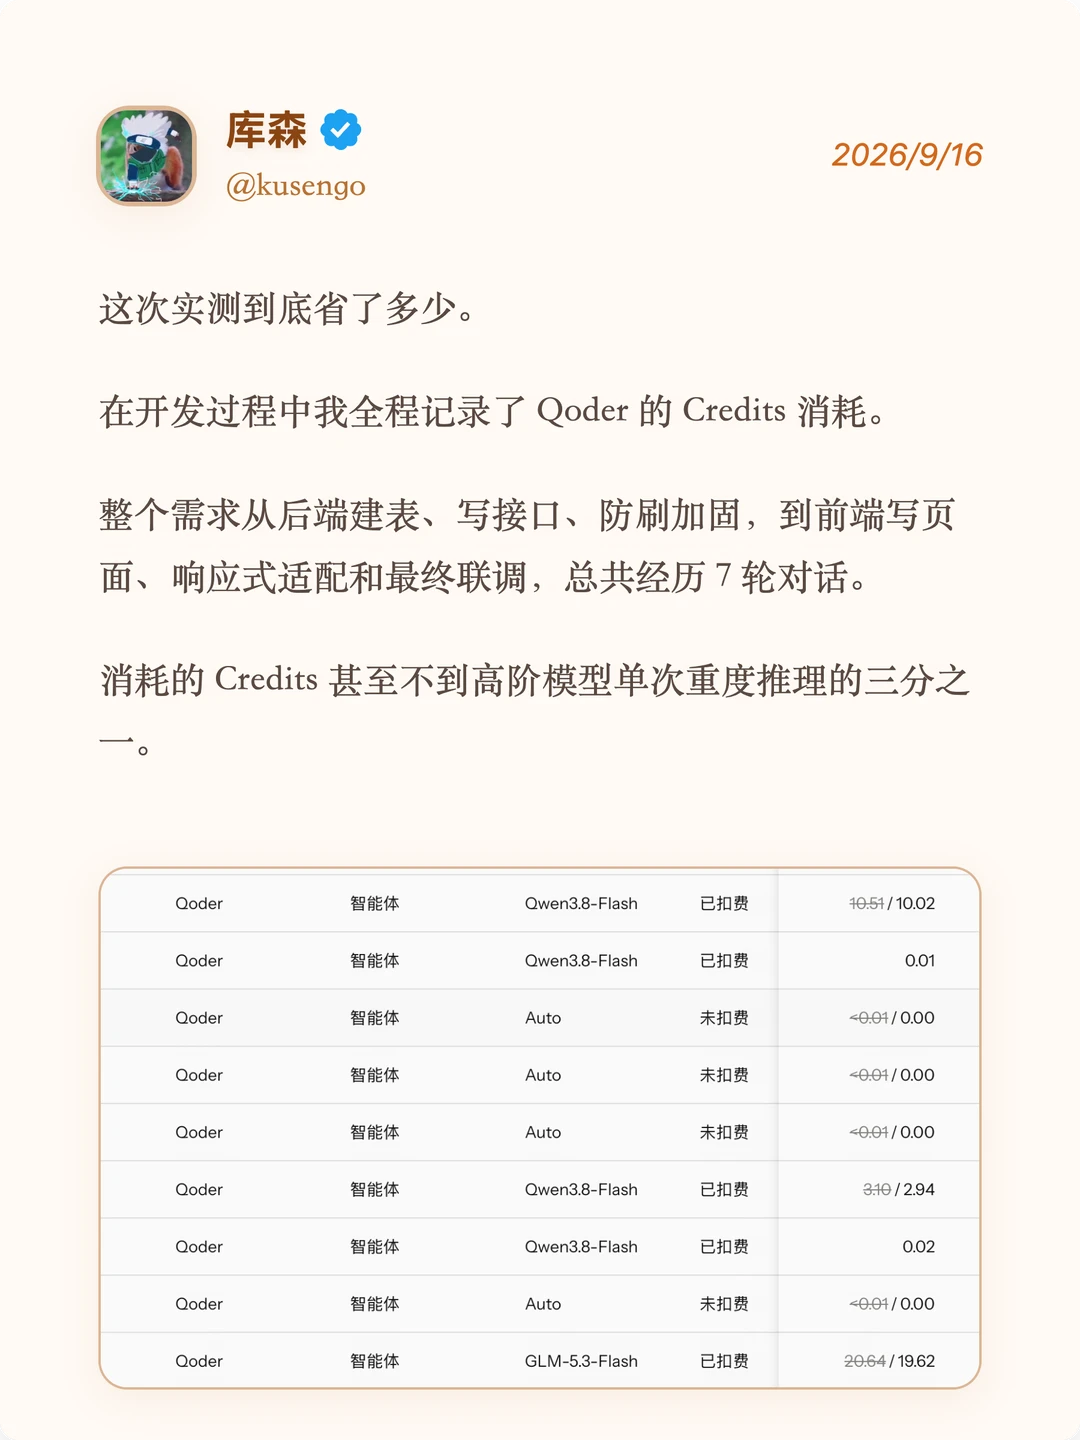
做完 3 个接口、1 个定时任务和前端页面,总共 7 轮对话。 消耗甚至不到高阶模型单次重度推理的三分之一。
说白了,日常大部分工作就是常规增删改查、页面拼接和修 Bug。 在这些搬砖场景下,便宜模型的组合拳已经完全够用,真没必要每一步都上最贵的。 好钢用在刀刃上,把高阶额度留给复杂架构,才是划算的用法。
实测全过程、前后端生成细节和真实账单消耗,翻卡片看。
#AI编程 #Qoder #全栈开发 #程序员日常 #前端开发 #后端开发 #AI开发 #AI工具 #vibecoding #AI进化生活howto