机械躯壳的狂欢:中国具身智能正在经历一场“大脑空心化”
2026年,中国具身智能交出了一份令人眩晕的成绩单:上半年人形机器人出货量超4万台,全球占比升至97%;宇树科技与智元机器人合计拿下全球近75%的出货量。当智元宣布第15000台机器人下线,当宇树以609亿元市值登陆科创板,当优必选柳州工厂以每10分钟一台的节拍轰隆运转时,“全球领先”的叙事已经铺满了整个行业。
但拉开这台繁荣机器的外壳,里面装的是一颗尚未真正运转的“大脑”。
两成靠AI,八成靠人
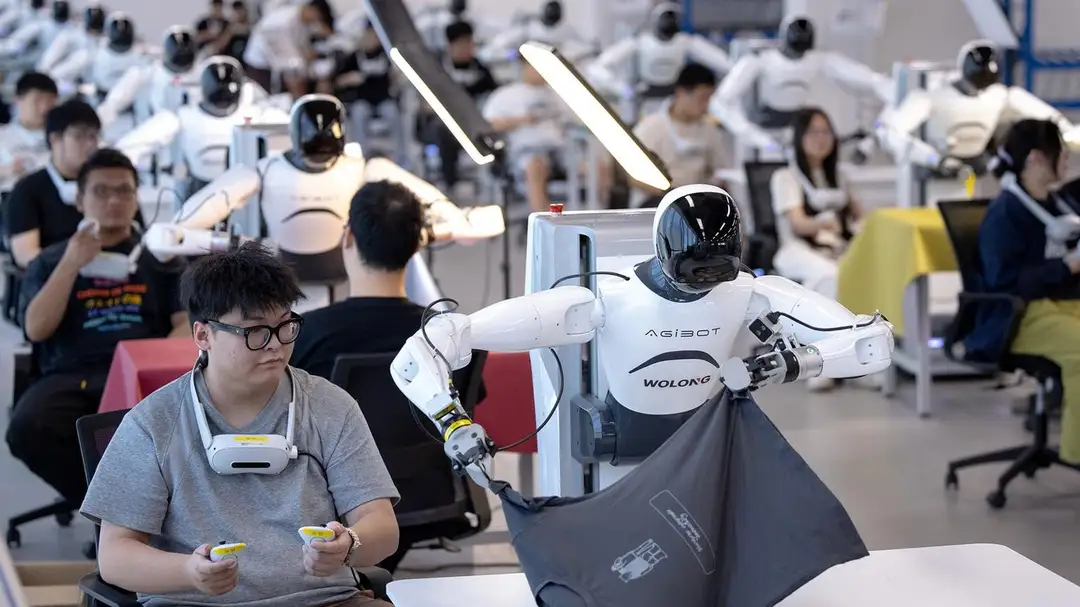
马斯克在2026年7月的一番话,戳穿了这个行业心照不宣的秘密:市面上90%的机器人精彩表演,根本不是自主智能完成的。要么是提前写死的固定程序,要么就是背后有人戴着VR设备全程远程操控。国内机器人赛事的情况更为直观:六成以上需要人工远程导航、人工辅助纠错,行内总结为“两成靠AI撑场面,八成靠人工来兜底”。
这不是“造假”,而是行业真实技术水平的反映。遥操作在现阶段是一种研发工具,是从人类数据中学习动作策略的必要手段。问题在于,当遥操作从“训练手段”变成“演示标配”时,行业就陷入了一个危险的舒适区:用人工操控掩盖AI能力的不足,用精心编排的演示替代真实场景的落地验证。一个需要人类在后台实时操控才能完成倒咖啡动作的机器人,和一个真正的自主智能体之间的距离,不是一代技术迭代能填平的。
数据饥荒:最稀缺的燃料
支撑自主AI的核心燃料是数据,而中国具身智能正面临一场严重的“数据饥荒”。贵州省大数据局2026年7月公布的数据显示,国内真实物理交互场景合规数据仅50万小时,而机器人商业化落地需要数千万小时,缺口超过99%。中国信通院的测算更为具体:具身基础模型要达到类似ChatGPT的时刻,至少需要千万小时级真实数据,而当前全球可用的高质量真实数据仅为数十万至百万小时级。
更棘手的是数据采集的成本与效率。传统遥操作数据采集的单条有效数据成本约10至50元,训练一个基本可用的操作策略通常需要数万到数十万条数据。遥操作单台设备投入超过20万元,单小时有效数据成本仍在500元以上。这意味着,企业即便愿意花钱,也很难在短时间内积累出足以训练出自主决策能力的海量数据。
雪上加霜的是“数据孤岛”。企业各自采集的工况数据彼此隔离,设备故障、极端环境等稀缺样本难以共享,实验室训练的模型在真实环境中误差偏大。京东两年采购1000万小时数据的目标固然雄心勃勃,但采购来的数据能否与自研模型有效适配,仍是未知数。
算力短板:数十张显卡与千亿参数之间的鸿沟
数据之外,算力是另一道更深的鸿沟。摩尔线程CEO张建中在2026世界机器人大会上的发言直指要害:当前国内多数具身智能模型参数量与早期千亿级语言模型相比仍存在量级差距,不少模型训练仅依靠数十张甚至更少的显卡完成。他判断,下一代面向视觉与具身智能的世界模型,其“GPT时刻”大概率会诞生在千卡乃至万卡规模以上的算力集群之上。
而现状是,国内具身智能企业普遍还在数十张显卡的规模上做训练。更严峻的是,用于模型推理的高阶算力芯片仍较依赖英伟达等海外供应商,存在供应受制于人的风险。虽然沐曦与优必选已合资成立芯片公司,试图打通“自研芯片+整机”的纵向一体化路径,但从合资到量产再到性能追平,中间还有漫长的时间窗口。
算力短板与数据饥荒相互叠加,形成了一个恶性循环:没有足够的数据,模型训练效果差;没有足够的算力,数据处理和模型迭代速度慢;迭代速度慢,就更难积累出高质量的真实场景数据。
内卷在壳,贫瘠在脑
与AI和算力层面的贫瘠形成鲜明对比的,是硬件外壳的极度繁荣与内卷。中国信通院数据显示,人形机器人核心零部件整体国产化率已突破75%,部分环节超过90%。谐波减速器单价从3000至5000元降至1500至2000元,行星滚柱丝杠降幅超过80%,六维力传感器从万元级降至5000元以内。宇树的人形机器人单价从2023年的59.34万元降至2025年的16.64万元,两年缩水约72%。
供应链的成熟和价格的下降是真实的成就,但问题在于,当硬件的门槛被迅速抹平,竞争就变成了一场没有差异化壁垒的价格战。超过六成的具身智能机器人仍流向文娱商演、科研教育和数据采集,真正进入智能制造、仓储物流等生产环节的不足两成。这意味着,大量的产能被消耗在了“表演”而非“干活”上。
与此同时,真正决定机器人能否“自主干活”的核心能力——长程记忆与动态决策、精细化灵巧操作、自主纠错与重规划——仍然处于早期阶段。逆矩阵创始人陈博远以GPT-6操控夹爪拿杯子耗时近一小时为例指出,语言模型逐词元生成的推理模式在真机上“就是三个控制周期出去了”,物理AI必须有自己的基座模型。而在这一方向上,OpenAI的GPT-6 Astra已经在机器人操控任务中展现出泛化突破