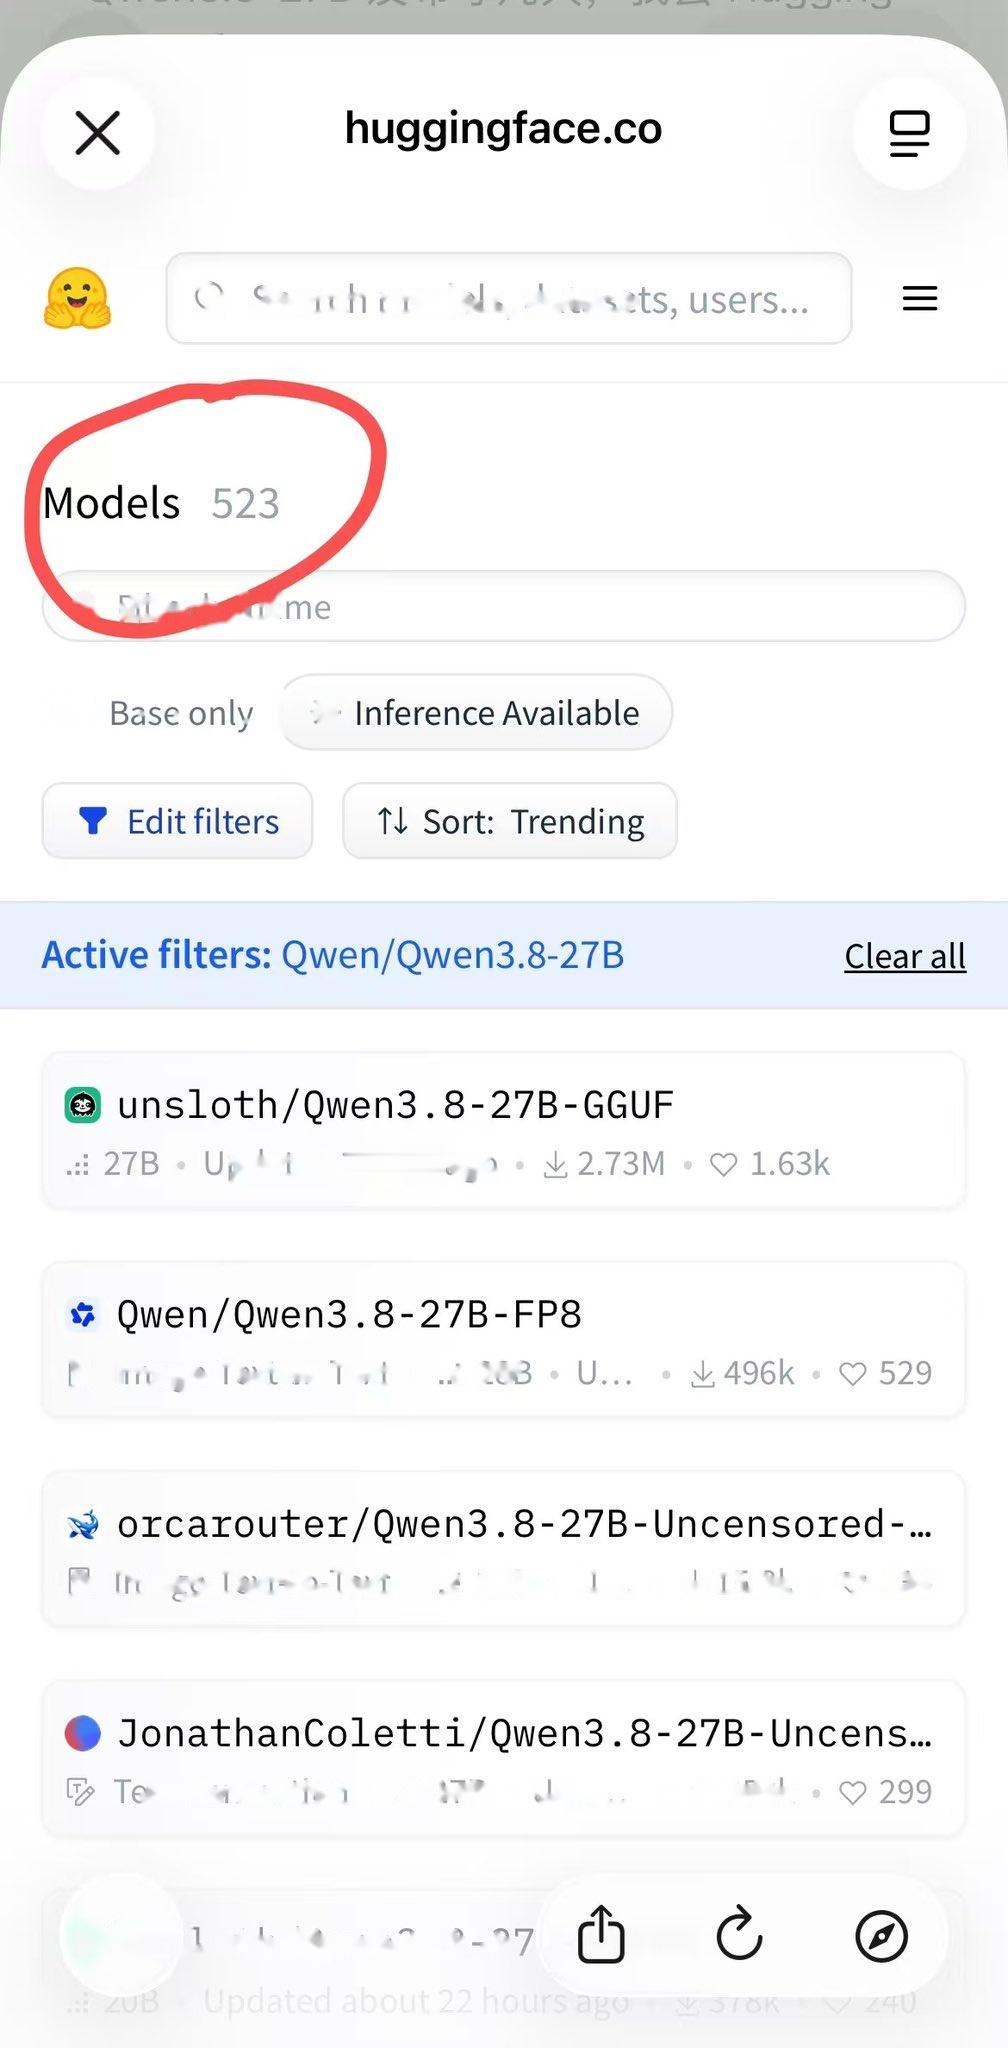
Qwen3.8-27B 发布才几天,我又Hugging Face 看了一眼。
有点离谱。
已经冒出了 500+ 量化版、100+ 微调版。
你肯定好奇,这帮人为啥乐此不疲?
简单说,这帮人在干 10 件事:
原版:Qwen 官方,27B Dense。
量化:FP8、INT4、NVFP4,把模型压小,让消费卡跑得动。
GGUF:给 llama.cpp / LM Studio 用,本地部署最常见的格式。
Mac🍎:MLX 社区负责 Apple Silicon。
NVIDIA:NVFP4、5090 等专属优化,继续榨速度。
AMD:连 AMD 都亲自下场做 Quark / MXFP4 了 😂😂😂
Serving:SGLang、vLLM,解决高并发、KV Cache、多卡和吞吐。
配方:同一个模型,DGX Spark + NVFP4 + SGLang,参数不同速度都能差很多。
微调 / 蒸馏:Coding、Reasoning、Opus/Fable Distill,把通才改成专才。
越狱:Uncensored、Abliterated、Heretic,让模型干一切
🔥为什么这么多人免费干?
抢开发者流量
抢生态标准
给自己的硬件 / 软件引流
赚开源声望
Qwen 发布了一个 27B,几天后社区自己长出了几百个版本。
🔥如果你看完这些名词还是不知道怎么真正跑起来,推荐下面这篇开源大模型从零开始部署实战。
作者选择了 Qwen dense和 Ling-3-flash moe 模型,从选量化、装环境,到把模型真正 Serve 起来,基本把上面这些东西串成了一条完整路径。对于 Dense 跟 MoE 也进行了对比测试和详细说明。
非常适合入门阅读