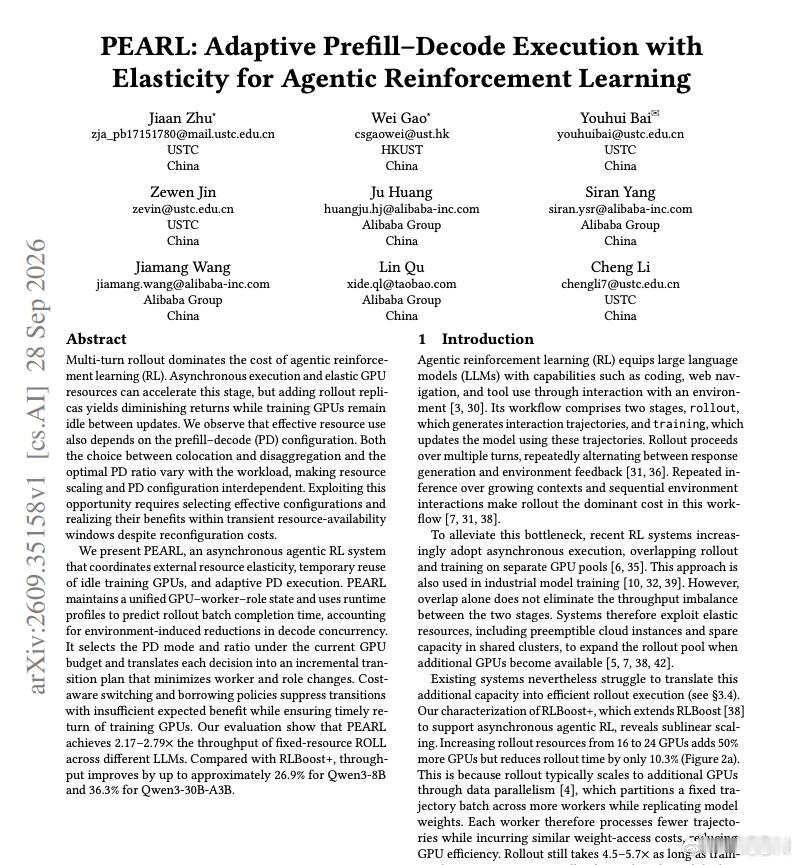
给Agentic RL的Rollout多加50% GPU,耗时却只降低10.3%。中国科学技术大学特任副研究员白有辉参与的最新论文PEARL发现:Agent训练的瓶颈不只是GPU数量,还来自多轮交互中的Prefill–Decode干扰、模型权重访问和不断变化的资源供给。论文:网页链接PEARL把三件事放进同一个系统:• 弹性接入抢占式GPU• 临时复用空闲训练GPU• 动态选择PD共置/分离及P/D比例因为PD分离并非总是更快:BS32时领先9.7%,到BS96时,共置反而领先6.1%。最优配置必须随负载和GPU预算变化。在最多32张H800、Qwen3-8B与Qwen3-30B-A3B的实验中,PEARL相比使用相同弹性资源的RLBoost+,吞吐最高提升36.3%。11月20—21日,论文作者之一白有辉将出席2026 C++及系统软件技术大会,分享国产超节点上的稀疏注意力与KVCache管理实践。📍北京万达文华酒店KVCacheAgenticRLAIInfra